> For the complete documentation index, see [llms.txt](https://docs.tibero.com/tibero-manuals/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.tibero.com/tibero-manuals/7.2.6.manuals/sql-reference-guide/functions/analytic-functions.md).

# 분석 함수

분석 함수는 집단 함수와 마찬가지로 특정 로우 그룹에 대한 집계 값을 구할 때 사용합니다.

집단 함수와 다른 점은 하나의 로우 그룹에 속한 모든 로우가 하나의 집계 값을 공유하지 않는다는 점입니다. 각 로우마다 별도의 로우 그룹이 정의되므로, 모든 로우는 자신에게 해당하는 로우 그룹의 집계 값을 가집니다. 분석 함수에서는 이 로우 그룹을 윈도우라고 하며, `analytic_clause` 안에 정의합니다. 윈도우 영역은 물리적인 로우 개수로 정의할 수도 있고, 논리적인 계산 값으로 정의할 수도 있습니다.

하나의 쿼리 블록 안에서 분석 함수는 `ORDER BY` 절을 제외하고 가장 마지막에 수행됩니다. `WHERE` 절, `GROUP BY` 절, `HAVING` 절은 분석 함수가 수행되기 전에 먼저 적용됩니다. 따라서 분석 함수는 `SELECT` 절 또는 `ORDER BY` 절에만 올 수 있습니다.

#### **analytic\_function**

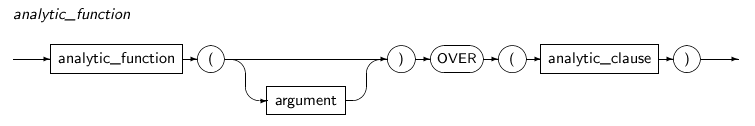
분석 함수는 크게 `analytic_function`, `argument`, `analytic_clause`로 구성됩니다.

`analytic_function`의 세부 내용은 다음과 같습니다.

**문법**

<div align="left"><figure><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/lcQXWzE6rjbbbe1X8Htu/analytic_function.png" alt=""><figcaption></figcaption></figure></div>

**구성요소**

* `analytic_function`
  * 분석 함수의 이름
* `argument`
  * 분석 함수의 파라미터
  * 함수에 따라 파라미터 타입 결정
* `OVER analytic_clause`
  * `OVER analytic_clause`를 사용해 함수를 분석 함수로 수행

#### **analytic\_clause**

`OVER analytic_clause`를 사용하면 함수를 분석 함수로 수행할 수 있습니다. 분석 함수는 `ORDER BY` 절을 제외한 다른 모든 절이 처리된 다음에 적용됩니다. 따라서 분석 함수가 계산한 결과의 일부만 선택하려면, 분석 함수를 수행한 쿼리를 뷰로 둘러싸고 그 바깥쪽 뷰에 `WHERE` 절을 적용하면 됩니다. `analytic_clause` 안에는 분석 함수를 사용할 수 없습니다. 다만 부질의 안에서 분석 함수를 사용하는 것은 가능합니다.

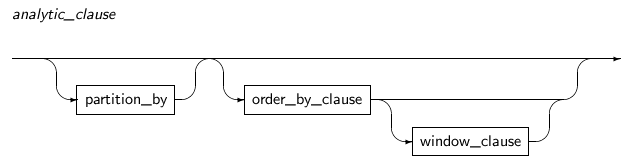
`analytic_clause`의 세부 내용은 다음과 같습니다.

**문법**

<div align="left"><figure><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/GPOhzFvtjxqJwZCt3dR0/analytic_clause.png" alt=""><figcaption></figcaption></figure></div>

**구성요소**

* `partition_by`
  * 분석 함수를 계산하기 전에 현재 질의 블록의 결과 집합 분할
* `order_by_clause`
  * `partition_by`에 의해 분할된 하나의 파티션 안에서 로우 정렬 방식 지정
* `window_clause`
  * 필요한 경우에만 사용
  * 분석 함수의 `order_by_clause`를 명시한 경우에만 지정 가능

#### **partition\_by**

분석 함수를 계산하기 전에 현재 질의 블록의 결과 집합을 `expr` 또는 `expr` 리스트를 기준으로 분할합니다. 이 절을 명시하지 않으면 분석 함수의 윈도우는 전체 로우 집합 안에서 움직입니다.

하나의 질의 블록의 `SELECT` 절 또는 `ORDER BY` 절에는 여러 개의 분석 함수를 명시할 수 있으며, 각각 서로 다른 `PARTITION BY` 키를 가질 수도 있습니다.

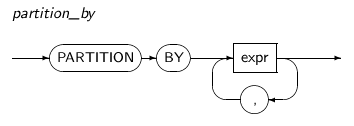
`partition_by`의 세부 내용은 다음과 같습니다.

**문법**

<div align="left"><figure><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/pDPQC0lWnMaC0b9rwhGj/partition_by.png" alt=""><figcaption></figcaption></figure></div>

**구성요소**

* `expr`
  * 상수, 컬럼, 분석 함수가 아닌 함수로 구성된 연산식

#### **order\_by\_clause**

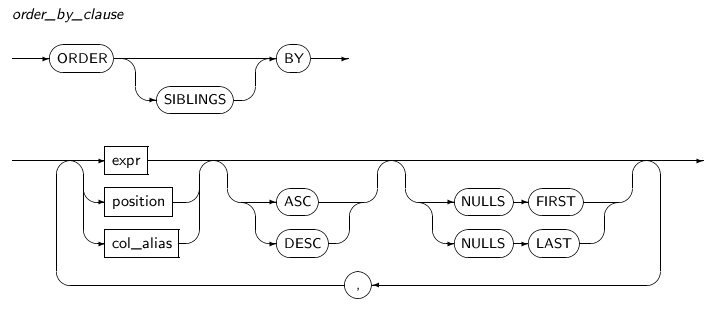
`partition_by`에 의해 분할된 하나의 파티션 안에서 로우를 어떻게 정렬할지 명시합니다. 정렬에 사용할 키 값은 여러 개를 지정할 수 있습니다.

분석 함수에서 사용하는 `order_by_clause` 안에서는 위치 상수(`ORDER BY 1`과 같은 형태)를 사용할 수 없습니다. `SIBLINGS`도 사용할 수 없습니다. `SELECT` 리스트 컬럼의 별칭도 사용할 수 없습니다. 그 밖의 사용 방식은 일반 `ORDER BY` 절과 같습니다.

분석 함수에 사용한 `order_by_clause`는 파티션 안의 로우 순서만 결정합니다. 분석 함수를 적용한 쿼리 블록의 최종 결과 집합 순서를 결정하지는 않습니다. 최종 결과 집합 순서를 지정하려면 쿼리 블록에 별도의 `ORDER BY` 절을 추가해야 합니다.

`order_by_clause`의 세부 내용은 다음과 같습니다.

**문법**

<div align="left"><figure><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/GiKA3nIKBV4mUrt36qfF/order_by_clause.png" alt=""><figcaption></figcaption></figure></div>

**구성요소**

* `SIBLINGS`
  * 계층 질의의 형제 노드 안에서 정렬 순서 정의
  * 분석 함수에서는 사용 불가
* `expr`
  * 정렬 키로 사용하는 연산식
* `position`
  * `select_list`에 명시된 `expr`의 위치 지정
  * 분석 함수에서는 사용 불가
* `ASC`
  * 정렬 순서 지정
  * 오름차순 정렬, 디폴트 값
* `DESC`
  * 정렬 순서 지정
  * 내림차순 정렬
* `NULLS FIRST`
  * NULL 값의 정렬 순서 지정
  * 오름차순 정렬의 디폴트 값
* `NULLS LAST`
  * NULL 값의 정렬 순서 지정
  * 내림차순 정렬의 디폴트 값

#### **window\_clause**

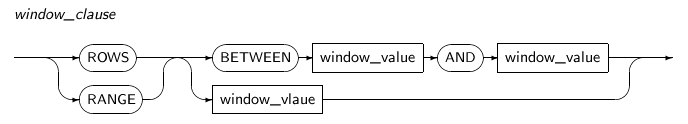
분석 함수에 따라 `window_clause`를 가질 수 있는 경우가 있습니다. 분석 함수의 `order_by_clause`를 명시한 경우에만 `window_clause`를 명시할 수 있습니다. `window_clause`를 명시하지 않았을 때는 필요한 경우 디폴트 윈도우로 `RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW`가 지정됩니다.

`window_clause`의 세부 내용은 다음과 같습니다.

**문법**

<div align="left"><figure><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/jRQFjpXb5P2c0s9sLWNF/window_clause.png" alt=""><figcaption></figcaption></figure></div>

**구성요소**

* `ROWS`
  * 현재 로우를 기준으로 물리적인 로우 단위의 윈도우 계산
  * `order_by_clause`를 기준으로 동률이 생기면 상이한 결과가 나올 수 있음
* `RANGE`
  * 현재 로우를 기준으로 논리적 오프셋에 따라 윈도우 정의
  * `ROWS`와 달리 같은 정렬 값을 가지는 로우는 같은 결과 반환
  * `order_by_clause`에는 하나의 정렬 키만 명시 가능
* `BETWEEN ... AND`
  * 윈도우의 시작점과 끝점 명시
  * `BETWEEN` 뒤는 시작점, `AND` 뒤는 끝점
  * 경계값을 하나만 명시하면 끝점은 `CURRENT ROW`

다음 표는 Tibero에서 제공하는 분석 함수와 함수별 `window_clause`의 명시 가능 여부를 나타냅니다.

<table><thead><tr><th width="300">분석 함수</th><th>window_clause 명시 가능 여부</th></tr></thead><tbody><tr><td>AVG</td><td>예</td></tr><tr><td>CORR</td><td>예</td></tr><tr><td>COUNT</td><td>예</td></tr><tr><td>COVAR_POP</td><td>예</td></tr><tr><td>COVAR_SAMP</td><td>예</td></tr><tr><td>DENSE_RANK</td><td>아니오</td></tr><tr><td>FIRST</td><td>아니오</td></tr><tr><td>FIRST_VALUE</td><td>예</td></tr><tr><td>LAG</td><td>아니오</td></tr><tr><td>LAST</td><td>아니오</td></tr><tr><td>LAST_VALUE</td><td>예</td></tr><tr><td>LEAD</td><td>아니오</td></tr><tr><td>MAX</td><td>예</td></tr><tr><td>MIN</td><td>예</td></tr><tr><td>NTILE</td><td>아니오</td></tr><tr><td>PERCENT_RANK</td><td>아니오</td></tr><tr><td>PERCENTILE_CONT</td><td>아니오</td></tr><tr><td>PERCENTILE_DISC</td><td>아니오</td></tr><tr><td>RANK</td><td>아니오</td></tr><tr><td>RATIO_TO_REPORT</td><td>아니오</td></tr><tr><td>REGR_SLOPE REGR_INTERCEPT REGR_COUNT<br>REGR_R2<br>REGR_AVGX REGR_AVGY<br>REGR_SXX<br>REGR_SYY<br>REGR_SXY</td><td>예</td></tr><tr><td>ROW_NUMBER</td><td>아니오</td></tr><tr><td>STDDEV</td><td>예</td></tr><tr><td>STDDEV_POP</td><td>예</td></tr><tr><td>STDDEV_SAMP</td><td>예</td></tr><tr><td>SUM</td><td>예</td></tr><tr><td>VARIANCE</td><td>예</td></tr><tr><td>VAR_POP</td><td>예</td></tr><tr><td>VAR_SAMP</td><td>예</td></tr></tbody></table>

#### **window\_value**

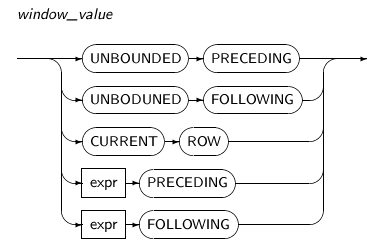
`window_value`의 세부 내용은 다음과 같습니다.

**문법**

<div align="left"><figure><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/wAn8UTalco402zMs1XV7/window_value.png" alt=""><figcaption></figcaption></figure></div>

**구성요소**

* `UNBOUNDED PRECEDING`
  * 시작점 지정
  * 파티션의 첫 번째 로우 의미
  * 끝점으로는 사용 불가
* `UNBOUNDED FOLLOWING`
  * 끝점 지정
  * 파티션의 마지막 로우 의미
  * 시작점으로는 사용 불가
* `CURRENT ROW`
  * 시작점 또는 끝점으로 사용 가능
  * `ROWS` 또는 `RANGE`를 명시했을 때 현재 로우 또는 현재 로우에서 계산한 값 의미
  * 시작점으로 명시하면 끝점으로 `expr PRECEDING` 사용 불가
  * 끝점으로 명시하면 시작점으로 `expr FOLLOWING` 사용 불가
* `expr PRECEDING`
  * 현재 로우보다 앞선 위치 지정
  * 끝점에 명시했으면 시작점도 항상 `expr PRECEDING`이어야 함
* `expr FOLLOWING`
  * 현재 로우보다 뒤의 위치 지정
  * 시작점에 명시했으면 끝점도 항상 `expr FOLLOWING`이어야 함

윈도우 타입별로 `expr`의 의미는 다음과 같습니다.

**윈도우 타입이 `ROWS`일 경우**

* `expr`은 물리적인 오프셋을 지정합니다. 이것은 양수이거나 양수로 계산되는 연산식입니다.
* 시작점의 로우는 끝점의 로우보다 먼저 나와야 합니다.

**윈도우 타입이 `RANGE`일 경우**

* `expr`은 논리적인 오프셋을 지정합니다. 이것은 0 또는 양수로 계산되는 연산식 또는 간격 리터럴입니다. 간격 리터럴은 “[리터럴](/tibero-manuals/7.2.6.manuals/sql-reference-guide/sql-elements/literals.md)”을 참고합니다.
* `expr`에 수치 값을 사용할 수 있는 경우는 `order_by_clause`의 `expr` 데이터 타입이 `NUMBER` 또는 `DATE` 타입일 때입니다.
* `expr`에 간격 값을 사용할 수 있는 경우는 `order_by_clause`의 `expr` 데이터 타입이 `DATE` 타입일 때입니다.