> For the complete documentation index, see [llms.txt](https://docs.tibero.com/tibero-manuals/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.tibero.com/tibero-manuals/7.2.6.manuals/administrator-guide/tibero-active-cluster.md).

# Tibero Active Cluster

Tibero Active Cluster의 기본 개념과 구성요소, 프로세스, 실행 및 운영 방법을 설명합니다.

## 개요

**Tibero Active Cluster**(이하 TAC)는 확장성, 고가용성을 목적으로 제공하는 Tibero의 주요 기능입니다. TAC 환경에서 실행 중인 모든 인스턴스는 공유된 데이터베이스를 통해 트랜잭션을 수행하며 공유된 데이터에 대한 접근은 데이터의 일관성과 정합성 유지를 위해 상호 통제하에 이뤄집니다.

큰 업무를 작은 업무의 단위로 나누어 여러 노드 사이에 분산하여 수행할 수 있기 때문에 업무 처리 시간을 단축할 수 있습니다.

여러 시스템이 공유 디스크를 기반으로 데이터 파일을 공유합니다. TAC 구성에 필요한 데이터 블록은 노드 간을 연결하는 고속 사설망을 통해 주고받음으로써 노드가 하나의 공유 캐시(shared cache)를 사용하는 것처럼 동작합니다. 운영 중에 한 노드가 멈추더라도 동작 중인 다른 노드들이 서비스를 지속하게 됩니다. 이러한 과정은 투명하고 신속하게 처리됩니다.

## 구성 요소

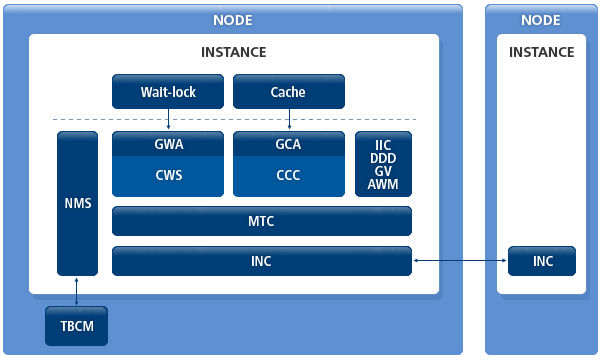
다음은 TAC 구조를 나타내는 그림입니다.

**\[그림 1] TAC의 구조**

<div align="left"><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/7BN9WVHYFGGi45LdsMAu/tac_arch.png" alt=""></div>

TAC의 구조는 다음과 같은 모듈로 구성되어 있습니다.

CWS(Cluster Wait-lock Service)

* 기존 Wait-lock(이하 Wlock)이 클러스터 내에서 동작할 수 있도록 구현된 모듈입니다. Distributed Lock Manager(이하 DLM)이 내장되어 있습니다.
* Wlock은 GWA를 통해 CWS에 접근할 수 있으며, 관련 배경 스레드로 WATH, WLGC, WRCF이 있습니다.

GWA(Global Wait-lock Adapter)

* Wlock은 CWS를 사용하기 위한 인터페이스 역할을 수행하는 모듈입니다.
* CWS에 접근하기 위한 핸들인 CWS Lock Status Block(이하 LKSB)과 파라미터를 설정하고 관리합니다.
* Wlock에서 사용하는 잠금 모드(Lock mode)와 타임아웃(timeout)을 CWS에 맞게 변환하며 CWS에서 사용할 Complete Asynchronous Trap(이하 CAST), Blocking Asynchronous Trap(이하 BAST)을 등록할 수 있습니다.

CCC(Cluster Cache Control)

* 데이터베이스의 데이터 블록에 대한 클러스터 내 접근을 통제하는 모듈입니다. DLM이 내장되어 있습니다.
* CR Block Server, Current Block Server, Global Dirty Image, Global Write 서비스가 포함되어 있습니다.
* Cache layer에서는 GCA(Global Cache Adapter)를 통해 CCC에 접근할 수 있으며 이와 관련된 배경 스레드로 CATH, CLGC, CRCF이 존재합니다.

GCA(Global Cache Adapter)

* Cache layer에서 CCC 서비스를 사용하기 위한 인터페이스 역할을 수행하는 모듈입니다.
* CCC에 접근하기 위한 핸들인 CCC LKSB와 파라미터를 설정하고 관리하며 Cache layer에서 사용하는 block lock mode를 CCC에 맞게 변환합니다.
* CCC의 lock-down event에 맞춰 데이터 블록이나 Redo 로그를 디스크에 저장하는 기능과 DBWR가 Global write를 요청하거나 CCC에서 DBWR에게 block write를 요구하는 인터페이스를 제공합니다.
* CCC에서는 GCA를 통해 CR block, Global dirty block, current block을 주고받습니다.

MTC(Message Transmission Control)

* 노드 간 통신 메시지의 손실과 out-of-order 문제를 해결하는 모듈입니다.
* 문제를 해결하기 위해 retransmission queue와 out-of-order message queue를 관리합니다.
* General Message Control(GMC)을 제공하여 CWS/CCC 이외의 모듈에서 노드 간의 통신이 안전하게 이루어지도록 보장합니다. 현재 Inter-instance call(IIC), Distributed Deadlock Detection(이하 DDD), Automatic Workload Management에서 노드 간의 통신을 위해 GMC를 사용하고 있습니다.

INC(Inter-Node Communication)

* 노드 간의 네트워크 연결을 담당하는 모듈입니다.
* INC를 사용하는 사용자에게 네트워크 토폴로지(network topology)와 프로토콜을 투명하게 제공하며 TCP, UDP 등의 프로토콜을 관리합니다.

NMS(Node Membership Service)

* TBCM으로부터 전달받은 정보(node ID, IP address, port, incarnation number)와 node workload를 나타내는 가중치(weight)를 관리하는 모듈입니다.
* node 멤버십의 조회, 추가, 삭제 기능을 제공하며 이와 관련된 배경 스레드로 NMGR이 있습니다.

## 프로세스

TAC는 1개의 프로세스(ACSD, Active Cluster Service Daemon)가 추가로 생성됩니다. 이 프로세스는 ACCT, NMGR, DIAG, WRCF, CRCF, WLGC, CLGC, WATH, CATH, CMPT 스레드(thread)로 구성되며, 각 스레드는 다음과 같은 그룹에 각각 포함됩니다.

* **Active Cluster Control Thread**

<table><thead><tr><th width="106">스레드</th><th>설명</th></tr></thead><tbody><tr><td>ACCT</td><td><ul><li>ACCT는 클러스터 간 메시지 통신을 담당하는 스레드임</li><li>클러스터 내 원격 노드로부터 CWS/CCC의 lock operation과 reconfiguration 요청(request)을 받아 CMPT에게 전달하거나, 로컬 노드 세션에서 전송할 메시지를 받아 원격 노드로 전송함</li><li>또한 ACSD 프로세스의 메인 스레드로서 나머지 스레드를 감독함</li></ul></td></tr></tbody></table>

* **Diagnostic Thread**

<table><thead><tr><th width="121">스레드</th><th>설명</th></tr></thead><tbody><tr><td>DIAG</td><td>DIAG는 클러스터 간 요청을 주고받을 때 hang이 발생하면, 이상 여부를 추후에 확인하는 데 필요한 정보를 자동으로 덤프(dump)하는 스레</td></tr></tbody></table>

* **Cluster Message Processor(Message handler)**

<table><thead><tr><th width="129">스레드</th><th>설명</th></tr></thead><tbody><tr><td>CMPT</td><td><p>CMPT는 다른 노드에서 보낸 메시지 요청을 처리하는 스레드</p><p><br>CMPT 스레드는 ACF_CMPT_CNT 초기화 파라미터에 설정된 값만큼 공통 풀(pool)로 생성됨</p><p><br>CMPT는 ACCT로부터 메시지를 받아 주로 다음 작업을 수행함</p><ul><li>CR block request를 받아 주어진 스냅샷(snapshot)에 해당하는 CR block을 생성하고 요청자에게 전송함</li><li>Current block request를 받으면 local block cache에 존재하는 Current block을 읽어 요청자에게 전송함</li><li>Global write request를 받아 주어진 데이터 블록이 dirty이면 BLKW가 이를 디스크에 기록하도록 지시함</li><li>MTC IIC request를 받아 처리함</li><li>MLD(Master Lookup Directory) lookup/remove request를 받아 처리함</li></ul></td></tr></tbody></table>

* **Asynchronous Thread**

<table><thead><tr><th width="143">스레드</th><th>설명</th></tr></thead><tbody><tr><td>WATH, CATH</td><td><p>CWS/CCC에서 세션을 담당하는 워킹 스레드가 처리해야 할 비동기 업무를 대신 수행하는 스레드<br><br>WATH, CATH 스레드는 다음과 같은 특징이 있음</p><ul><li>BAST를 받거나 스스로 잠금을 설정할 때 캐시된 lock mode를 downgrade하기 전에 BLKW의 disk write notification 또는 LOGW의 log flush를 기다린 후, master에게 lock downgrade를 통보함. 이 기능은 CATH 스레드만 수행할 수 있음</li><li>BLKW가 master로부터 받은 global write request 처리를 완료한 후 CATH에게 통보함</li><li>또한 master에게 write done notify를 보냄. 이 기능은 CATH 스레드만 수행할 수 있음</li><li>shadow resource block을 reclaim하기 전에 master에게 MC lock 제거를 요청함</li><li>요청을 보낸 후 응답을 받아 처리함</li></ul></td></tr></tbody></table>

* **Garbage Collector**

<table><thead><tr><th width="158">스레드</th><th>설명</th></tr></thead><tbody><tr><td>WLGC, CLGC</td><td><p>주기적으로 lock resource를 관리하고 타임아웃을 확인하는 스레드<br><br>WLGC, CLGC 스레드는 다음과 같은 특징이 있음</p><ul><li>DDD(Distributed Deadlock Detection)를 수행하기 위해 주기적으로 타임아웃이 발생한 lock waiter를 확인함. 교착 상태가 발생하면 DDD를 시작함</li><li>MTC retransmission queue에 설정된 메시지를 주기적으로 검사하여 타임아웃이 발생한 메시지를 다시 전송함</li><li>주기적으로 TSN을 동기화함. 이 기능은 WLGC 스레드만 수행할 수 있음</li><li>lock resource를 위한 공유 메모리가 부족해지면 resource block reclaiming을 시작하여 필요한 리소스를 확보함</li></ul></td></tr></tbody></table>

* **Reconfigurator**

<table><thead><tr><th width="161">스레드</th><th>설명</th></tr></thead><tbody><tr><td>WRCF, CRCF</td><td>NMGR 스레드로부터 node join 및 leave event를 받아 CWS/CCC lock remastering/reconfiguration을 수행함</td></tr></tbody></table>

* **Node Manager**

<table><thead><tr><th width="174">스레드</th><th>설명</th></tr></thead><tbody><tr><td>NMGR</td><td><ul><li>TBCM과 통신하여 node join 및 leave event를 받아 처리하며 node 멤버십을 관리함</li><li>또한 WRCF, CRCF 스레드에서 수행하는 CWS/CCC reconfiguration을 통제함(suspend 또는 resume)</li></ul></td></tr></tbody></table>

## **TAC** 환경 설정

TAC는 기본적으로 싱글 인스턴스일 때의 설정은 그대로 사용합니다. 이 외에는 추가로 설정해야 할 초기화 파라미터와 주의 사항이 있습니다.

다음은 TAC를 사용하기 위해 추가로 설정해야 하거나 주의해야 하는 초기화 파라미터의 예입니다.

<<$TB\_SID.tip>>

```
MEMORY_TARGET=6144M
TOTAL_SHM_SIZE=4096M
DB_CACHE_SIZE=2048M
CLUSTER_DATABASE=Y
THREAD=0
UNDO_TABLESPACE=UNDO0
LOCAL_CLUSTER_ADDR=192.168.1.1
LOCAL_CLUSTER_PORT=12345
CM_PORT=30000
```

<table><thead><tr><th width="238">초기화 파라미터</th><th>설명</th></tr></thead><tbody><tr><td>MEMORY_TARGET</td><td><ul><li>인스턴스가 사용할 전체 메모리의 크기를 설정</li><li>공유 메모리, 정렬 및 해시 등의 메모리를 요구하는 연산에서 사용하는 메모리, DBMS 내부에서 사용되는 기타 메모리를 모두 포함</li><li>공유 메모리는 DBMS의 부팅과 동시에 점유하며 나머지 메모리는 필요에 따라 할당 및 해제를 반복</li></ul></td></tr><tr><td>TOTAL_SHM_SIZE</td><td>인스턴스가 사용할 전체 공유 메모리의 크기를 설정</td></tr><tr><td>DB_CACHE_SIZE</td><td><ul><li>TAC는 버퍼 캐시 이외에도 사용하는 공유 메모리가 많음</li><li>따라서 버퍼 캐시의 크기를 싱글 인스턴스의 경우보다 더 작게 설정해야 함</li><li>일반적으로 전체 공유 메모리 크기의 절반 정도가 적절</li></ul></td></tr><tr><td>CLUSTER_DATABASE</td><td>TAC를 사용할 때 설정. 초기화 파라미터의 값은 반드시 <strong>'Y'</strong>로 설정해야 함</td></tr><tr><td>THREAD</td><td>Redo 스레드의 번호로 각 인스턴스마다 고유의 번호를 부여</td></tr><tr><td>UNDO_TABLESPACE</td><td>Undo 테이블 스페이스의 이름으로 각 인스턴스마다 고유하게 부여</td></tr><tr><td>LOCAL_CLUSTER_ADDR</td><td>TAC 인스턴스 간에 통신할 내부 IP 주소를 설정</td></tr><tr><td>LOCAL_CLUSTER_PORT</td><td><ul><li>TAC 인스턴스 간에 통신할 내부 포트 번호를 설정</li><li>이 포트는 노드 간에 열려 있어야 함</li></ul></td></tr><tr><td>CM_PORT</td><td><ul><li>인스턴스가 CM과 통신하기 위한 포트 번호를 설정</li><li>접속할 CM의 초기화 파라미터 중 CM_UI_PORT 파라미터와 동일하게 설정</li></ul></td></tr></tbody></table>

다음은 TAC를 설정할 때 주의해야 할 사항입니다.

* Redo 스레드의 번호와 Undo 테이블 스페이스의 이름은 동일한 데이터베이스를 서비스하는 서버 사이에서 유일해야 합니다. “TAC를 위한 데이터베이스 생성”에서 생성한 이름이어야 합니다.
* 모든 서버 인스턴스의 설정 파일에서 **CONTROL\_FILES**와 **DB\_CREATE\_FILE\_DEST**는 물리적으로 같은 파일 또는 같은 디바이스를 가리키도록 설정해야 합니다.

## **TAC**를 위한 데이터베이스 생성

TAC는 공유 디스크 기반의 클러스터 데이터베이스입니다. 여러 데이터베이스 서버의 인스턴스가 물리적으로 같은 데이터베이스 파일을 보고 사용하기 때문에 데이터베이스 생성은 한 서버에서 한 번만 수행하면 됩니다.

모든 서버의 인스턴스가 동일한 컨트롤 파일 및 데이터 파일을 읽고 쓰게 됩니다. 반면 TAC에서는 공유 디스크에서 데이터 접근의 경합을 최소화하기 위해 Redo 로그 및 Undo에 대해서는 인스턴스마다 별도의 파일을 가지고 있어야 합니다. Redo 로그 및 Undo 정보는 각 서버의 인스턴스들이 별도의 파일에 저장하지만 복구 상황 등에 따라 다른 인스턴스의 정보를 읽어야 하므로 반드시 공유 디스크상에 존재해야 합니다.

TAC를 위한 데이터베이스 생성 절차는 다음과 같습니다.

1. Tibero와 관련된 환경 설정 파일을 설정한 후 TBCM을 기동합니다. CM을 설정하고 기동하는 자세한 방법은 “[Tibero Cluster Manager](/tibero-manuals/7.2.6.manuals/administrator-guide/tibero-cluster-manager.md)”를 참고합니다.

   ```
   $ tbcm -b
   ```

TBCM을 기동했지만 Tibero를 직접 제어하지는 않습니다.

2. NOMOUNT 모드로 Tibero를 기동합니다.

   ```
   $ tbboot -t NOMOUNT -c
   ```
3. SYS 사용자로 접속한 후 CREATE DATABASE 문을 통해 데이터베이스를 생성합니다.

   ```
   [tibero@tester ~]$ tbsql sys/tibero

   SQL> CREATE DATABASE "ac"                     ... ① ...
           USER sys IDENTIFIED BY tibero
           MAXINSTANCES 8                       ... ② ...
           MAXDATAFILES 256
           CHARACTER SET MSWIN949
           LOGFILE GROUP 0 'log001' SIZE 50M,
                   GROUP 1 'log011' SIZE 50M,
                   GROUP 2 'log021' SIZE 50M
           MAXLOGFILES 100
           MAXLOGMEMBERS 8
           NOARCHIVELOG
           DATAFILE 'system001' SIZE 512M
                   AUTOEXTEND ON NEXT 8M MAXSIZE 3G
           DEFAULT TEMPORARY TABLESPACE TEMP
                   TEMPFILE 'temp001' SIZE 512M
                   AUTOEXTEND ON NEXT 8M MAXSIZE 3G
                   EXTENT MANAGEMENT LOCAL AUTOALLOCATE
           UNDO TABLESPACE UNDO0
                   DATAFILE 'undo001' SIZE 512M
                   AUTOEXTEND ON NEXT 8M MAXSIZE 3G
                   EXTENT MANAGEMENT LOCAL AUTOALLOCATE;

   Database created.
   ```

① DB\_NAME을 지정합니다.

② 접근할 서버의 최대 인스턴스의 개수를 8로 지정합니다.

기존의 CREATE DATABASE 문과 비교해 달라진 부분은 없습니다. 다만, 데이터베이스 파일을 공유할 인스턴스의 최대 개수를 나타내는 MAXINSTANCES 파라미터를 주의해야 합니다. 이 파라미터의 값은 컨트롤 파일과 데이터 파일의 헤더 등에 영향을 미치며 설정된 값 이상으로 Tibero의 인스턴스를 추가할 수 없으므로 TAC를 위해 데이터베이스를 생성할 때 충분한 값을 설정해야 합니다.

앞서 설명한 것처럼 각 서버의 인스턴스는 별도의 Redo 및 Undo 공간을 가져야 합니다. CREATE DATABASE 문을 실행할 때 생성된 Undo 테이블 스페이스 및 Redo 로그 파일은 첫 번째 인스턴스용입니다. 다른 인스턴스가 데이터베이스에 접근하려면 별도의 Redo 로그 그룹과 Undo 테이블 스페이스를 생성해야 합니다.

생성된 Redo 로그 그룹은 자동으로 0번의 Redo 스레드가 됩니다. 따라서 CREATE DATABASE 문을 실행하기 전에 서버 인스턴스의 환경 설정 파일($TB\_SID.tip)의 THREAD 초기화 파라미터와 UNDO\_TABLESPACE 초기화 파라미터는 다음과 같이 설정되어 있어야 합니다.

```
THREAD=0
UNDO_TABLESPACE=UNDO0
```

4. CREATE DATABASE 문을 실행하고 나면 Tibero가 자동으로 종료됩니다. Tibero를 다시 기동한 후 SYS 사용자로 접속하여 다음과 같이 Undo 테이블 스페이스와 새로운 Redo 로그 그룹을 만들고 DDL 문장을 수행합니다.

```
[tibero@tester ~]$ tbboot
[tibero@tester ~]$ tbsql sys/tibero

SQL> CREATE UNDO TABLESPACE UNDO01
        DATAFILE 'undo011' SIZE 512M
        AUTOEXTEND ON NEXT 8M MAXSIZE 3G
        EXTENT MANAGEMENT LOCAL AUTOALLOCATE;

Tablespace 'UNDO01' created.
```

```
SQL> ALTER DATABASE ADD LOGFILE THREAD 1 GROUP 3 '/usr/tibero/log/log031.log' size 50M;
Database altered.

SQL> ALTER DATABASE ADD LOGFILE THREAD 1 GROUP 4 '/usr/tibero/log/log041.log' size 50M;
Database altered.

SQL> ALTER DATABASE ADD LOGFILE THREAD 1 GROUP 5 '/usr/tibero/log/log051.log' size 50M;
Database altered.

SQL> ALTER DATABASE ENABLE PUBLIC THREAD 1;     ... ① ...
Database altered.
```

① Redo 스레드를 활성화하는 DDL 문장을 실행합니다.

Redo 로그 그룹을 추가하기 위한 기존 DDL 문장과 같지만, THREAD 번호를 지정한다는 점에 유의해야 합니다. 이 예제에서는 두 번째 인스턴스가 사용할 Undo 테이블 스페이스 **UNDO01**과 Redo 스레드 1용 Redo 로그 그룹을 추가하고 활성화하는 과정을 보여 줍니다.

Redo 스레드는 숫자로 지정합니다. CREATE DATABASE 문을 실행할 때 생성한 Redo 로그 그룹이 0번 스레드가 되므로, 반드시 1부터 지정해야 합니다. 0번 스레드는 CREATE DATABASE 문을 실행할 때 자동으로 활성화됩니다.

{% hint style="warning" %}
**주의**

Redo 로그 그룹의 번호는 Redo 스레드 내에서가 아니라 데이터베이스 전체에서 유일해야 하므로 이미 사용된 0, 1, 2를 사용할 수 없습니다. 또한 최소한 두 개 이상의 Redo 로그 그룹이 존재해야만 해당 Redo 스레드를 활성화시킬 수 있습니다. 또 다른 인스턴스를 추가하려면 위와 같은 과정을 참고하여 Undo 테이블 스페이스와 Redo 스레드를 생성하고 스레드를 활성화합니다.
{% endhint %}

5. TAC raw device 환경 또는 DB\_CREATE\_FILE\_DEST가 적절한 경로로 지정되지 않은 공유 파일 시스템 환경에서는 Tibero가 정상적으로 기동되지 않을 수 있습니다. 이 경우 TPR 관련 정보를 저장할 테이블 스페이스(SYSSUB)를 먼저 추가해야 합니다. 테이블 스페이스 생성에 대한 자세한 내용은 "[테이블 스페이스 생성 및 제거](/tibero-manuals/7.2.6.manuals/administrator-guide/file-and-data-management.md#undefined-8)"를 참고합니다.

```
[tibero@tester ~]$ tbsql sys/tibero

SQL> CREATE TABLESPACE SYSSUB DATAFILE '<SYSSUB 위치>/syssub001.dtf' ...;

Tablespace 'SYSSUB' created.
```

{% hint style="info" %}
**참고**

이 과정을 생략하고 다음 단계를 수행한 경우 "Tibero 설치 안내서"의 "[TAC 설치와 제거](/tibero-manuals/7.2.6.manuals/installation-guide/tac-install-uninstall.md)"와 "[Appendix A. 설치 후 문제 해결](/tibero-manuals/7.2.6.manuals/installation-guide/appendix/post-install-troubleshooting.md)"을 참고합니다.
{% endhint %}

6. $TB\_HOME/scripts 디렉터리에 있는 system\_install.sh 스크립트 파일을 실행합니다. Windows 환경에서는 system\_install.vbs 파일입니다.

```
[tibero@tester scripts]$ system_install.sh $TB_HOME/bin/tbsvr
Creating the role DBA...
Creating system users & roles...
Creating virtual tables(1)...
Creating virtual tables(2)...
Granting public access to _VT_DUAL...
Creating the system generated sequences...
Creating system packages:
    Running /home/tibero/tibero7/scripts/pkg_standard.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_output.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_lob.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_utility.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_obfuscation.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_transaction.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_random.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_lock.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_system.sql...
    Running /home/tibero/tibero7/scripts/pkg_dbms_job.sql...
    Running /home/tibero/tibero7/scripts/pkg_utl_raw.sql...
    Running /home/tibero/tibero7/scripts/pkg_utl_file.sql...
    Running /home/tibero/tibero7/scripts/pkg_tb_utility.sql...
Creating public synonyms for system packages...
.............................................
```

7. 다른 서버의 인스턴스를 기동하고 운영합니다.

## **TAC** 실행

TAC 실행에 필요한 사항과 데이터베이스 생성, TAC의 기동 및 모니터링 방법에 대해서 설명합니다.

#### 실행 전 준비 사항

TAC는 모든 인스턴스가 같이 사용할 수 있는 공유 디스크의 공간과 인스턴스 간의 통신이 가능한 네트워크만 있으면 실행할 수 있습니다.

TAC를 실행하기 전에 준비해야 할 H/W 요구사항과 운영체제 설정은 다음과 같습니다.

**공유 디스크의 공간**

* TAC의 실행과 운영을 위해서는 최소 7개의 공유 파일이 필요합니다.
  * 컨트롤 파일
  * Redo 로그 파일 2개
  * Undo 로그 파일
  * 시스템 테이블 스페이스 파일
  * 임시 테이블 스페이스 파일
  * TBCM 파일
* 인스턴스 하나를 추가할 때마다 최소 3개의 공유 파일이 추가로 필요합니다.
  * Redo 로그 파일 2개
  * Undo 로그 파일

**공유 디스크의 권한**

공유 파일 시스템을 사용할 경우에는 TAC가 사용할 디렉터리의 권한, RAW 파일 시스템을 사용할 경우에는 각 RAW 파일의 권한을 TAC가 읽고 쓸 수 있도록 설정합니다.

**내부 네트워크의 설정**

TAC의 실행과 운영을 위해 내부 네트워크는 외부 네트워크와 분리하는 것이 좋습니다. 내부 네트워크의 인터페이스, IP, 속도 등을 점검합니다.

{% hint style="info" %}
**참고**

TAC에서 내부 네트워크를 구성할 때 크로스오버 케이블을 이용한 방식은 지원하지 않습니다.
{% endhint %}

#### 데이터베이스 생성

TAC를 처음 기동할 때는 데이터베이스를 생성해야 합니다. 클러스터로 사용할 한 노드에서 생성하면 됩니다. TAC로 Tibero를 기동할 때는 CM이 필수입니다. CM을 먼저 설정하고 시작한 후 Tibero를 NOMOUNT 모드로 기동합니다. CM 설정 방법은 “[Tibero Cluster Manager](/tibero-manuals/7.2.6.manuals/administrator-guide/tibero-cluster-manager.md)”를 참고합니다.

다음은 CM 설정을 마친 후 Tibero를 NOMOUNT 모드로 기동하는 예입니다.

```
[tacl@tester ~]$ tbboot -t NOMOUNT
listener port = xxxx
change core dump dir to /home/tibero7/bin/prof

Tibero 7

TmaxData Corporation Copyright (c) 2008-. All rights reserved.

Tibero instance started up (NOMOUNT mode).

[tacl@tester ~]$
```

NOMOUNT 모드로 기동된 첫 번째 TAC의 인스턴스에 접속하여 데이터베이스를 만든 후 다른 클러스터의 인스턴스를 위한 Redo 로그, Undo 로그를 생성합니다. 인스턴스의 $TB\_SID.tip 환경 설정 파일에 지정한 THREAD, UNDO\_TABLESPACE 초기화 파라미터의 이름과 반드시 일치해야 합니다.

#### **TAC** 기동

데이터베이스 생성과 다른 인스턴스의 환경 설정 파일 생성이 모두 완료되면 TAC를 기동할 수 있습니다.

다음은 다른 인스턴스를 모두 실행하고 CM, Tibero 순으로 TAC를 기동하는 예입니다.

```
[tac2@tester ~]$ tbcm -b
CM Guard daemon started up.
import resources from 'CM TIP에 입력된 resource file path'...

Tibero 7

TmaxData Corporation Copyright (c) 2008-. All rights reserved.

Tibero cluster manager started up.
Local node name is (cm0:xxxx).

[tac2@tester ~]$ tbboot
listener port = xxxx
change core dump dir to /home/tibero7/bin/prof

Tibero 7

TmaxData Corporation Copyright (c) 2008-. All rights reserved.

Tibero instance started up (NORMAL mode).

[tac2@tester ~]$
```

#### **TAC** 모니터링

$TB\_HOME/scripts 디렉터리에 있는 cm\_stat.sh 스크립트 파일을 통해 노드 및 인스턴스의 상태를 모니터링할 수 있습니다. TAC에 참여한 노드의 현재 상태, IP 정보 등을 주기적으로 확인할 수 있습니다.

Tibero는 글로벌 뷰(Global View)를 제공합니다. 싱글 인스턴스에서 사용하는 모든 모니터링 뷰를 TAC 인스턴스에서 조회할 수 있습니다.

다음은 모든 클러스터에 연결되어 있는 세션을 확인하는 예입니다. tbSQL 유틸리티, tbAdmin 툴을 통해 다음과 같은 SQL 문장을 실행합니다.

**\[예 1] 글로벌 뷰의 조회 - GV$SESSION**

```
SQL> SELECT * FROM GV$SESSION;
```

{% hint style="info" %}
**참고**

글로벌 뷰에서 조회되는 INST\_ID는 INSTANCE\_NUMBER와는 별개의 값이며, CM 기동 순서에 따라 변경될 수 있습니다.
{% endhint %}


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://docs.tibero.com/tibero-manuals/7.2.6.manuals/administrator-guide/tibero-active-cluster.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.