> For the complete documentation index, see [llms.txt](https://docs.tibero.com/tibero-manuals/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.tibero.com/tibero-manuals/7.2.6.manuals/administrator-guide/schema-object-management.md).

# 스키마 객체 관리

Tibero에서 실제로 데이터베이스를 구성하는 데 필요한 논리적 저장 영역 즉, 스키마 객체를 관리하는 방법과 이를 구성하는 최소 단위인 디스크 블록을 설명합니다.

## 개요

다음은 데이터베이스의 대표적인 스키마 객체입니다.

* 테이블(Table)
* 인덱스(Index)
* 뷰(View)
* 시퀀스(Sequence)
* 동의어(Synonym)

스키마 객체는 한 스키마에 의해 생성되며 또한 그 스키마에 속하게 됩니다. 테이블, 인덱스와 같이 실제 물리적 공간을 가지는 객체를 세그먼트라고 합니다.

## 테이블

테이블(Table)은 관계형 데이터베이스에서 가장 기본적인 스키마 객체입니다.

다른 스키마 객체의 형태로 표현하더라도 대부분의 데이터베이스 처리는 테이블에서 이루어집니다. 따라서 관계형 데이터베이스 설계의 중심은 테이블 설계이며, 테이블을 효율적으로 관리하는 것이 데이터베이스 성능에 큰 영향을 미칩니다.

테이블은 다음과 같이 두 가지 구성요소로 이루어집니다.

<table><thead><tr><th width="158">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>컬럼(column)</td><td>테이블에 저장될 데이터의 특성을 설정</td></tr><tr><td>로우(row)</td><td>하나의 테이블을 구성하며 다른 유형의 데이터가 저장</td></tr></tbody></table>

데이터베이스를 효율적으로 운영하기 위해서는 테이블 설계를 정확하게 해야 하며 테이블의 배치와 저장 환경 설정 등을 고려해야 합니다. Tibero는 테이블을 생성하고 나서 설계를 변경하는 것을 어느 정도 허용하고 있습니다. 그러나 테이블의 설계를 변경하려면 처리 비용이 많이 들기 때문에 될 수 있으면 잦은 변경은 하지 말아야 합니다.

테이블을 정확하게 설계하기 위해서는 정규화(normalization) 과정과 각 테이블에 적절한 무결성 제약조건(integrity constraints)을 설정해야 합니다. 예를 들어 조인 연산을 피하기 위해 테이블 간의 중복된 데이터를 허용하는 경우 데이터의 일관성 유지를 위해 어떻게 테이블을 설계할 것인지를 고려해야 합니다.

### 테이블 생성, 변경, 제거

본 절에서는 테이블을 생성, 변경, 제거하는 방법을 설명합니다.

#### **테이블 생성**

테이블을 생성하기 위해서는 **CREATE TABLE** 문을 사용해야 합니다. 테이블은 다음과 같은 경우에 따라 생성 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 테이블을 생성하는 경우 **CREATE TABLE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 테이블을 생성하는 경우 **CREATE ANY TABLE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 테이블을 생성할 때 포함되는 구성요소입니다.

<table><thead><tr><th width="184">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>테이블의 이름</td><td><ul><li>테이블의 이름을 설정</li><li>이 구성요소는 테이블을 생성할 때 반드시 포함되어야 함</li><li>테이블의 이름은 최대 <strong>128자</strong>로 설정할 수 있음</li><li>한 사용자의 스키마 내에서 유일해야 하며, 모든 스키마 객체의 이름과 달라야 함</li><li>서로 다른 사용자는 같은 이름의 테이블을 소유할 수 있음</li><li>인덱스, 트리거, 대용량 객체형과도 같은 이름을 사용할 수 있음</li><li>공용 동의어(public synonym)과 같은 이름도 테이블의 이름으로 사용할 수 있음</li><li>공용 동의어의 이름을 SQL 문장에서 사용하면 공용 동의어라는 의미 대신 현재 사용자가 소유한 테이블이 됨</li></ul></td></tr><tr><td>테이블의 컬럼 구조</td><td><ul><li>테이블에 저장될 데이터의 특성(컬럼 이름, 데이터 타입, 디폴트 값 등)을 설정</li><li>이 구성요소는 테이블을 생성할 때 반드시 포함되어야 함</li><li>테이블은 하나 이상의 컬럼으로 구성되며 각 컬럼은 반드시 데이터 타입을 선언해야 함</li><li>한 테이블은 최대 <strong>1,000개 컬럼</strong>으로 구성할 수 있음</li><li>컬럼의 이름은 최대 128자로 설정할 수 있음</li><li>컬럼의 디폴트 값과 제약조건은 선택적으로 선언할 수 있음</li></ul></td></tr><tr><td>무결성 제약조건</td><td><ul><li>테이블의 컬럼에 사용자가 원하지 않는 데이터가 입력, 변경, 제거되는 것을 방지하기 위해 설정</li><li>이 구성요소는 테이블을 생성할 때 선택적으로 사용할 수 있음<br>(자세한 내용은 <em>4.3 제약조건</em> 참고)</li><li>기본 키(<strong>PRIMARY KEY</strong>), 유일 키(<strong>UNIQUE KEY</strong>), 참조 무결성(<strong>referential integrity</strong>), <strong>NOT NULL</strong>, <strong>CHECK</strong> 등의 제약조건이 있음</li><li>제약조건의 이름은 테이블 내에서 유일해야 함</li><li>제약조건은 컬럼 또는 테이블 단위에서 설정할 수 있음</li><li>두 개 이상의 복합 컬럼을 사용하는 경우 제약조건을 따로 설정해야 함</li><li><code>ALTER TABLE</code> 문을 사용하여 제약조건을 추가 또는 상태를 변경하거나 제거할 수 있음</li></ul></td></tr><tr><td>테이블 스페이스</td><td><ul><li>테이블이 저장될 테이블 스페이스를 설정</li><li>이 구성요소는 테이블을 생성할 때 선택적으로 사용할 수 있음</li><li>테이블 스페이스를 명시하지 않으면 사용자의 디폴트 테이블 스페이스로 설정됨</li><li>테이블의 적절한 배치가 데이터베이스 성능에 큰 영향을 미치므로, 테이블의 소유자는 테이블이 저장될 테이블 스페이스를 별도로 명시하는 것이 좋음</li></ul></td></tr><tr><td>디스크 블록 파라미터</td><td><ul><li>디스크 블록마다 테이블의 갱신에 대비하여 어느 정도 여유 공간을 남겨둘 것인가를 설정 (자세한 내용은 "<em>디스크 블록"</em> 참고)</li><li><code>PCTFREE</code></li><li><code>INITRANS</code></li></ul></td></tr><tr><td>파티션</td><td>• 파티션을 정의</td></tr></tbody></table>

다음은 테이블을 생성하는 예입니다.

**\[예 1] 테이블의 생성**

```
CREATE TABLESPACE my_space DATAFILE '/usr/tibero/dtf/my_space.dtf' SIZE 50M;

CREATE TABLE DEPT
(
     DEPTNO     NUMBER PRIMARY KEY,
     DEPTNAME   VARCHAR(20),
     PDEPTNO    NUMBER
)
TABLESPACE my_space
PCTFREE 5 INITRANS 3;

CREATE TABLE EMP
(
     EMPNO      NUMBER PRIMARY KEY,
     ENAME      VARCHAR(16) NOT NULL,
     ADDR       VARCHAR(24),
     SALARY     NUMBER,
     DEPTNO     NUMBER,
     CHECK (SALARY >= 10000),
     FOREIGN KEY (DEPTNO) REFERENCES DEPT(DEPTNO)
)
TABLESPACE my_space
PCTFREE 5 INITRANS 3;

ALTER SYSTEM SET USE_RECYCLEBIN=Y;
```

위의 예에서 보듯이 테이블 EMP는 다섯 개의 컬럼(EMPNO, ENAME, ADDR, SALARY, DEPTNO)으로 구성되어 있으며, 4개의 제약조건으로 선언되어 있습니다. 또한 테이블 스페이스 my\_space에 저장되며 디스크 블록 파라미터의 세부 항목(PCTFREE, INITRANS)을 모두 설정하였습니다.

#### **테이블 변경**

테이블을 변경하기 위해서는 **ALTER TABLE** 문을 사용해야 합니다. 테이블은 다음과 같은 경우에 따라 변경 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 테이블을 변경하는 경우 **ALTER TABLE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 있는 테이블을 변경하는 경우 **ALTER ANY TABLE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 테이블을 변경할 때 포함되는 구성요소입니다.

<table><thead><tr><th width="208">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>테이블의 이름</td><td><ul><li>테이블의 이름을 변경</li><li>테이블의 이름은 최대 128자로 변경할 수 있음</li></ul></td></tr><tr><td>컬럼의 정의 변경</td><td><ul><li>컬럼에 정의된 속성(디폴트 값, 제약조건 등)을 변경</li><li>컬럼의 디폴트 값과 제약조건은 MODIFY 절을 이용하여 변경</li><li>[예 2]를 참고</li></ul></td></tr><tr><td>컬럼의 이름</td><td><ul><li>컬럼의 이름과 정의된 컬럼의 속성을 변경</li><li>컬럼 이름은 최대 30자로 변경할 수 있으며 RENAME COLUMN 절을 사용하여 변경</li><li>[예 3]을 참고</li></ul></td></tr><tr><td>디스크 블록의 파라미터</td><td><ul><li>파라미터의 이름과 값을 지정</li><li>[예 4]를 참고</li></ul></td></tr><tr><td>제약조건</td><td><ul><li>제약조건의 이름을 변경</li><li>제약조건을 추가하거나 제거</li><li>제약조건의 상태를 변경</li></ul></td></tr><tr><td>테이블 스페이스</td><td>테이블에 할당된 테이블 스페이스는 변경할 수 없음</td></tr><tr><td>파티션</td><td>파티션을 추가하거나 제거</td></tr></tbody></table>

다음은 \[예 1]에서 생성한 EMP 테이블의 속성을 변경하는 예입니다.

* 정의된 컬럼의 속성을 변경하는 경우

**\[예 2] 테이블의 변경 - 컬럼 속성**

```
ALTER TABLE EMP
        MODIFY (SALARY DEFAULT 5000 NOT NULL);
```

**SALARY** 컬럼은 MODIFY 절을 사용하여 디폴트 값과 NOT NULL 제약조건으로 재정의합니다. 본 예제에서는 컬럼 SALARY의 디폴트 값을 5000으로 하고, 동시에 SALARY 값이 NULL이 되지 못하도록 컬럼의 속성을 변경합니다. 동시에 여러 컬럼의 속성을 변경할 수도 있습니다. 이때 각 컬럼의 내용은 콤마(,)로 분리하여 다시 정의합니다.

* 컬럼의 이름을 변경하는 경우

**\[예 3] 테이블의 변경 - 컬럼 이름**

```
ALTER TABLE EMP RENAME COLUMN ADDR TO ADDRESS;
```

**ADDR** 컬럼은 RENAME COLUMN 절을 사용하여 컬럼의 이름을 **ADDRESS**로 변경합니다.

컬럼의 이름을 변경하면 이전에 컬럼 이름을 사용하던 제약조건 등은 Tibero 시스템에 의해 자동으로 변경됩니다. 예를 들어 위 SQL 문장이 실행되면 ADDR 컬럼에 설정된 제약조건이 ADDRESS 컬럼에 자동으로 적용됩니다. 단, CHECK 제약조건의 경우 제대로 동작하지 않을 수 있으며 사용자가 ALTER TABLE 문을 이용하여 제약조건을 다시 정의해야 합니다.

* 디스크 블록 파라미터의 값을 변경하는 경우

**\[예 4] 테이블의 변경 - 디스크 블록의 파라미터**

```
ALTER TABLE EMP PCTFREE 10;
```

디스크 블록 파라미터의 값을 변경하려면 파라미터의 이름과 값을 지정하면 됩니다. 본 예제에서는 테이블 EMP의 PCTFREE 파라미터 값을 5에서 10으로 변경합니다.

* 제약조건을 변경하는 경우

테이블에 설정된 제약조건과 상태를 변경하는 내용은 “[제약조건](#undefined-16)”에서 자세히 설명합니다. 또한 테이블을 생성하거나 변경하는 자세한 문법은 "[Tibero SQL 참조 안내서](/tibero-manuals/7.2.6.manuals/sql-reference-guide.md)"를 참고합니다.

#### **테이블 제거**

테이블을 제거하기 위해서는 **DROP TABLE** 문을 사용해야 합니다.

테이블은 다음과 같은 경우에 따라 제거 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 테이블을 제거하는 경우 **DROP TABLE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 있는 테이블을 제거하는 경우 **DROP ANY TABLE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 테이블을 제거하는 예입니다.

**\[예 5] 테이블의 제거**

```
DROP TABLE EMP;
```

다른 사용자가 소유한 테이블을 제거하려면, 반드시 다른 사용자의 이름을 명시한 후 DROP TABLE 문을 실행해야 합니다.

예를 들면 다음과 같습니다.

```
DROP TABLE John.EMP;
```

제거하려는 테이블의 기본 키가 다른 테이블의 참조 무결성 제약조건으로 정의된 경우 참조된 테이블은 바로 제거할 수 없습니다. 이러한 경우에는 참조하는 테이블을 먼저 제거하거나 참조하는 테이블에 정의된 참조 무결성 제약조건을 제거해야 합니다. 참조하는 테이블에 정의된 참조 무결성 제약조건을 제거하기 위해서는 DROP TABLE 문에 **CASCADE CONSTRAINTS** 절을 삽입해야 합니다.<br>

예를 들면 다음과 같습니다.

```
DROP TABLE EMP CASCADE CONSTRAINTS;
```

만약 초기화 파라미터 USE\_RECYCLEBIN을 'Y'로 설정하여 RECYCLEBIN 기능을 사용하고 있다면 테이블은 바로 삭제되지 않고 이름이 변경됩니다. 그리고 해당 테이블에는 접근할 수 없게 됩니다.

삭제되어 이름이 변경된 테이블을 다시 복구시키려면 FLASHBACK 쿼리를 사용해야 합니다.

다음은 FLASHBACK 문을 사용하여 테이블을 복원하는 예입니다.

**\[예 6] 테이블 복구**

<pre><code><strong>FLASHBACK TABLE EMP TO BEFORE DROP;
</strong></code></pre>

FLASHBACK 문에 대한 자세한 문법은 "Tibero SQL 참조 안내서"의 "[FLASHBACK TABLE](/tibero-manuals/7.2.6.manuals/sql-reference-guide/data-definition-language/flashback-table.md)"을 참고합니다.

변경된 테이블의 정보는 ALL\_RECYCLEBIN, DBA\_RECYCLEBIN, USER\_RECYCLEBIN에서 조회할 수 있습니다. 관련 뷰들의 자세한 내용은 "Tibero 참조 안내서"의 "[ALL\_RECYCLEBIN](/tibero-manuals/7.2.6.manuals/reference-guide/static-views.md#all_recyclebin)", "[DBA\_RECYCLEBIN](/tibero-manuals/7.2.6.manuals/reference-guide/static-views.md#dba_recyclebin)", "[USER\_RECYCLEBIN](/tibero-manuals/7.2.6.manuals/reference-guide/static-views.md#user_recyclebin)"을 참고합니다.

이름이 변경된 테이블이 삭제되는 경우는 아래와 같습니다.

* 사용자가 PURGE 문을 이용하여 삭제하는 경우
* 특정 조건이 충족되어 AUTO PURGE가 수행되는 경우

PURGE 문에 대한 자세한 문법은 "Tibero SQL 참조 안내서"의 "[PURGE](/tibero-manuals/7.2.6.manuals/sql-reference-guide/data-definition-language/purge.md)"에서 자세히 설명합니다.

AUTO PURGE에 대한 내용은 다음 절에서 설명합니다.

#### **AUTO PURGE**

AUTO PURGE란 테이블 스페이스에 여유 공간이 없는 경우 또는 사용자의 QUOTA 값이 설정된 최대치에 도달한 경우 RECYCLEBIN에 있는 오브젝트를 자동으로 PURGE하여 공간을 확보하는 기능으로 USE\_RECYCLEBIN, USE\_RECYCLEBIN\_AUTO\_PURGE 파라미터를 모두 'Y'로 설정한 상태에서만 동작합니다.

RECYCLEBIN 기능이 활성화된 경우 RECYCLEBIN에 속한 오브젝트(파티션, LOB 세그먼트 포함)의 크기만큼을 테이블 스페이스의 사용 가능 공간으로 간주하며 DBA\_FREE\_SPACE, USER\_FREE\_SPACE 뷰에서 해당 정보를 조회할 수 있습니다.

관련 뷰들의 자세한 내용은 "Tibero 참조 안내서"의 "[DBA\_FREE\_SPACE](/tibero-manuals/7.2.6.manuals/reference-guide/static-views.md#dba_free_space)", "[USER\_FREE\_SPACE](/tibero-manuals/7.2.6.manuals/reference-guide/static-views.md#user_free_space)"를 참고합니다.

AUTO PURGE는 아래의 방식으로 동작합니다.

**QUOTA가 설정된 경우**

* 공간을 할당받는 상황에서 해당 테이블 스페이스에 설정된 QUOTA의 최대 값을 넘으려고 하면 RECYCLEBIN에 오브젝트 중 가장 오래된 것부터 PURGE합니다.
* PURGE 대상은 해당 계정이 생성한 오브젝트로만 선정됩니다.
* 필요한 공간이 확보될 때까지만 PURGE가 수행됩니다.<br>

**테이블 스페이스에 여유 공간이 없는 경우**

* RECYCLEBIN에 속한 오브젝트 중 가장 오래된 것부터 PURGE하여 공간을 확보합니다.
* AUTOEXTEND가 활성화된 테이블 스페이스인 경우 PURGE를 했음에도 공간을 확보하지 못했다면 테이블 스페이스를 확장합니다.
* AUTOEXTEND가 비활성화된 테이블 스페이스인 경우 PURGE를 수행해도 공간을 확보하지 못했다면 ERROR\_TX\_CANT\_ALLOC\_EXT 에러가 발생합니다.
* 오브젝트의 OWNER와 관계없이 해당 테이블 스페이스에 속하면 PURGE 대상이 됩니다.
* 필요한 공간이 확보될 때까지만 PURGE가 수행됩니다.

### 테이블의 효율적인 관리

테이블을 효율적으로 관리하기 위해서는 각각의 경우에 맞는 적절한 조치 방법을 수행해야 합니다.

예를 들면 다음과 같은 경우입니다.

* 동시에 액세스될 가능성이 높은 테이블인 경우 병렬 쿼리 처리가 수행될 가능성을 높이기 위해 서로 다른 디스크에 데이터를 저장합니다.\
  예를 들어 조인이 이루어지는 SELECT 문에서 액세스할 두 개의 테이블의 SELECT 연산을 먼저 수행한 후 조인 연산을 수행하는 경우라면, 이 두 테이블을 서로 다른 디스크에 저장하여 SELECT 연산이 병렬적으로 수행되도록 합니다.<br>
* 테이블이 저장될 디스크의 용량을 결정하는 경우 테이블의 최대 크기를 추정합니다. 테이블에 UPDATE 연산이 자주 발생하는 경우라면 디스크 블록에 갱신을 위한 디스크 공간을 충분히 할당해야 합니다. 디스크 공간을 할당하는 방법은 **PCTFREE** 파라미터를 삽입하여 설정하면 됩니다.<br>
* 테이블에 동시에 액세스할 트랜잭션의 수를 결정하는 경우 동시에 액세스할 트랜잭션의 수를 추정합니다. 테이블을 구성하는 디스크 블록 안에 트랜잭션의 정보를 저장해야 하며, 얼마만큼의 디스크 공간을 할당할 것인지를 정해야 합니다. 이러한 공간을 할당하는 방법은 INITRANS 파라미터를 삽입하여 설정합니다.\
  갱신에 대비하거나 테이블을 액세스할 트랜잭션의 정보를 저장할 디스크 공간이 필요한 경우 같은 크기의 테이블이라도 좀 더 많은 디스크 공간을 필요로 합니다. PCTFREE와 INITRANS 파라미터에 대한 자세한 내용은 “[디스크 블록](#undefined-24)”을 참고합니다.<br>
* 테이블에 INSERT 연산이 발생하는 경우 로그를 저장하는 디스크 공간을 할당합니다. 테이블에 INSERT 연산이 자주 발생하는 경우라면 Redo 로그를 구성하는 로그 그룹의 크기와 개수를 증가시켜야 하므로 그만큼 디스크의 공간도 커져야 합니다.\
  단, Redo 로그를 저장하는 디스크는 데이터를 저장하는 디스크와는 다른 것을 사용해야 합니다.

### 테이블 정보 조회

Tibero에서는 테이블의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다. DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="212">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_TABLES</td><td>Tibero 내의 모든 테이블의 정보를 조회하는 뷰</td></tr><tr><td>USER_TABLES</td><td>현재 사용자에 속한 테이블의 정보를 조회하는 뷰</td></tr><tr><td>ALL_TABLES</td><td>현재 사용자가 접근 가능한 테이블의 정보를 조회하는 뷰</td></tr><tr><td>DBA_TBL_COLUMNS</td><td>Tibero 내의 모든 테이블과 뷰에 속한 컬럼의 정보를 조회하는 뷰</td></tr><tr><td>USER_TBL_COLUMNS</td><td>현재 사용자에 속한 테이블 및 뷰에 속한 컬럼의 정보를 조회하는 뷰</td></tr><tr><td>ALL_TBL_COLUMNS</td><td>현재 사용자가 접근 가능한 테이블 및 뷰에 속한 컬럼의 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**

정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}

### 테이블 압축

Tibero는 테이블에 대해 중복된 컬럼 값을 압축하여 저장 공간을 절약하는 압축 기능을 제공합니다. 값 블록에 존재하는 중복된 컬럼 값을 한 번만 저장함으로써 압축을 수행하게 됩니다. 이런 중복 컬럼 값들이 저장되는 공간을 심볼 테이블이라고 합니다. 심볼 테이블은 해당 블록 안에 저장되기 때문에 압축된 컬럼의 원래 값을 참조하기 위해서는 해당 블록만을 참조하면 됩니다.

압축된 테이블에 대한 DML 지원은 일반 테이블과 동일합니다. 즉, insert, update, delete 등의 DML을 지원합니다. bulk가 아닌 일반적인 insert 문으로 추가된 로우는 압축되지 않으므로 비압축 테이블에 대한 insert와 동일한 성능을 가집니다. delete 또한 비압축 테이블에 대한 delete와 동일한 성능을 가집니다. 하지만 update는 압축을 해제해야 하는 경우가 있으므로 비압축 테이블에 대한 update보다 성능이 좋지 않을 수 있습니다.

압축을 수행하면 디스크 공간을 절약할 수 있지만 압축을 위해 CPU를 더 많이 소모합니다. 테이블에 DML이 많은 경우 점점 더 압축 효율이 낮아지게 됩니다. 따라서 OLTP 환경보다는 OLAP 환경에서 더 유리합니다.

#### **테이블 압축 대상**

압축은 테이블과 파티션, 서브 파티션에 대해 가능합니다. 파티션과 서브 파티션 각각에 대해 압축 유무를 지정할 수 있습니다. 즉, 한 파티션은 압축하고 한 파티션은 압축하지 않은 상태로 테이블을 생성할 수 있습니다.

**\[예 7] 압축이 지정된 테이블 생성**

```
CREATE TABLE EMP  (
        EMPNO       DECIMAL(4),
        ENAME       VARCHAR(10),
        JOB         VARCHAR(9),
        MGR         DECIMAL(4),
        HIREDATE    VARCHAR(14),
        SAL         NUMBER(7,2),
        COMM        NUMBER(7,2),
        DEPTNO      NUMBER(2))
COMPRESS;
```

**\[예 8] 파티션별 압축을 지정하는 테이블 생성**

```
CREATE TABLE EMP (
        EMPNO       DECIMAL(4),
        ENAME       VARCHAR(10),
        JOB         VARCHAR(9),
        MGR         DECIMAL(4),
        HIREDATE    VARCHAR(14),
        SAL         NUMBER(7,2),
        COMM        NUMBER(7,2),
        DEPTNO      NUMBER(2))
        COMPRESS
        PARTITION BY RANGE(EMPNO)
(       PARTITION EMP_PART1 VALUES LESS THAN(500),
        PARTITION EMP_PART2 VALUES LESS THAN(1000) NOCOMPRESS,
        PARTITION EMP_PART3 VALUES LESS THAN(1500),
        PARTITION EMP_PART4 VALUES LESS THAN(2000) NOCOMPRESS,
        PARTITION EMP_PART5 VALUES LESS THAN(MAXVALUE));
```

#### **테이블 압축 상태 확인**

\*\_TABLES, \*\_TBL\_PARTITIONS 정적 뷰를 쿼리해 보면 테이블의 압축 상태를 알 수 있습니다. compression 컬럼의 값이 'YES'인 경우 추가적인 DML에 대해 압축을 수행하게 됩니다.

**\[예 9] 테이블의 압축 상태 확인**

```
select table_name, compression from user_tables;

TABLE_NAME         COMPRESSION
----------------   ----------
EMP                YES
```

#### **테이블 압축 방법**

다음의 경우 테이블에 데이터가 압축됩니다.

* Direct Path Loader
* Direct Path Insert(Parallel INSERT 또는 append hint로 수행되는 bulk INSERT)
* CREATE TABLE AS SELECT 문

위 경우처럼 대량으로 insert하는 경우에는 테이블에 EXCLUSIVE LOCK을 잡기 때문에 다른 DML을 수행할 수 없습니다. 압축된 후 위 경우 이외에 수행되는 일반적인 insert, update 문의 로우 값은 압축되지 않습니다.

#### **기존 테이블 압축 및 압축 해제**

ALTER TABLE MOVE 문을 이용하면 기존 테이블에 대한 압축 상태 변경을 할 수 있습니다. 즉, 압축된 테이블을 압축 해제하거나 압축 해제된 테이블을 압축할 수 있습니다. 단, **ALTER TABLE MOVE** 문이 수행되는 동안에는 테이블에 EXCLUSIVE LOCK을 잡게 되므로 다른 DML을 수행할 수 없습니다. 파티션을 가진 테이블의 경우 테이블 자체가 아닌 파티션 단위로 MOVE를 수행해야 합니다.

만약, DML을 수행하는 도중에 압축 상태를 바꾸려는 경우 Exchange DDL 기능을 이용하면 Online 중에 테이블을 압축 또는 압축 해제할 수 있습니다.

**\[예 10] 기존 테이블 또는 파티션을 압축하거나 압축 해제하는 예**

```
ALTER TABLE EMP MOVE COMPRESS;
ALTER TABLE EMP MOVE PARTITION EMP_PART1 NOCOMPRESS;
```

ALTER TABLE 문을 이용하면 추가적인 DML에 대해 압축을 수행할지 여부를 설정할 수 있습니다. 압축이 지정된 테이블에 ALTER TABLE 문으로 압축을 하지 않기로 지정하면 이후 수행되는 Direct Path Loader, Parallel Insert 등에 대해 압축을 수행하지 않게 됩니다. 하지만 기존의 데이터의 상태는 바뀌지 않습니다.

**\[예 11] 테이블의 추가적인 DML에 대한 압축 여부를 변경하는 예**

```
ALTER TABLE EMP COMPRESS;
```

#### **테이블 압축 시 제약 사항**

한 번이라도 압축이 지정된 테이블에는 기본값이 지정된 컬럼 추가, 컬럼 삭제 DDL을 수행할 수 없으며, Long 타입 컬럼을 가지고 있는 압축된 테이블에는 컬럼 추가 DDL이 허용되지 않습니다.

### Tibero Columnar Compression

Tibero는 Direct Path Load/Insert 사용 시 column 기반 압축 기능인 Tibero Columnar Compression(이하 TCC)을 제공합니다.

#### **개요**

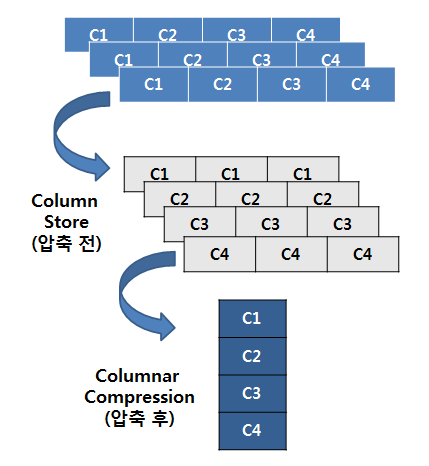
TCC는 압축률 향상과 디스크 I/O 감소에 도움을 주는 데이터 저장 방식입니다. TCC를 이용하면 기존의 방식(row의 column들을 연속으로 배치하는 것)을 대신하여 테이블의 각 컬럼들을 개별적으로 수집하여 연속으로 저장합니다.

아래와 같이 컬럼을 연속으로 배치하면 동일한 데이터 패턴이 반복되어 RLE(Run-Length Encoding), LZ4(Lempel-Ziv 4), gzip(GNU zip), bzip2(block zip version 2)와 같은 압축 기법에 매우 효과적입니다.

**\[그림 1] TCC 구성(Compression Unit)**

<div align="left"><img src="https://content.gitbook.com/content/evqs7Ne3nMyXQFkBSQWR/blobs/2qLhinz1d8SI1X5AA7DC/admin_2.png" alt="TCC 구성(Compression Unit)"></div>

TCC는 아래와 같은 장점을 갖습니다.

* 압축률이 크게 향상됩니다. 데이터 패턴에 따라 차이가 나지만, 일반적인 OLAP 비즈니스 환경에서 4:1\~10:1의 압축률 향상을 기대할 수 있습니다.
* 압축률이 향상되므로 전체 I/O가 줄어듭니다. I/O가 성능의 병목인 경우 성능 향상을 도모할 수 있습니다. 또한 ZetaData는 SSVR 인스턴스에서 압축을 해제하기 때문에 DB 노드의 자원을 소모하지 않습니다. Storage 노드의 CPU 자원은 일반적으로 여유가 있는 경우가 많습니다.
* 컬럼별로 배치되므로 불필요한 컬럼을 읽지 않습니다. 전체 컬럼 수와 비교하여 필요한 컬럼이 적을 경우 I/O 수행 횟수를 줄일 수 있습니다.

아래의 경우에 TCC를 사용하면 효과적입니다.

* **Update(또는 delete)가 드물게 발생하는 테이블**\
  위에서 설명한 바와 같이 TCC로 구성된 테이블에 대해 update가 일어나면 성능이 저하됩니다. 따라서 주로 DPL/DPI를 통해 대량으로 로딩하고, 데이터 라이프 사이클(Life Cycle)에 따라 테이블 전체를 따로 저장하거나 폐기하는 용도로 매우 적합합니다.<br>
* **Full table scan이 빈번하게 발생하는 테이블**\
  주로 사용되는 쿼리가 Full table scan인 경우에 TCC를 추천합니다. Full table scan은 선택도(Selectivity)에 따라 결정될 수도 있고, aggregation 사용 여부에 따라 결정될 수도 있습니다.<br>
* **데이터 길이나 패턴이 일정하거나 비슷한 테이블**\
  데이터 길이나 패턴이 일정하거나 비슷한 테이블의 경우 RLE, LZ4, gzip, bzip2와 같은 압축을 적용했을 때에 좋은 압축률을 기대할 수 있습니다. 또한 로딩할 때 압축률이 거의 일정하면, 재압축 횟수가 줄어들어 로딩 속도도 향상됩니다.<br>
* **Projectivity가 큰 테이블**\
  TCC 사용은 테이블의 일부 컬럼만 필요로 하는 경우에 특히 효과적입니다. 필요하지 않은 컬럼에 해당하는 CU(Compression Unit)는 읽지 않습니다. 만약, row-oriented로 저장되어 있다면 필요로 하는 컬럼 개수와 관계없이 row의 전체 컬럼을 읽어야 합니다. 따라서 상대적으로 읽어야 하는 블록 숫자가 늘어나게 됩니다.

#### **TCC 초기화 파라미터**

아래는 TCC와 관련한 초기화 파라미터에 대한 설명입니다. CC\_CU\_BLKCNT는 시스템 파라미터이고 나머지 파라미터들은 세션 파라미터입니다.

<table><thead><tr><th width="292">파라미터</th><th>설명</th></tr></thead><tbody><tr><td>CC_CU_BLKCNT</td><td><ul><li>CU(Compression Unit)가 가질 수 있는 최대 블록 개수<br></li><li>보통 큰 CU가 압축에 유리하지만, 어느 정도 이상이 되면 더 많은 처리 이득이 나지 않음</li><li>불필요하게 CU가 크면 반복적인 압축 해제/재압축을 하는 경우 불리하게 작용할 수도 있음</li><li><code>DB_FILE_MULTIBLOCK_READ_COUNT</code>보다 작게 설정하는 것을 권장 (기본값: 4, 범위: 1 ~ 32)</li></ul></td></tr><tr><td>CC_CU_PCTUSE</td><td><ul><li>CU에 들어갈 최소 용량 비율</li><li>CU를 구성할 때 최소 이 비율 이상을 채우도록 함</li><li>값이 크면 공간 낭비를 막을 수 있는 반면, 로딩될 때 재압축이 많아져서 성능이 저하될 수 있음<br>(기본값: 95, 범위: 0 ~ 99)</li></ul></td></tr><tr><td>CC_TYPICAL_ROW_SIZE</td><td><ul><li>압축될 데이터의 일반적인 row 크기</li><li>처음 압축을 시작할 때 힌트로 사용</li><li>이 값과 <code>CC_EXPECTED_RATE</code>를 이용해서 한 CU에 몇 개의 row가 들어갈지 예측해 압축을 더 빠르게 진행할 수 있음(기본값: 100, 범위: 3 ~ 1000)</li></ul></td></tr><tr><td>CC_EXPECTED_RATE</td><td><ul><li>압축될 데이터의 일반적인 압축 비율(힌트)</li><li><code>CC_TYPICAL_ROW_SIZE</code>와 함께 처음 CU를 구성할 때 사용되며, 이후 CU에 대한 예측은 직접 CU의 결과를 이용<br>(기본값: 25, 범위: 1 ~ 100)</li></ul></td></tr><tr><td>CC_CU_WRITEOUT_THRESHOLD</td><td><ul><li><code>CC_CU_WRITEOUT_THRESHOLD</code>는 단일 블록에 쓰기 작업을 진행하기 위해 충족해야 하는 최소 채움 비율을 지정하는 설정</li><li>즉, 블록의 데이터가 설정된 비율 이상 채워졌을 때에만 해당 블록이 디스크에 기록됨<br>(기본값: 85, 범위: 0~99)</li></ul></td></tr></tbody></table>

#### **TCC 테이블 생성 명령어**

CREATE TABLE 명령을 수행할 때 아래의 옵션을 주어서 TCC 테이블을 만들 수 있습니다.

```
CREATE TABLE {table-name} COMPRESS FOR QUERY LOW
```

컬럼 압축 중에서는 OLTP성 업무로 인한 성능 손실을 최대한 막을 수 있는 레벨입니다.

```
CREATE TABLE {table-name} COMPRESS FOR QUERY HIGH
```

중간 정도의 압축 레벨입니다. 압축/해제의 성능도 중간 정도입니다.

```
CREATE TABLE {table-name} COMPRESS FOR ARCHIVE LOW
```

더 높은 압축 레벨입니다. 압축/해제의 성능은 다소 떨어집니다.

```
CREATE TABLE {table-name} COMPRESS FOR ARCHIVE HIGH
```

최대 압축률입니다. 압축/해제의 성능도 제일 낮습니다.

{% hint style="info" %}
**참고**

컬럼 압축이 아닌 기존의 기본 압축 방식을 적용하기 위해서는 COMPRESS까지만 설정합니다.
{% endhint %}

아래는 옵션을 사용한 예입니다.

```
CREATE TABLE T(A NUMBER) COMPRESS FOR QUERY HIGH
```

#### **TCC 사용 주의사항**

TCC는 row-oriented 저장 구조에 비해 장점만 있는 것은 아니기 때문에 잘못 사용하면 성능에 큰 손실을 입을 수 있습니다. 아래와 같은 경우는 주의해야 합니다.

**Update(또는 Delete)가 빈번하게 발생하는 테이블**

TCC로 저장된 테이블에 update가 수행되면, 압축이 해제되고 해당 row는 row-oriented로 변경됩니다. 또한 많은 경우에 row 단위로 읽어들일 때보다 많은 블록을 읽어들여야 합니다. 예를 들어 UPDATE SET A=1, B=2 WHERE C=3을 처리할 때에 row-oriented로 저장되어 있으면 한 블록만 읽으면 되지만, TCC로 저장되어 있으면 세 CU를 읽어들여야 합니다.

CC\_CU\_BLKCNT가 클 경우 다음과 같은 상황에서 더욱 문제가 될 수 있습니다. 하나의 row를 처리하기 위해 각 CU마다 CC\_CU\_BLKCNT만큼의 블록 I/O가 필요해집니다. 따라서 압축 효율에 큰 차이가 없다면 적정 수준의 CC\_CU\_BLKCNT를 사용하는 것이 좋습니다.

**인덱스를 통한 접근이 많은 테이블**

인덱스를 통한 접근 시 항상 CU 단위로 압축을 해제합니다. (단, 연속된 rowid에 대해서는 압축 해제된 내용을 재사용합니다. 각각의 Row마다 항상 압축을 해제하는 것은 아닙니다.) 따라서 인덱스를 통해 접근할 때에는 압축 해제가 많이 발생할 수 있기 때문에 성능이 떨어진다는 것을 염두에 두어야 합니다.

인덱스를 통한 접근과 같이, TCC 저장방식은 row 단위로 접근하는 모든 경우에 비효율적입니다.<br>

TCC 사용 시 다음의 제약조건을 유의합니다.

* TCC가 걸린 테이블에 drop column, set unused column, rowid를 사용하는 table redefinition이 불가능합니다.
* TCC가 걸린 테이블에 bitmap index 생성이 불가능합니다.
* LOB, LONG, XML, 사용자 정의형(nested table, varray, object 등) column type이 존재하는 테이블에 TCC 사용이 불가능합니다.
* 암호화된 테이블에 DPI를 수행하면 압축되지 않습니다.
* TCC가 걸린 테이블에 Merge, Split partition 수행 시 Update Global Indexes(UGI), Update Indexes(UI) 사용이 불가능합니다.

### OLTP COMPRESS

Tibero는 OLTP 환경에서 Direct Path Load/Insert가 아닌 일반 DML이 발생하는 테이블에 대한 압축 기능을 제공합니다.

일반 compression 방식은 Direct Path Insert/Load 작업 시에만 데이터 압축이 가능하며 압축된 데이터에 대한 DML 시 압축을 해제하는 반면, OLTP compression 기능을 사용하면 일반적인 DML 작업이 발생한 테이블에 대해서도 압축을 수행하여 압축 효과를 유지할 수 있습니다. 테이블 데이터 블록의 공간 사용률 및 압축률이 특정 threshold 값 이하일 때 해당 데이터 블록에서 중복된 데이터를 제거하는 방식으로 압축을 수행합니다.

#### **OLTP COMPRESS 대상**

OLTP COMPRESS는 테이블과 파티션, 서브 파티션에 대해 가능합니다. 파티션과 서브 파티션 각각에 대해 압축 유무를 지정할 수 있습니다. 즉, 한 파티션은 압축하고 한 파티션은 압축하지 않은 상태로 테이블을 생성할 수 있습니다.

**\[예 12] OLTP COMPRESS 옵션이 지정된 테이블 생성**

```
CREATE TABLE EMP (
     EMPNO DECIMAL(4),
     ENAME VARCHAR(10),
     JOB VARCHAR(9),
     MGR DECIMAL(4),
     HIREDATE VARCHAR(14),
     SAL NUMBER(7,2),
     COMM NUMBER(7,2),
     DEPTNO NUMBER(2))
     COMPRESS FOR OLTP;

```

**\[예 13] 파티션별 OLTP COMPRESS 옵션을 지정하는 테이블 생성**

```
CREATE TABLE EMP (
     EMPNO DECIMAL(4),
     ENAME VARCHAR(10),
     JOB VARCHAR(9),
     MGR DECIMAL(4),
     HIREDATE VARCHAR(14),
     SAL NUMBER(7,2),
     COMM NUMBER(7,2),
     DEPTNO NUMBER(2))
     COMPRESS FOR OLTP
     PARTITION BY RANGE(EMPNO)
 (
     PARTITION EMP_PART1 VALUES LESS THAN(500),
     PARTITION EMP_PART2 VALUES LESS THAN(1000) NOCOMPRESS,
     PARTITION EMP_PART3 VALUES LESS THAN(1500),
     PARTITION EMP_PART4 VALUES LESS THAN(2000) NOCOMPRESS,
     PARTITION EMP_PART5 VALUES LESS THAN(MAXVALUE));
```

#### **테이블의 OLTP COMPRESS 옵션 확인**

\*\_TABLES, \*\_TBL\_PARTITIONS 정적 뷰를 쿼리해 보면 테이블의 OLTP COMPRESS 옵션 적용 유무를 알 수 있습니다. COMPRESS\_FOR 옵션이 'ADVANCED'인 경우 OLTP COMPRESS 기능을 사용하는 테이블입니다.

**\[예 14] 테이블의 압축 상태 확인**

```
select table_name, compression from user_tables;

TABLE_NAME      COMPRESSION
--------------- -----------
EMP             YES
```

#### **OLTP COMPRESS** 옵션

테이블에 대해 지정할 수 있는 OLTP COMPRESS 옵션은 다음과 같습니다.

<table><thead><tr><th width="316">옵션명</th><th>설명</th></tr></thead><tbody><tr><td>COMPRESS FOR OLTP</td><td>Direct Path Insert/Load가 아닌 일반 DML에 대해서만 테이블을 압축</td></tr><tr><td>ROW STORE COMPRESS ADVANCED</td><td>COMPRESS FOR OLTP와 동일하며, 마찬가지로 Direct Path Insert/Load가 아닌 일반 DML에 대해서만 테이블을 압축</td></tr><tr><td>COMPRESS FOR ALL OPERATIONS</td><td>Direct Path Insert/Load와 일반 DML에 대해서 테이블을 압축</td></tr></tbody></table>

#### **기존 테이블 압축 옵션 변경**

ALTER TABLE MOVE 문을 이용하면 기존 테이블에 대한 압축을 변경할 수 있습니다. 파티션을 가진 테이블의 경우 테이블 자체가 아닌 파티션 단위로 MOVE를 수행해야 합니다.

**\[예 15] 기존 테이블에 대한 압축을 변경하는 예**

```
CREATE TABLE TBL_COMP (C1 NUMBER) COMPRESS;
ALTER TABLE TBL_COMP MOVE COMPRESS FOR OLTP;
ALTER TABLE TBL_COMP MOVE COMPRESS FOR ALL OPERATIONS;
```

ALTER TABLE 문을 이용하여 OLTP COMPRESS 옵션을 지정할 경우, 이후 수행되는 DML에 대해서 압축을 수행하도록 할 수 있습니다.

단, ALTER TABLE 구문을 수행한 시점에서 기존 데이터에 대한 압축이 수행되지는 않습니다.

**\[예 16] 테이블의 추가적인 DML에 대한 압축을 변경하는 예**

```
CREATE TABLE EMP (C1 NUMBER);
INSERT INTO EMP SELECT LEVEL FROM DUAL CONNECT BY LEVEL <= 1000;
COMMIT;
ALTER TABLE EMP COMPRESS FOR OLTP;
```

### INDEX ORGANIZED TABLE

**INDEX ORGANIZED TABLE**은 인덱스의 B-TREE 구조를 이용해 데이터를 저장하는 형태의 테이블을 말합니다. 일반적인 테이블에서는 데이터가 로우 단위로 무작위로 블록에 저장되지만, INDEX ORGANIZED TABLE은 인덱스와 유사한 형태로 기본 키를 기준으로 로우가 정렬되어 인덱스 리프 블록에 저장됩니다.

로우가 너무 크거나 지역 효율성을 위해 특정 컬럼부터는 데이터 영역에 저장할 수도 있습니다. 이를 오버플로우 데이터 영역이라고 합니다.

INDEX ORGANIZED TABLE은 다음과 같은 장점을 가집니다.

* 기본 키를 랜덤 액세스할 때 기본 키를 기준으로 정렬되어 있으므로 일반 테이블보다 더욱 빠릅니다. 일반 테이블에서 인덱스가 있는 경우라도 기본 키를 인덱스에서 찾고 로우 ID로 다시 해당 로우를 찾아야 합니다. 하지만 INDEX ORGANIZED TABLE에서는 인덱스 영역에서 해당 로우를 바로 찾을 수 있기 때문에 추가적인 디스크 검색이 불필요하기 때문입니다.<br>
* 인덱스와 데이터 영역에 기본 키가 중복 저장되지 않으므로 스토리지 사용량이 줄어듭니다.<br>

단, 잦은 수정이 발생할 경우 인덱스를 재구조화하는 부담이 생기므로 DML이 자주 발생하는 환경에서는 적합하지 않을 수 있습니다. INDEX ORGANIZED TABLE은 기본 키로 전체 로우가 정렬되어 저장되므로 다른 키로 인덱스를 만들고자 하는 경우 SECONDARY INDEX를 만들 수 있습니다.

#### **INDEX ORGANIZED TABLE** 생성

INDEX ORGANIZED TABLE은 CREATE TABLE 문 뒤에 ORGANIZATION INDEX 구문을 덧붙여 생성할 수 있습니다. 이때 반드시 기본 키(primary key) 선언을 해주어야 합니다.

추가로 줄 수 있는 파라미터는 다음과 같습니다.

<table><thead><tr><th width="188">파라미터 (옵션명)</th><th>설명</th></tr></thead><tbody><tr><td>OVERFLOW</td><td><ul><li>INDEX ORGANIZED TABLE 로우의 크기 제한을 넘어서거나 INCLUDING 이후의 컬럼들은 OVERFLOW 데이터 영역에 저장됨</li><li>이때 사용자가 원하는 테이블 스페이스를 줄 수 있음</li></ul></td></tr><tr><td>INCLUDING</td><td><ul><li><code>INCLUDING</code>으로 선언된 컬럼 이후부터는 무조건 OVERFLOW 데이터 영역에 저장됨</li><li><code>INCLUDING</code>은 기본 키의 마지막 컬럼이나 기본 키가 아닌 임의의 컬럼을 지정할 수 있음</li></ul></td></tr><tr><td>PCTTHRESHOLD</td><td><ul><li>블록 크기를 기준으로 INDEX ORGANIZED TABLE의 인덱스 영역에 들어갈 수 있는 로우의 최대 크기 비율을 말함</li><li>INCLUDING을 지정하지 않은 경우 PCTTHRESHOLD 범위를 넘는 컬럼부터 OVERFLOW 데이터 영역에 저장됨</li><li>INCLUDING을 지정한 경우라도 INCLUDING이 지정된 이전의 컬럼까지의 크기 합이 PCTTHRESHOLD 범위를 넘어서게 되면 OVERFLOW 데이터 영역에 저장됨</li></ul></td></tr></tbody></table>

**\[예 17] INDEX ORGANIZED TABLE 생성**

```
CREATE TABLE TBL_IOT
(
        COL1 NUMBER,
        COL2 VARCHAR2(20),
        COL3 VARCHAR2(10),
        COL4 VARCHAR2(10),
        PRIMARY KEY (COL1, COL2)
)
ORGANIZATION INDEX

PCTTHRESHOLD 40
OVERFLOW;
```

INDEX ORGANIZED TABLE을 생성할 때 다음의 제약조건을 유의합니다.

* LOB이나 LONG은 포함할 수 없고 VIRTUAL COLUMN을 생성할 수 없습니다.
* PRIMARY INDEX는 UNUSABLE이 불가능합니다. SECONDARY INDEX는 UNUSABLE이 가능합니다.
* 컬럼의 최대 개수는 1000개입니다.
* REVERSE, BITMAP, DOMAIN INDEX를 SECONDARY INDEX로 생성할 수 없습니다.
* 인덱스 영역에는 최대 255개의 컬럼만 저장할 수 있습니다. 컬럼 개수가 그 이상이거나 인덱스 영역에 다 저장할 수 없는 경우 OVERFLOW를 지정해야 합니다.
* PCTTHRESHOLD의 값은 1-50입니다. 하지만 실제 인덱스 영역에 저장할 수 있는 로우의 최대 크기는 구조적인 문제로 블록의 50%보다 더 작습니다.
* 모든 컬럼은 PCTTHRESHOLD보다 작아야 합니다.
* COMPOSITE PARTITIONING이 불가능합니다.
* PARTITION MODIFY, MOVE, RENAME, SPLIT, MERGE가 불가능합니다.
* TABLE COMPRESS가 불가능합니다.
* TABLE을 생성한 후 ALTER TABLE PROPERTY 시에는 ADD/DROP SUPPLEMENTAL LOG만 가능합니다.

#### **INDEX ORGANIZED TABLE** 삭제

DROP TABLE 구문으로 삭제할 수 있습니다.

**\[예 18] INDEX ORGANIZED TABLE 삭제**

```
DROP TABLE TBL_IOT;
```

## 제약조건

제약조건(Constraints)은 사용자가 원하지 않는 데이터가 테이블의 컬럼에 삽입, 변경, 제거되는 것을 방지하는 방법입니다.

### 제약조건 선언, 변경, 제거

본 절에서는 제약조건을 선언하고 변경, 제거하는 방법을 설명합니다.

테이블을 생성할 때 제약조건을 선언하는 방법은 다음과 같습니다.

<table><thead><tr><th width="128">제약조건</th><th>설명</th></tr></thead><tbody><tr><td>기본 키</td><td><ul><li>무결성 제약조건과 고유 키 무결성 제약조건을 결합한 방법</li><li>기본 키로 설정된 컬럼은 NULL 값을 가질 수 없음</li></ul></td></tr><tr><td>유일 키</td><td><ul><li>테이블의 컬럼은 동일한 값을 가질 수 없음</li><li>대신 NULL 값은 여러 행에 입력할 수 있음</li></ul></td></tr><tr><td>참조 무결성</td><td>다른 테이블이나 현재 사용자가 소유한 테이블의 기본 키나 유일 키를 참조할 때 사용하는 방법</td></tr><tr><td>NOT NULL</td><td>테이블의 컬럼은 NULL 값을 가질 수 없음. 테이블 레벨의 제약조건은 설정할 수 없음</td></tr><tr><td>CHECK</td><td><ul><li>삽입 또는 변경할 값이 만족해야 할 제약조건을 설정</li><li>한 컬럼에 여러 개의 제약조건을 설정할 수 있음</li></ul></td></tr></tbody></table>

#### **제약조건 선언**

제약조건은 삭제 가능성, 제약조건에 포함되는 컬럼의 개수 등에 따라 선택적으로 선언할 수 있습니다. 제약조건을 어떻게 선언하든 테이블 내에서 미치는 영향은 동일합니다. 제약조건을 선언한 후 정의 또는 상태를 변경하기 위해서는 제약조건을 선언할 때 제약조건의 이름을 설정해야 합니다.

제약조건의 이름을 지정해야 변경할 수 있습니다. 제약조건에 이름을 설정하려면 제약조건을 선언할 때 예약어 **CONSTRAINT**와 제약조건 이름을 추가로 정의해야 합니다.

다음은 \[예 1]에서 선언한 제약조건에 이름을 설정하는 예입니다.

**\[예 19] 제약조건의 이름 설정**

```
CREATE TABLE DEPT
(
        DEPTNO      NUMBER PRIMARY KEY,
        DEPTNAME    VARCHAR(20),
        PDEPTNO     NUMBER
)
TABLESPACE my_space
PCTFREE 5 INITRANS 3;


CREATE TABLE EMP
(
      EMPNO       NUMBER        CONSTRAINT EMP_PRI_KEY PRIMARY KEY,
      ENAME       VARCHAR(16)   NOT NULL,
      ADDR        VARCHAR(24),
      SALARY      NUMBER,
      DEPTNO      NUMBER,
      
      CONSTRAINT  SALARY_MIN CHECK (SALARY >= 10000),
      CONSTRAINT  DEPTNO_REF FOREIGN KEY (DEPTNO) REFERENCES DEPT(DEPTNO)
)
TABLESPACE my_space
PCTFREE 5 INITRANS 3;

```

제약조건은 다음과 같은 경우에 따라 사용하는 문법이 다릅니다.

* 컬럼 단위로 제약조건을 선언하는 경우 컬럼의 정의와 함께 제약조건을 선언합니다.

<table><thead><tr><th width="166">제약조건</th><th>설명</th></tr></thead><tbody><tr><td>CHECK</td><td>문법이 동일</td></tr><tr><td>NOT NULL</td><td><ul><li>처음 선언할 때는 반드시 컬럼의 정의와 함께 선언되어야 함</li><li>선언된 이후에 변경할 경우 <strong>ALTER TABLE MODIFY</strong> 문을 사용</li></ul></td></tr></tbody></table>

다음은 컬럼 단위로 제약조건을 선언하는 예입니다. 본 예제에서는 컬럼 PROD\_ID, PROD\_NAME, PROD\_COST, PROD\_DATE 각각에 기본 키, NOT NULL 제약조건을 선언합니다.

**\[예 20] 제약조건의 선언 - 컬럼 단위**

```
CREATE TABLE TEMP_PROD
(
        PROD_ID     NUMBER(6)       CONSTRAINT PROD_ID_PK PRIMARY KEY,
        PROD_NAME   VARCHAR2(50)    CONSTRAINT PROD_NAME_NN NOT NULL,
        PROD_COST   VARCHAR2(30)    CONSTRAINT PROD_COST_NN NOT NULL,
        PROD_PID    NUMBER(6),
        PROD_DATE   DATE            CONSTRAINT PROD_DATE_NN NOT NULL
);
```

* 테이블 단위로 선언하는 경우\
  모든 컬럼을 정의한 후 제약조건을 선언합니다. 다음은 테이블 단위로 제약조건을 선언하는 예입니다. 두 개 이상의 컬럼에 제약조건을 선언하고자 한다면 반드시 모든 컬럼을 정의한 후 선언해야 합니다.

본 예제에서는 컬럼 PROD\_ID와 PROD\_NAME을 통합하여 기본 키 제약조건을 선언합니다.

**\[예 21] 제약조건의 선언 - 테이블 단위**

```
CREATE TABLE TEMP_PROD
(
        PROD_ID     NUMBER(6),
        PROD_NAME   VARCHAR2(50)    CONSTRAINT PROD_NAME_NN NOT NULL,
        PROD_COST   VARCHAR2(30)    CONSTRAINT PROD_COST_NN NOT NULL,
        PROD_PID    NUMBER(6),
        PROD_DATE   DATE            CONSTRAINT PROD_DATE_NN NOT NULL,
        CONSTRAINT PROD_ID_PK PRIMARY KEY (PROD_ID, PROD_NAME)
);
```

#### **제약조건 변경**

Tibero에서는 이미 선언된 제약조건을 변경할 수 있습니다. 제약조건은 ALTER TABLE 문에서 변경할 수 있습니다. 단, 변경할 수 있는 테이블에 한해서만 제약조건을 변경할 수 있습니다.

다음은 제약조건을 변경하는 예입니다.

* 제약조건의 이름을 변경하는 경우\
  ALTER TABLE 문의 **RENAME CONSTRAINT** 절을 삽입합니다. 제약조건의 이름을 변경할 때에는 테이블 내에서 유일해야 합니다.<br>

다음은 제약조건의 이름을 변경하는 예입니다.

**\[예 22] 제약조건의 변경 - 제약조건의 이름**

```
ALTER TABLE EMP
          RENAME CONSTRAINT EMP_PRI_KEY TO EMP_KEY;
```

* 제약조건을 새로 추가하는 경우\
  제약조건을 새로 추가하려면 ALTER TABLE 문의 **ADD** 절을 삽입해야 합니다. 사용하는 방법은 CREATE TABLE 문에서 컬럼을 정의한 후 제약조건을 선언하는 문법과 동일하게 ADD 절 다음에 제약조건을 선언합니다. 단, NOT NULL 제약조건의 경우에는 ADD 절이 아닌 MODIFY 절로 추가해야 합니다.<br>

다음은 각각 새로운 CHECK 제약조건과 UNIQUE 제약조건을 추가하는 예입니다.

**\[예 23] 제약조건의 변경 - 제약조건의 추가**

```
ALTER TABLE EMP
        ADD CONSTRAINT SALARY_MAX CHECK (SALARY >= 50000);

ALTER TABLE EMP
        ADD UNIQUE (ENAME, DEPTNO);

```

제약조건을 추가할 때 제약조건의 이름은 CHECK 제약조건의 예에서처럼 이름을 설정할 수도 있지만 선택적으로 설정하지 않을 수 있습니다. 컬럼의 이름을 변경하면 기존에 컬럼의 이름을 사용하던 제약조건은 Tibero 시스템에 의해 자동으로 변경됩니다. 예를 들어 \[예 3]처럼 SQL 문장을 실행하면 ADDR 컬럼에 설정된 제약조건을 ADDRESS 컬럼에 자동으로 적용합니다. 단, CHECK 제약조건의 경우 제대로 동작하지 않을 수 있으며 사용자가 ALTER TABLE 문으로 제약조건을 다시 정의해야 합니다.

#### **제약조건 제거**

제약조건을 제거하기 위해서는 ALTER TABLE 문에 **DROP** 절을 삽입해야 합니다. 기본 키, 유일 키 제약조건을 제외하고는 반드시 제약조건의 이름이 있어야 합니다. 제약조건을 선언할 때 제약조건의 이름을 명시하지 않으면 Tibero가 임의의 이름을 자동으로 생성해 줍니다.

제약조건의 이름을 설정하지 않은 경우 **USER\_CONSTRAINTS** 뷰에서 해당 제약조건의 이름을 확인하여 이를 변경 또는 제거할 수 있습니다.

다음은 제약조건을 제거하는 예입니다.

**\[예 24] 제약조건의 제거**

```
ALTER TABLE EMP
        DROP PRIMARY KEY;
-- ... 기본 키가 설정된 제약조건을 제거합니다. ...

ALTER TABLE EMP
        DROP CONSTRAINT SALARY_MAX;
-- ... 제약조건의 이름이 SALARY_MAX인 제약조건을 제거합니다. ...

```

### 제약조건 상태

제약조건의 상태는 다음과 같이 두 가지로 나뉩니다.

* **ENABLE**

테이블에 삽입 또는 갱신되는 모든 로우에 적용됩니다. ENABLE은 아래와 같이 두 가지 옵션을 추가적으로 사용할 수 있습니다.

<table><thead><tr><th width="139">옵션</th><th>설명</th></tr></thead><tbody><tr><td>VALIDATE</td><td><ul><li>제약조건이 설정되지 않은 상태에서 많은 수의 로우가 새로 삽입되거나 갱신될 때 로우가 제약조건을 만족하는지를 확인하는 옵션</li><li>가능하면 모든 로우를 한꺼번에 확인하는 것이 데이터베이스 성능 향상에 도움이 됨</li></ul></td></tr><tr><td>NOVALIDATE</td><td><ul><li>기존에 저장된 테이블의 로우가 제약조건에 만족하지 않아도 되거나 또는 모든 로우가 제약조건에 만족하는 경우에만 사용하는 옵션</li><li>테이블에 저장된 로우가 제약조건에 만족하는지 확인하지 않아도 되므로 데이터베이스 성능 향상에 도움이 됨</li><li>단, 기본 키 또는 유일 키 제약조건은 내부적으로 사용하는 인덱스의 특성상 NOVALIDATE 옵션을 사용한다고 해도 무조건 VALIDATE로 동작</li></ul></td></tr></tbody></table>

* **DISABLE**

ENABLE과는 반대의 경우로 선언된 제약조건을 적용하지 않습니다. 한꺼번에 많은 수의 로우를 테이블에 삽입하거나 갱신하는 경우 제약조건을 DISABLE 상태로 하여 작업을 마친 후 제약조건을 다시 ENABLE 상태로 설정하는 것이 데이터베이스 성능 향상에 도움이 됩니다.

tbLoader 또는 tbImport 유틸리티나 배치 프로그램을 통해 많은 수의 로우를 삽입하거나 갱신할 수 있습니다. 테이블에 저장된 로우가 제약조건을 만족하는지 확인하지 않아도 되므로 데이터베이스 성능 향상에 도움이 됩니다.

DISABLE은 아래와 같이 두 가지 옵션을 추가적으로 사용할 수 있습니다.

<table><thead><tr><th width="164">옵션</th><th>설명</th></tr></thead><tbody><tr><td>VALIDATE</td><td>이 옵션을 사용하는 경우 제약조건에 걸려 있는 인덱스를 드롭하고 해당 제약조건 컬럼을 변경할 수 없음</td></tr><tr><td>NOVALIDATE</td><td>사용자가 옵션을 입력하지 않으면 기본적으로 적용되는 옵션</td></tr></tbody></table>

### **제약조건 상태 변경**

제약조건의 상태를 변경하기 위해서는 **ALTER TABLE** 문을 사용해야 합니다.

다음은 제약조건의 상태를 변경하는 예입니다.

* ENABLE 상태로 변경하는 경우

**\[예 25] 제약조건의 상태 변경 - ENABLE**

```
ALTER TABLE EMP MODIFY CONSTRAINT EMP_UNIQUE ENABLE;
```

* DISABLE 상태로 변경하는 경우

**\[예 26] 제약조건의 상태 변경 - DISABLE**

```
ALTER TABLE EMP MODIFY PRIMARY KEY DISABLE;
```

* NOVALIDATE로 추가한 제약조건을 다시 VALIDATE로 변경하는 경우

**\[예 27] 제약조건의 상태 변경 - VALIDATE**

```
ALTER TABLE EMP MODIFY CONSTRAINT SALARY_MIN ENABLE VALIDATE;
```

### 제약조건 정보 조회

Tibero에서는 제약조건의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다. DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="226">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_CONSTRAINTS</td><td>Tibero 내의 모든 제약조건의 정보를 조회하는 뷰</td></tr><tr><td>USER_CONSTRAINTS</td><td>현재 사용자에 속한 제약조건의 정보를 조회하는 뷰</td></tr><tr><td>ALL_CONSTRAINTS</td><td>사용자가 접근 가능한 제약조건의 정보를 조회하는 뷰</td></tr><tr><td>DBA_CONS_COLUMNS</td><td>Tibero 내의 모든 제약조건에 적용된 컬럼 정보를 조회하는 뷰</td></tr><tr><td>USER_CONS_COLUMNS</td><td>현재 사용자에 속한 제약조건에 적용된 컬럼 정보를 조회하는 뷰</td></tr><tr><td>ALL_CONS_COLUMNS</td><td>사용자가 접근 가능한 제약조건에 적용된 컬럼 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**

정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}

## 디스크 블록

디스크 블록은 데이터를 저장하는 물리적인 최소 단위이며 크기가 일정합니다. Tibero에서는 디스크 블록을 효율적으로 사용할 수 있도록 스키마 객체별로 파라미터를 제공합니다. 스키마 객체의 특성에 따라 파라미터를 설정하면, 데이터베이스 성능의 향상과 저장 공간의 활용도를 높일 수 있습니다.

### **PCTFREE** 파라미터

**PCTFREE**는 디스크 블록에 저장된 스키마 객체의 갱신에 대비하여 얼마만큼의 여유 공간을 남길 것인가를 설정하는 파라미터입니다.

퍼센트 값으로 표현하며 1에서 99 사이의 임의의 정수로 설정할 수 있습니다. 디스크 블록의 여유 공간이 PCTFREE 파라미터에 설정한 값 이하로 떨어질 때까지 계속 새로운 로우를 삽입합니다. PCTFREE 파라미터에 설정한 값 이하인 경우에는 더 이상 새로운 로우를 삽입하지 않으며, 남은 공간은 기존 로우의 갱신에 대비하게 됩니다.

디스크 블록 내의 빈 공간이 PCTFREE 파라미터의 값보다 작아지면, 디스크 블록 내의 객체를 삭제합니다. 빈 공간이 PCTFREE 파라미터의 값보다 커지더라도 바로 새로운 객체를 삽입하지는 않습니다. 이후에 충분한 공간이 생겼을 때 디스크 블록에 삽입됩니다.

현재 디스크 블록에 저장된 객체가 갱신되어 크기가 증가할 가능성이 있는 경우 PCTFREE 파라미터의 값을 크게 설정해야 합니다. 이때, PCTFREE 값이 작은 경우와 비교하여 하나의 디스크 블록에 저장되는 객체의 수가 상대적으로 적어지므로, 같은 수의 객체를 저장하는 데에 더 많은 디스크 블록을 필요로 하게 됩니다. 이러한 점은 데이터베이스 성능 저하의 원인이 될 수 있습니다.

반면에 하나의 객체를 여러 디스크 블록에 저장해야 하는 가능성이 적어지므로 성능 향상에 도움이 될 수도 있습니다. 따라서 PCTFREE 파라미터의 값은 데이터베이스를 운용하며 적절하게 설정해야 하며, 객체의 갱신이 많이 발생하는 경우에는 PCTFREE 파라미터의 값을 크게 잡는 것이 좋습니다. 디폴트로 설정될 PCTFREE 파라미터의 값은 10%입니다.

디스크 블록을 액세스하는 트랜잭션 내의 갱신 연산이 객체의 크기를 증가시키지 않거나 트랜잭션이 읽기 연산만으로 이루어져 있다면, PCTFREE 파라미터의 값을 매우 작게 설정할 수 있습니다. 예를 들어 PCTFREE 값을 5로 설정할 수 있습니다.

### **INITRANS** 파라미터

하나의 디스크 블록은 동시에 여러 트랜잭션에 접근할 수 있으며 디스크 블록에 포함되어 있는 각 로우는 자신을 마지막으로 생성, 갱신, 삭제한 트랜잭션의 정보를 가지고 있습니다. 이러한 트랜잭션의 데이터를 디스크 블록 내의 한 곳에 모아두는 것을 트랜잭션 엔트리 리스트(transaction entry list)라고 합니다.

트랜잭션 엔트리 리스트는 디스크 블록의 헤더에 포함되며 디스크 블록이 생성될 때 최초 크기는 **INITRANS** 파라미터에 설정된 값이 됩니다. 리스트 내의 트랜잭션 엔트리는 트랜잭션이 커밋되면 다른 트랜잭션에 의해 다시 사용할 수 있습니다.

예를 들어 더 많은 트랜잭션 엔트리가 필요한 경우에는 전체 리스트의 크기(트랜잭션 엔트리의 개수)를 하나씩 증가시킵니다. 이때 디스크 블록의 크기에 따라 트랜잭션 엔트리의 최대 개수가 정해집니다. 즉, 디스크 블록의 크기가 커질수록 트랜잭션 엔트리의 개수가 증가하게 됩니다. 단, 최대 255개를 초과하지 않아야 합니다.

트랜잭션 엔트리 개수가 최대 개수에 도달하면 더 이상 리스트의 크기를 증가시키지 않으며, 트랜잭션의 실행을 중지하고 대기합니다. 트랜잭션은 다른 트랜잭션이 끝나고 기존의 트랜잭션 엔트리를 다시 사용할 수 있게 되면 실행을 계속합니다.

트랜잭션 엔트리 리스트를 증가시키는 작업은 처리 비용이 필요하므로 자주 하지 않는 것이 좋습니다. 따라서, 하나의 디스크 블록을 여러 트랜잭션에서 액세스할 가능성이 높은 경우에는 INITRANS 파라미터의 값을 처음부터 높게 설정해 주는 것이 중요합니다. INITRANS 파라미터를 설정하지 않으면 기본값은 2입니다.

### 파라미터 설정

PCTFREE와 INITRANS 파라미터는 스키마 객체 단위로 설정할 수 있습니다. 스키마 객체는 항상 같은 파라미터의 값을 갖습니다. 파라미터는 스키마 객체를 생성하거나 변경할 때 설정할 수 있습니다.

다음은 테이블 EMP를 생성할 때 파라미터를 설정하는 예입니다.

```
CREATE TABLE EMP
(
        ENAME   VARCHAR(16) NOT NULL,
        ADDR    VARCHAR(24),
        SALARY  INT,
        DEPTNO  INT
)
PCTFREE     5
INITRANS    5;
```

디스크 블록 파라미터의 값을 변경하더라도 디스크 블록에는 바로 반영되지는 않습니다.

파라미터별로 디스크 블록에 반영되는 경우는 다음과 같습니다.

<table><thead><tr><th width="134">파라미터</th><th>설명</th></tr></thead><tbody><tr><td>PCTFREE</td><td>새로 객체를 삽입하고 삭제하는 경우 기존의 디스크 블록에 반영</td></tr><tr><td>INITRANS</td><td>기존의 디스크 블록에는 반영되지 않으며 새로 할당된 디스크 블록에만 반영</td></tr></tbody></table>

다음과 같이 파라미터는 **ALTER TABLE** 문을 이용하여 변경할 수 있습니다.

```
ALTER TABLE EMP PCTFREE 10;
```

인덱스를 생성할 때에는 INITRANS 파라미터의 값만 설정할 수 있습니다. 다음의 SQL 문장은 테이블 EMP의 인덱스를 생성할 때 파라미터를 설정하는 예입니다.

```
CREATE INDEX EMP_DEPTNO_IDX ON EMP (DEPTNO) INITRANS 5;
```

## 인덱스

인덱스(Index)는 테이블에서 원하는 데이터를 효율적으로 검색하기 위해 사용하는 데이터 구조입니다.

인덱스는 테이블과는 다른 스키마 객체이므로 독립적으로 생성, 변경, 제거, 저장할 수 있습니다.

다음은 인덱스의 종류입니다.

* 단일 컬럼 인덱스(Single Index)\
  하나의 컬럼으로 구성된 인덱스입니다.<br>
* 복합 컬럼 인덱스(Concatenated Index)\
  하나 이상의 컬럼으로 구성된 인덱스입니다.<br>
* 유일 인덱스(Unique Index)\
  테이블에서 유일한 값을 가진 컬럼으로 구성된 인덱스입니다.<br>
* 비유일 인덱스(Non-Unique Index)\
  중복되는 값을 인정하는 컬럼으로 구성된 인덱스입니다.<br>

### 인덱스 생성, 제거

Tibero는 기본 키, 유일 키 그리고 외래 키에 제약조건이 설정된 컬럼을 제외하고는 임의의 컬럼에 인덱스를 생성하거나 제거할 수 있습니다. 인덱스의 이름은 사용자가 별도로 지정하지 않으면 디폴트로 지정된 제약조건의 이름과 동일하게 생성됩니다.

#### **인덱스 생성**

인덱스를 생성하기 위해서는 **CREATE INDEX** 문을 사용해야 합니다. 인덱스는 다음과 같은 경우에 따라 생성, 제거 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 테이블에 인덱스를 생성하고 제거하는 경우 **CREATE INDEX** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 속한 테이블에 인덱스를 생성하고 제거하는 경우 **CREATE ANY INDEX** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 인덱스를 생성할 때 포함되는 구성요소입니다.

<table><thead><tr><th width="213">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>인덱스의 이름</td><td><ul><li>생성할 인덱스의 이름을 설정</li><li>테이블을 생성할 때 반드시 포함되어야 함</li></ul></td></tr><tr><td>테이블의 이름</td><td><ul><li>해당 컬럼이 속한 테이블의 이름을 설정</li><li>테이블을 생성할 때 반드시 포함되어야 함</li></ul></td></tr><tr><td>Unique</td><td><ul><li>Unique 인덱스 여부를 설정</li><li>인덱스를 생성할 때 선택적으로 사용할 수 있음</li></ul></td></tr><tr><td>컬럼 정의, 정렬 방향</td><td><ul><li>해당 컬럼을 정의하고 정렬 방향을 설정</li><li>인덱스를 생성할 때 선택적으로 사용할 수 있음</li></ul></td></tr><tr><td>테이블 스페이스</td><td><ul><li>인덱스가 저장될 테이블 스페이스를 설정</li><li>인덱스를 생성할 때 선택적으로 사용할 수 있음</li></ul></td></tr><tr><td>디스크 블록의 파라미터</td><td><ul><li>INITRANS 파라미터를 설정할 수 있음</li><li>인덱스를 생성할 때 선택적으로 사용할 수 있음</li></ul></td></tr><tr><td>파티션 인덱스</td><td><ul><li>파티션 인덱스를 설정할 수 있음</li><li>인덱스를 생성할 때 선택적으로 사용할 수 있음</li></ul></td></tr></tbody></table>

다음은 테이블 EMP의 컬럼 DEPTNO에 인덱스를 생성하는 예입니다. 인덱스의 이름은 'EMP\_FK'로 설정합니다.

**\[예 28] 인덱스의 생성**

```
CREATE INDEX EMP_FK ON EMP (DEPTNO);
```

#### **인덱스 제거**

인덱스를 제거하기 위해서는 **DROP INDEX** 문을 사용해야 합니다.

인덱스는 테이블처럼 독립적인 스키마 객체이므로 인덱스를 제거하더라도 테이블의 데이터에는 영향을 미치지 않습니다. 단, 인덱스를 제거하면 해당 컬럼의 데이터를 조회할 때 이전보다 조회 속도가 느려질 수도 있습니다. 인덱스가 더 이상 필요하지 않은 경우에는 제거하는 것이 데이터베이스 성능 향상에 도움이 됩니다.

다음은 \[예 28]에서 생성한 인덱스 'EMP\_FK'를 제거하는 예입니다.

**\[예 29] 인덱스의 제거**

```
DROP INDEX EMP_FK;
```

### 인덱스의 효율적인 관리

Tibero에서는 인덱스의 기본 구조로 B-TREE를 제공합니다. 이를 이용하여 단일 키 검색(single key search), 범위 검색(range search), 복합 키 검색(composite key search)을 수행할 수 있습니다.

**인덱스 검색 유형**

인덱스를 이용하여 테이블의 로우를 검색하는 방법은 다음과 같습니다.

**단일 키 검색(single key search)**

* 하나의 키를 갖는 로우를 검색하는 방법입니다.
* 인덱스가 유일 인덱스인 경우에는 하나의 키를 갖는 한 개의 로우만 검색되며, 비유일 인덱스의 경우에는 여러 개의 로우가 검색됩니다.<br>

**범위 검색(range search)**

* 검색 범위에 포함되는 키를 갖는 로우를 모두 검색하는 방법입니다.<br>

**복합 키 검색(composite key search)**

* 서로 다른 두 개 이상의 컬럼을 하나의 키로 조합하여 검색하는 방법입니다.<br>

다음은 복합 키를 이용하여 검색하는 예입니다.

**\[예 30] 복합 키 검색**

```
SELECT * FROM EMP
WHERE DEPTNO = 5 AND ADDR = 'Seoul';
```

위의 예제에서 컬럼 DEPTNO와 컬럼 ADDR가 별도의 인덱스로 생성되어 있다면, 원하는 로우를 검색하기 위해 먼저 **DEPTNO = 5**인 조건을 만족하는 로우와 ADDR = 'Seoul'인 조건을 만족하는 로우를 각각 검색하게 됩니다. 그 다음 두 조건에서 공통으로 포함하는 모든 로우를 출력하게 됩니다.

컬럼 DEPTNO와 컬럼 ADDR를 복합 키 인덱스로 생성하는 방법은 "DEPTNO+ADDR 또는 ADDR+DEPTNO" 형태로 조합하면 됩니다. 복합 키 인덱스를 생성하면 한꺼번에 원하는 로우를 검색할 수 있어 효율적입니다.

#### **인덱스의 효율적인 관리 지침**

인덱스를 효율적으로 관리하기 위한 지침은 다음과 같습니다.

* 인덱스가 필요한 테이블과 컬럼에만 생성합니다. 인덱스는 데이터 저장 공간과 데이터베이스 성능에 영향을 미칩니다. 인덱스를 생성하면 데이터를 저장하기 위한 별도의 공간이 필요하며 테이블에 로우가 삽입, 변경, 제거될 때마다 인덱스도 함께 갱신됩니다.<br>
* 기본 키가 적용된 컬럼과 함께 조인 연산의 대상이 되는 컬럼의 경우 인덱스를 생성한다는 것은 컬럼에 정렬을 수행한 결과를 저장한다는 의미입니다. Tibero에서는 정렬된 컬럼 간의 조인 연산을 더욱 효율적으로 수행합니다. 이러한 결과는 조인의 대상이 되는 테이블이 컸을 때 효과적입니다.<br>
* WHERE 절의 검색 조건에 포함되는 빈도가 높으며 검색 결과가 전체 테이블의 10% 이하인 컬럼의 경우 단일 키 검색의 경우 인덱스가 없으면 전체 테이블을 액세스합니다. 반면에 인덱스가 있으면 하나의 로우만 액세스하므로 검색 성능을 향상시킬 수 있습니다.<br>
* 복합 키 인덱스를 생성할 때 컬럼 값의 순서에 유의합니다. 검색 조건에 포함되는 빈도가 높은 컬럼부터 정렬합니다. 예를 들어 컬럼 C1과 컬럼 C2에 복합 키 인덱스를 생성할 때 인덱스 키를 만드는 방법은 (C1, C2)와 (C2, C1)의 두 가지가 있습니다.\
  컬럼 C1에 대한 검색이 컬럼 C2에 대한 검색보다 더 빈번하게 일어난다면 (C1, C2) 값을 이용하여 복합 키 인덱스를 생성하는 것이 유리합니다. 그 이유는 인덱스 내에서 같은 C1 값을 갖는 키들이 모여 있기 때문에 검색을 위해 액세스해야 할 디스크 블록의 개수가 적기 때문입니다. (C1, C2) 값으로 인덱스를 생성했다면 컬럼 C2에 대한 검색은 거의 사용할 수 없습니다.
* 사용 빈도가 낮거나 필요하지 않은 인덱스는 제거합니다.
* 하나의 테이블에 많은 수의 인덱스는 생성하지 않습니다.
* 시스템의 성능 향상을 위해 인덱스와 테이블은 서로 다른 디스크에 저장합니다.

### 인덱스 압축

Tibero는 인덱스 키를 구성하는 컬럼들을 공통 부분(Prefix)과 비공통 부분(Suffix)으로 나누어 공통 부분을 공유하는 방식으로 압축 기능을 제공합니다. 공통 부분에 해당하는 컬럼들을 따로 저장하고, 공통 부분에 접근할 수 있는 위치 정보와 비공통 부분을 합쳐 하나의 키로 사용합니다.

각각의 공통 부분은 모든 비공통 부분이 공유합니다.

새로운 키가 추가될 때, 기존에 만들어진 공통 부분을 사용할 수 없으면 새로운 공통 부분을 만들어 저장합니다. 따라서, DML이 빈번한 테이블에 속한 인덱스에 대해서 압축 기능을 사용하면 성능 저하가 있을 수 있습니다.

#### **인덱스 압축 시 제약 사항**

유일 인덱스(Unique Index)의 경우, 한 컬럼을 제외한 모든 컬럼을 압축 대상으로 선정할 수 있습니다. 모든 컬럼을 압축 대상으로 포함하면 중복이 없기 때문에 압축이 불가합니다. 따라서, 키를 구성하는 컬럼이 2개 이상 되어야 합니다.

비유일 인덱스(Non-Unique Index)는 모든 컬럼을 압축 대상으로 선정할 수 있으므로, 키를 구성하는 컬럼이 1개만 있어도 가능합니다.

압축 범위를 양수 N으로 명시한 경우, 첫 번째 컬럼부터 N개의 컬럼이 압축 대상이 됩니다.

압축 범위를 명시하지 않는 경우, 유일 인덱스는 마지막 컬럼을 제외한 모든 컬럼에 대해 압축을 수행합니다. 반면, 비유일 인덱스는 모든 컬럼이 압축 대상이 됩니다.

기존의 인덱스를 압축하거나 압축을 풀려면, ALTER 문을 통해서 수행할 수 없고, 기존의 인덱스를 DROP한 후에 CREATE 문을 통해 설정해야 합니다.

**\[예 31] 인덱스 압축 방법**

```
CREATE TABLE EMP
(
        EMPNO   NUMBER      NOT NULL,
        ENAME   VARCHAR(16) NOT NULL,
        ADDR    VARCHAR(24),
        SALARY  NUMBER,
        DEPTNO  NUMBER
);
* 볼드 처리된 컬럼은 정상적으로 압축된 대상을 의미합니다.

CREATE UNIQUE INDEX IDX1 ON EMP (EMPNO) COMPRESS 1;
TBR-7552: Cannot use COMPRESS option for a single column key


CREATE UNIQUE INDEX IDX1 ON EMP (EMPNO, ENAME) COMPRESS 2;
TBR-7551: Invalid COMPRESS prefix length value


CREATE UNIQUE INDEX IDX1 ON EMP (EMPNO, ENAME) COMPRESS;
Index 'IDX1' created.


CREATE INDEX IDX2 ON EMP (EMPNO, ENAME, ADDR) COMPRESS;
Index 'IDX2' created.


CREATE INDEX IDX3 ON EMP (SALARY, DEPTNO, ADDR) COMPRESS 0;
TBR-7551: Invalid COMPRESS prefix length value


CREATE INDEX IDX3 ON EMP (SALARY, DEPTNO, ADDR) COMPRESS 2;
Index 'IDX3' created.

```

**\[예 32] 인덱스 압축 상태 확인**

```
SELECT INDEX_NAME, UNIQUENESS, COMPRESSION
  FROM DBA_INDEXES
 WHERE TABLE_NAME = 'EMP';


INDEX_NAME  UNIQUENESS  COMPRESSION
----------  ----------  -----------
IDX1        UNIQUE       ENABLED
IDX2        NONUNIQUE    ENABLED
IDX3        NONUNIQUE    ENABLED
```

**\[예 33] 파티션 인덱스 압축 방법**

```
CREATE TABLE SALES
(
    SALES_NO   NUMBER,
    SALES_DATE DATE,
    PRICE      NUMBER
)
PARTITION BY RANGE (SALES_DATE)
(
    PARTITION SALES_P1 VALUES LESS THAN (TO_DATE('2019/01/01', 'YY/MM/DD')),
    PARTITION SALES_P2 VALUES LESS THAN (TO_DATE('2020/01/01', 'YY/MM/DD')),
    PARTITION SALES_P3 VALUES LESS THAN (TO_DATE('2021/01/01', 'YY/MM/DD')),
    PARTITION SALES_P4 VALUES LESS THAN (MAXVALUE)
);
CREATE INDEX IDX1 ON SALES(SALES_DATE) LOCAL COMPRESS;
Index 'IDX1' created.
```

### 인덱스 정보 조회

Tibero에서는 인덱스의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다. DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="209">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_INDEXES</td><td>Tibero 내의 모든 인덱스의 정보를 조회하는 뷰</td></tr><tr><td>USER_INDEXES</td><td>현재 사용자에 속한 인덱스의 정보를 조회하는 뷰</td></tr><tr><td>ALL_INDEXES</td><td>사용자가 접근 가능한 인덱스의 정보를 조회하는 뷰</td></tr><tr><td>DBA_IDX_COLUMNS</td><td>Tibero 내의 모든 인덱스에 적용된 컬럼의 정보를 조회하는 뷰</td></tr><tr><td>USER_IDX_COLUMNS</td><td>현재 사용자에 속한 인덱스에 적용된 컬럼의 정보를 조회하는 뷰</td></tr><tr><td>ALL_IDX_COLUMNS</td><td>사용자가 접근 가능한 인덱스에 적용된 컬럼의 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**\
정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}

### 인덱스 사용 여부 모니터링

Tibero에서는 인덱스의 사용 여부를 모니터링할 수 있는 기능을 제공하고 있습니다. 인덱스 모니터링의 결과는 V$OBJECT\_USAGE를 조회해서 알 수 있습니다.

다음은 인덱스 사용 여부를 모니터링하는 예입니다.

```
CREATE TABLE T (A NUMBER);
-- Table 'T' created.

CREATE INDEX I ON T(A);
-- Index 'I' created.

ALTER INDEX I MONITORING USAGE;
-- Index 'I' altered.

SELECT /*+ index(t i) */ * FROM T WHERE A > 0;
-- 0 rows selected.

SELECT USED FROM V$OBJECT_USAGE;
-- USED
-------
      Y
      
1 row selected.
```

## 뷰

**뷰(View)**&#xB294; SELECT 문으로 표현되는 질의에 이름을 부여한 가상 테이블입니다. SQL 문장 내에서 테이블과 동일하게 사용됩니다. 단, 실제 데이터를 포함하는 스키마 객체는 아니며 다른 스키마 객체를 통해 정의됩니다.

### 뷰 생성, 변경, 제거

본 절에서는 뷰를 생성, 변경, 제거하는 방법을 설명합니다.

#### **뷰 생성**

뷰를 생성하기 위해서는 **CREATE VIEW** 문을 사용해야 합니다. 뷰는 다음과 같은 경우에 따라 생성 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 뷰를 생성하는 경우 **CREATE VIEW** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 있는 뷰를 생성하는 경우 **CREATE ANY VIEW** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

모든 기반 객체(base objects)의 액세스 권한을 갖고 있어야 하며, 기반 테이블의 수에 상관없이 액세스 권한이 있어야 합니다.

예를 들면 다음과 같습니다.

**\[예 34] 뷰의 생성**

```
CREATE VIEW MANAGER AS
    SELECT * FROM EMP
    WHERE DEPTNO = 1;

CREATE VIEW EMP_DEPT AS
    SELECT  E.EMPNO,
            E.ENAME,
            E.SALARY,
            D.DEPTNO
    FROM    EMP E,
            DEPT D
    WHERE   E.DEPTNO = D.DEPTNO;

```

뷰를 이용하여 수행할 수 있는 연산은 기반 테이블에 대해 뷰 정의자가 수행할 수 있는 연산의 교집합입니다. 예를 들어 뷰 EMP\_DEPT를 정의한 사용자가 테이블 EMP에 대해 삽입, 제거 연산이 가능하고 테이블 DEPT에 대해 삽입, 갱신 연산이 가능하다면 뷰 EMP\_DEPT에 대해서는 삽입 연산만 할 수 있습니다.

뷰는 테이블과 같이 액세스 권한을 다른 사용자에게 부여할 수 있습니다. 단, 뷰를 정의한 기반 객체에 대한 GRANT OPTION 또는 ADMIN OPTION과 함께 액세스 권한을 부여받아야 합니다. 뷰에 대한 액세스 권한을 부여받은 사용자는 그 뷰를 정의한 기반 객체에 직접 액세스할 수 있는 권한이 없어도 그 뷰를 통하여 액세스할 수 있습니다. 단, 수행할 연산에 대한 권한은 뷰의 정의자가 가지고 있어야 합니다.

다음은 테이블을 생성하고 뷰를 생성하는 예입니다.

<pre><code>CREATE TABLE PRODUCT (
    PROD_ID NUMBER NOT NULL,
    PROD_NAME VARCHAR2(20),
    PROD_COST NUMBER,
    CONSTRAINT PK_PRODUCT PRIMARY KEY (PROD_ID)
);

<strong>CREATE VIEW V_PROD AS
</strong>    SELECT  PROD_ID, PROD_NAME, PROD_COST
    FROM    PRODUCT
    WHERE   PROD_ID = 100001;
</code></pre>

#### **뷰 변경**

뷰 또는 기반 객체의 변경으로 인해 사용할 수 없게 된 뷰를 다시 사용하기 위해서는 **CREATE OR REPLACE** **VIEW** 문을 사용해야 합니다. 단, 뷰를 생성하고 제거할 수 있는 권한이 있어야 합니다.

다음은 뷰를 변경하는 예입니다.

**\[예 35] 뷰의 변경**

```
CREATE OR REPLACE VIEW MANAGER AS
    SELECT *
    FROM    EMP
    WHERE   DEPTNO = 2;
```

위와 같은 SQL 문장을 실행하면 다른 사용자에게 부여한 뷰 MANAGER의 권한이 그대로 남아 있게 됩니다. 반면에 DROP VIEW와 CREATE VIEW 문을 연속으로 사용하면 뷰 MANAGER의 권한은 없어집니다.

#### **뷰 제거**

뷰를 제거하기 위해서는 **DROP VIEW** 문을 사용해야 합니다. 뷰는 다음과 같은 경우에 따라 제거 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 뷰를 제거하는 경우 **DROP VIEW** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 속한 뷰를 제거하는 경우 **DROP ANY VIEW** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 뷰를 제거하는 예입니다.

**\[예 36] 뷰의 제거**

```
DROP VIEW EMP_DEPT;
```

### 뷰 정보 조회

Tibero에서는 뷰의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다. DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="264">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_VIEWS</td><td>Tibero 내의 모든 뷰의 정보를 조회하는 뷰</td></tr><tr><td>USER_VIEWS</td><td>현재 사용자에 속한 뷰의 정보를 조회하는 뷰</td></tr><tr><td>ALL_VIEWS</td><td>사용자가 접근 가능한 뷰의 정보를 조회하는 뷰</td></tr><tr><td>DBA_UPDATABLE_COLUMNS</td><td>Tibero 내의 모든 뷰에 속한 컬럼의 갱신 가능성 정보를 조회하는 뷰</td></tr><tr><td>USER_UPDATABLE_COLUMNS</td><td>현재 사용자에 속한 뷰에 속한 컬럼의 정보를 조회하는 뷰.</td></tr><tr><td>ALL_UPDATABLE_COLUMNS</td><td>사용자가 접근 가능한 뷰에 속한 컬럼의 갱신 가능성 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**

정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}

## 시퀀스

시퀀스(Sequence)는 순차적으로 부여하는 고유번호입니다. 주로 새로운 데이터에 유일한 고유번호를 자동으로 부여할 때 사용합니다.

### 시퀀스 생성, 변경, 제거

본 절에서는 시퀀스를 생성, 변경, 제거하는 방법을 설명합니다.

시퀀스는 여러 개의 트랜잭션이 서로 겹치지 않는 고유번호를 만들어낼 때 사용됩니다.

시퀀스를 사용하지 않으면 고유번호를 만들어내기 위해서 마지막으로 사용된 번호를 기억하는 테이블을 만들고, 각 트랜잭션이 해당 값을 읽어서 하나씩 증가시켜야 합니다. 이러한 방법을 사용하면 고유번호를 생성하는 모든 트랜잭션 사이에 잠금(Lock)으로 인한 데이터 충돌이 발생하게 됩니다. 이로 인해 데이터베이스 성능이 저하되는 원인이 될 수 있습니다.

#### **시퀀스 생성**

시퀀스를 생성하기 위해서는 **CREATE SEQUENCE** 문을 사용해야 합니다. 시퀀스는 다음과 같은 경우에 따라 생성 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 시퀀스를 생성하는 경우 **CREATE SEQUENCE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 시퀀스를 생성하는 경우 **CREATE ANY SEQUENCE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 시퀀스를 생성할 때 포함되는 구성요소입니다.

<table><thead><tr><th width="160">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>시퀀스의 이름</td><td>시퀀스 이름 설정. 시퀀스를 생성할 때 반드시 포함되어야 함</td></tr><tr><td>MINVALUE</td><td>시퀀스가 생성할 수 있는 최솟값</td></tr><tr><td>MAXVALUE</td><td>시퀀스가 생성할 수 있는 최댓값</td></tr><tr><td>INCREMENT BY</td><td>시퀀스의 값을 사용할 때마다 얼마씩 증가 또는 감소할지를 설정</td></tr><tr><td>CACHE</td><td>데이터베이스 성능 향상을 위해 내부적으로 메모리에 값을 캐시</td></tr><tr><td>START WITH</td><td><ul><li>시퀀스를 가장 처음 사용할 때 생성되는 값을 설정</li><li>값을 설정하지 않으면 최솟값(감소할 경우에는 최댓값)으로 정의됨</li></ul></td></tr><tr><td>NOCYCLE</td><td><ul><li>시퀀스는 기본적으로 NOCYCLE로 정의되어 있음</li><li>최댓값(값이 감소할 경우에는 최솟값)에 도달하면 ALTER SEQUENCE 문을 사용하지 않는 한 새로운 값을 생성할 수 없음</li></ul></td></tr><tr><td>CYCLE</td><td>최댓값(최솟값)에 도달하면 자동으로 다음 값은 최솟값(최댓값)으로 순환</td></tr><tr><td>ORDER</td><td><ul><li>요청한 순서대로 시퀀스 결과가 나오도록 함</li><li>단 TAC 상에서만 의미가 있는 요소 (Single에서는 항상 순차적으로 값이 나옴)</li></ul></td></tr></tbody></table>

시퀀스는 데이터베이스 성능 향상을 위해 내부적으로 메모리에 값을 캐시합니다. MAX\_SEQ\_BUFFER 파라미터에 캐시의 크기를 지정하며 기본값은 20입니다.

시스템이 정상적으로 종료될 경우 캐시에 존재하지만 아직 실제로 쓰이지 않은 값은 디스크에 저장되어 다음 번 Tibero가 기동할 때 사용할 수 있습니다. 하지만 시스템이 비정상적으로 종료될 경우 캐시에 존재하던 값은 모두 사용된 것으로 간주되며 캐시의 최대 크기만큼 시퀀스의 값을 건너뛸 수 있습니다. 이러한 경우가 발생하지 않으려면 시퀀스를 **NOCACHE**로 선언해야 합니다. 하지만 시퀀스를 사용할 때마다 디스크 액세스가 일어나므로 데이터베이스 성능이 저하됩니다. 특수한 상황이 아니면 NOCACHE를 사용하지 않기를 권장합니다.

다음은 시퀀스를 생성하는 예입니다.

**\[예 37] 시퀀스의 생성**

```
CREATE SEQUENCE NEW_ID
    MINVALUE 1000
    MAXVALUE 9999
    INCREMENT BY 10
    CACHE 100
    NOCYCLE;
```

다음은 시퀀스의 값을 사용하는 예입니다.

```
CREATE TABLE EMP_ID (ID NUMBER, NAME VARCHAR(30));

INSERT INTO EMP_ID VALUES(NEW_ID.NEXTVAL, 'Peter');
```

시퀀스에 일단 사용된 값은 해당 트랜잭션이 롤백되거나 시스템이 비정상적으로 종료되어도 재사용되지 않습니다.

#### **시퀀스 변경**

시퀀스를 변경하기 위해서는 **ALTER SEQUENCE** 문을 사용해야 합니다. 시퀀스는 다음과 같은 경우에 따라 변경 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 시퀀스를 변경하는 경우 **ALTER SEQUENCE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 속한 시퀀스를 변경하는 경우 **ALTER ANY SEQUENCE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 시퀀스를 변경하는 예입니다.

**\[예 38] 시퀀스의 변경**

```
ALTER SEQUENCE NEW_ID
    MAXVALUE 99999
    INCREMENT BY 1
    CACHE 200;

```

```
SQL> CREATE SEQUENCE S1 START WITH 10 INCREMENT BY 1;
created

SQL> ALTER SEQUENCE S1 INCREMENT BY 5;
altered

SQL> SELECT S1.NEXTVAL FROM DUAL;

   NEXTVAL
-----------
         14

1 row selected.

```

#### **시퀀스 제거**

시퀀스를 제거하기 위해서는 **DROP SEQUENCE** 문을 사용해야 합니다. 시퀀스는 다음과 같은 경우에 따라 제거 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 시퀀스를 제거하는 경우 **DROP SEQUENCE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 속한 시퀀스를 제거하는 경우 **DROP ANY SEQUENCE** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 시퀀스를 제거하는 예입니다.

**\[예 39] 시퀀스의 제거**

```
DROP SEQUENCE NEW_ID;
```

### 시퀀스 정보 조회

Tibero에서는 시퀀스의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다. DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="200">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_SEQUENCES</td><td>Tibero 내의 모든 시퀀스의 정보를 조회하는 뷰</td></tr><tr><td>USER_SEQUENCES</td><td>현재 사용자에 속한 시퀀스의 정보를 조회하는 뷰</td></tr><tr><td>ALL_SEQUENCES</td><td>사용자가 접근 가능한 시퀀스의 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**

정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}

## 동의어

동의어(Synonym)는 스키마 객체의 별칭(Alias)입니다. 단, 실제 데이터를 포함하는 스키마 객체는 아니며 다른 스키마 객체를 통해 정의됩니다.

### 동의어 생성, 제거

본 절에서는 동의어를 생성, 제거하는 방법을 설명합니다.

#### **동의어 생성**

동의어를 생성하기 위해서는 **CREATE SYNONYM** 문을 사용해야 합니다. 동의어는 다음과 같은 경우에 따라 생성 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 동의어를 생성하는 경우 **CREATE SYNONYM** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 동의어를 생성하는 경우 **CREATE ANY SYNONYM** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 동의어를 생성할 때 포함되는 구성요소입니다.

<table><thead><tr><th width="157">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>동의어의 이름</td><td>동의어 이름 설정. 동의어를 생성할 때 반드시 포함되어야 함</td></tr><tr><td>테이블의 이름</td><td>동의어를 적용할 테이블 이름 설정. 동의어를 생성할 때 반드시 포함되어야 함</td></tr></tbody></table>

다음은 동의어를 생성하는 예입니다.

**\[예 40] 동의어의 생성**

```
CREATE SYNONYM T1 FOR U1.EMP;
```

#### **동의어 제거**

정의된 동의어를 변경하기 위해서는 먼저 동의어를 제거하고 다시 생성해야 합니다. 동의어를 제거하기 위해서는 **DROP SYNONYM** 문을 사용해야 합니다.

동의어는 다음과 같은 경우에 따라 제거 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 동의어를 제거하는 경우 **DROP SYNONYM** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 속한 동의어를 제거하는 경우 **DROP ANY SYNONYM** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 동의어를 제거하는 예입니다.

**\[예 41] 동의어의 제거**

```
DROP SYNONYM T1;
```

### 공용 동의어 생성, 제거

본 절에서는 공용 동의어를 생성, 제거하는 방법을 설명합니다.

#### **공용 동의어 생성**

동의어를 모든 사용자가 액세스할 수 있도록 생성할 수 있습니다. 이를 공용 동의어(PUBLIC SYNONYM)라고 합니다. 공용 동의어는 Tibero에서 정의하고 있는 PUBLIC이라는 특수한 사용자가 소유하는 동의어입니다.

공용 동의어를 생성하기 위해서는 **CREATE PUBLIC SYNONYM** 문을 사용해야 합니다.

다음은 공용 동의어를 생성할 때 포함되는 구성요소입니다. 각 구성요소는 공용 동의어를 생성할 때 반드시 포함되어야 합니다.

<table><thead><tr><th width="188">구성요소</th><th>설명</th></tr></thead><tbody><tr><td>공용 동의어의 이름</td><td>공용 동의어의 이름을 설정</td></tr><tr><td>테이블의 이름</td><td>공용 동의어를 적용할 테이블의 이름을 설정</td></tr></tbody></table>

다음은 공용 동의어를 생성하는 예입니다.

**\[예 42] 공용 동의어의 생성**

```
CREATE PUBLIC SYNONYM PUB_T1 FOR U1.EMP;
```

동의어는 객체 참조 방법의 편의성과 투명성(transparency)을 제공합니다. 예를 들어 현재 사용자가 아닌 다른 사용자가 U1이 소유한 테이블 EMP를 접근하려고 하면 매번 U1.EMP라고 입력해야 합니다. 하지만 공용 동의어를 정의하면 PUB\_T1만 입력하면 됩니다.

예를 들어 다음의 두 SQL 문장은 같은 결과를 반환합니다.

```
SELECT EMPNO, ENAME, ADDR FROM PUB_T1;

SELECT EMPNO, ENAME, ADDR FROM U1.EMP;
```

하나의 테이블을 액세스하는 애플리케이션 프로그램에서 다른 테이블을 액세스하는 동의어를 사용하는 경우 프로그램 내에서 액세스하는 테이블의 이름을 모두 변경하는 대신 정의된 동의어를 변경하는 것으로도 충분합니다.

#### **공용 동의어 제거**

공용 동의어를 제거하려면 **DROP PUBLIC SYNONYM** 문을 사용해야 합니다.

단, DROP PUBLIC SYNONYM 시스템 특권이 있어야 합니다.

다음은 공용 동의어를 제거하는 예입니다.

**\[예 43] 공용 동의어의 제거**

```
DROP PUBLIC SYNONYM PUB_T1;
```

### 동의어 정보 조회

Tibero에서는 동의어의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다. DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="192">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_SYNONYMS</td><td>Tibero 내의 모든 동의어의 정보를 조회하는 뷰</td></tr><tr><td>USER_SYNONYMS</td><td>현재 사용자에 속한 동의어의 정보를 조회하는 뷰</td></tr><tr><td>ALL_SYNONYMS</td><td>사용자가 접근 가능한 동의어의 정보를 조회하는 뷰</td></tr><tr><td>PUBLICSYN</td><td>모든 공용 동의어의 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**

정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}

## 트리거

트리거(Trigger)는 테이블의 로우를 삽입, 변경, 삭제할 때 자동으로 수행되도록 미리 지정해 놓은 PSM(Persistent Store Module) 프로시저입니다. 제약조건으로 표현하기 어려운 데이터베이스의 논리적 조건을 표현할 때 사용합니다. 예를 들어 사용자 계정별로 테이블에 삽입할 수 있는 값의 범위를 다르게 제한하고 싶을 때 트리거를 사용할 수 있습니다.

### 트리거 생성, 제거

본 절에서는 트리거를 생성, 제거하는 방법을 설명합니다.

#### **트리거 생성**

트리거를 생성하기 위해서는 **CREATE TRIGGER** 문을 사용해야 합니다. 트리거는 삽입, 변경, 삭제 연산을 수행하기 직전이나 직후에 수행할 수 있습니다.

트리거는 다음과 같은 경우에 따라 생성 요건이 다릅니다.

* 현재 사용자가 자신의 스키마에 속한 트리거를 생성하는 경우 **CREATE TRIGGER** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.
* 다른 사용자의 스키마에 속한 트리거를 생성하는 경우 **CREATE ANY TRIGGER** 문을 사용할 수 있는 시스템 특권이 있어야 합니다.

다음은 EMP 테이블에 새로운 로우를 삽입한 직후에 트리거를 수행하는 예입니다.

**\[예 44] 트리거의 생성**

```
CREATE TRIGGER TRG1
    AFTER INSERT ON EMP
    FOR EACH ROW
    WHEN (TRUE)
    BEGIN
             --- PSM BLOCK ---
END;

```

생성된 트리거는 트리거를 생성한 사용자의 권한을 가지고 동작합니다.

{% hint style="info" %}
**참고**

트리거에 대한 자세한 내용은 "[Tibero SQL 참조 안내서](/tibero-manuals/7.2.6.manuals/sql-reference-guide.md)"를 참고합니다.
{% endhint %}

#### **트리거 제거**

트리거를 제거하기 위해서는 **DROP TRIGGER** 문을 사용해야 합니다. 다음은 트리거를 제거하는 예입니다.

**\[예 45] 트리거의 제거**

```
DROP TRIGGER TRG1;
```

## 파티션

테이블의 크기가 점점 커지고 많은 트랜잭션이 동시에 액세스하는 경우 운영체제는 빈번한 입출력과 잠금(Lock) 현상이 발생하게 됩니다. 이러한 현상은 데이터베이스 성능이 저하되는 원인이 됩니다. 이를 해결하기 위해 하나의 논리적 테이블을 여러 개의 물리적인 공간으로 나누는 파티션을 설정할 수 있습니다.

파티션(Partition)은 대용량 서비스를 하는 데이터베이스에서 효율적으로 관리하고 동작하기 위해 지원하는 옵션입니다. 파티션은 서로 다른 테이블 스페이스에 생성할 수 있으며 입출력과 같은 물리적인 제약을 감소시킬 수 있습니다.

하나의 테이블로만 모든 데이터가 유지된다면 모든 트랜잭션이 한 곳에 집중하게 됩니다. 이로 인해 각 트랜잭션이 다른 트랜잭션을 대기하는 일이 많아져 데이터베이스 성능이 저하됩니다. 하지만 파티션으로 나눈 경우에는 각 트랜잭션이 자신이 접근해야 할 파티션에만 접근하면 되므로 대기 확률이 줄어듭니다.

일부 DML 문장의 경우 특정 파티션에 있는 데이터만 접근하면 되므로 전체 테이블을 모두 읽는 것보다 1/N(파티션 개수)의 정보만을 검색할 수 있습니다.

파티션은 다음과 같이 세 가지 종류가 있습니다.

<table><thead><tr><th width="131">파티션</th><th>설명</th></tr></thead><tbody><tr><td>RANGE</td><td>각 파티션에 포함될 RANGE를 지정하여 파티션을 정의</td></tr><tr><td>HASH</td><td>HASH 함수를 이용하여 파티션을 정의</td></tr><tr><td>LIST</td><td>각 파티션에 포함될 값을 직접 지정하여 파티션을 정의</td></tr></tbody></table>

### 파티션 생성

파티션을 생성하기 위해서는 **CREATE TABLE** 문을 사용할 때 파티션의 정보를 정의함으로써 파티션된 테이블을 만들 수 있습니다. 테이블을 만들 수 있는 권한만 있다면 특별한 권한은 필요하지 않습니다.

다음은 파티션으로 구성한 테이블을 생성하는 예입니다.

**\[예 46] 파티션의 생성**

```
CREATE TABLE PARTITIONED_TABLE1 (C1 NUMBER, C2 CLOB, C3 NUMBER)
        PARTITION BY RANGE (C1, C3)
(
        PARTITION PART1 VALUES LESS THAN (30, 40),
        PARTITION PART2 VALUES LESS THAN (50, 60),
        PARTITION PART3 VALUES LESS THAN (60, 70)
);
```

테이블을 파티션으로 나누는 방법은 범위를 통해 가능합니다. 위의 예에서는 각 파티션에 범위를 지정하여 해당 파티션에 데이터를 삽입합니다. 이를 통해 데이터가 어느 파티션에 속해 있는지를 알 수 있습니다. 파티션은 최대 10,000개까지 생성할 수 있습니다.

파티션의 또 다른 장점은 관리의 편의성입니다. 각 연도별로 파티션을 나눈 테이블이 있다고 했을 때 필요치 않은 10년 전의 정보를 저장하고 있는 해당 파티션을 제거함으로써 쉽게 삭제(DROP)할 수 있습니다. 또한 다음 해에 해당하는 파티션이 필요하다면 새로운 파티션을 추가(ADD)할 수 있습니다.

파티션의 제거와 추가는 ALTER TABLE 문에서 파티션과 관련된 옵션을 사용함으로써 가능합니다.

```
ALTER TABLE PARTITIONED_TABLE1 ADD PARTITION PART4
        VALUES LESS THAN (70, 80);

ALTER TABLE PARTITIONED_TABLE1 DROP PARTITION PART1;
```

#### **파티션 정의 시 주의사항**

파티션을 정의할 때 다음과 같은 주의사항이 있습니다.

* 각 파티션을 정의한 순서에 따라 범위가 정렬되어야 합니다. 예를 들면 다음의 문장은 에러가 발생합니다.

```
CREATE TABLE PARTITIONED_TABLE2 (C1 NUMBER, C2 CLOB, C3 NUMBER)
        PARTITION BY RANGE (C1, C3)
(
        PARTITION PART1 VALUES LESS THAN (50, 20),
        PARTITION PART2 VALUES LESS THAN (30, 10),
        PARTITION DEF_PART VALUES LESS THAN (MAXVALUE, MAXVALUE)
);
```

PART1이 PART2보다 먼저 선언되었지만, PART1의 범위가 PART2를 포함합니다. 범위를 정의할 때 VALUES LESS THAN 절은 '**이전 PARTITION에 들어가지 않고 \~보다 작은 값을 갖는 데이터를 포함하는 파티션**'이라는 의미를 가집니다. 그러므로 항상 파티션의 범위는 정렬되어야 합니다.

ALTER TABLE 문에 의해 새로 만들어진 파티션은 기존의 마지막 파티션의 범위보다 높은 범위를 가져야 합니다. 범위 간의 비교는 선행하는 파티션의 키가 더 큰 쪽이 큰 범위입니다. 선행하는 파티션의 키가 MAXVALUE로 지정되어 새로운 파티션의 키로 더 큰 값을 지정할 수 없는 경우에는 파티션을 추가하거나 생성할 수 없으므로 주의해야 합니다.

다음은 이와 같은 에러를 발생시키는 예입니다.

```
CREATE TABLE PARTITIONED_TABLE3 (C1 NUMBER, C2 CLOB, C3 NUMBER)
        PARTITION BY RANGE (C1, C3)
(
        PARTITION PART1 VALUES LESS THAN (50, 20),
        PARTITION PART2 VALUES LESS THAN (60, 70)
);

ALTER TABLE PARTITIONED_TABLE3 ADD PARTITION PART3
        VALUES LESS THAN (80, 40);

ALTER TABLE PARTITIONED_TABLE3 ADD PARTITION PART3
        VALUES LESS THAN (70, 100);
```

* 현재 Tibero는 HASH 파티션 테이블에 대한 파티션 추가를 지원하지 않습니다.

### 복합 파티션 생성

복합 파티션은 한 개의 키로 우선 파티션을 한 뒤 각 파티션을 같은 키 혹은 다른 키로 다시 파티션을 하는 테이블 파티션의 한 방식입니다.

아래 예는 sold\_date 컬럼을 이용해 월별로 RANGE 파티셔닝을 우선한 뒤 각 파티션을 다시 product\_id로 HASH 파티셔닝한 예입니다.

```
CREATE TABLE years_sales
(
    product_id      NUMBER,
    product_name    VARCHAR(20),
    price           NUMBER,
    sold_date       DATE
)
PARTITION BY RANGE (sold_date)
SUBPARTITION BY HASH (product_id)
(
    PARTITION jan_sales VALUES LESS THAN (TO_DATE('31-01-2006', 'DD-MM-YYYY')),
    PARTITION feb_sales VALUES LESS THAN (TO_DATE('28-02-2006', 'DD-MM-YYYY')),
    PARTITION mar_sales VALUES LESS THAN (TO_DATE('31-03-2006', 'DD-MM-YYYY')),
    PARTITION apr_sales VALUES LESS THAN (TO_DATE('30-04-2006', 'DD-MM-YYYY')),
    PARTITION may_sales VALUES LESS THAN (TO_DATE('31-05-2006', 'DD-MM-YYYY')),
    PARTITION jun_sales VALUES LESS THAN (TO_DATE('30-06-2006', 'DD-MM-YYYY')),
    PARTITION jul_sales VALUES LESS THAN (TO_DATE('31-07-2006', 'DD-MM-YYYY')),
    PARTITION aug_sales VALUES LESS THAN (TO_DATE('31-08-2006', 'DD-MM-YYYY')),
    PARTITION sep_sales VALUES LESS THAN (TO_DATE('30-09-2006', 'DD-MM-YYYY')),
    PARTITION oct_sales VALUES LESS THAN (TO_DATE('31-10-2006', 'DD-MM-YYYY'))
        SUBPARTITIONS 2,
    PARTITION nov_sales VALUES LESS THAN (TO_DATE('30-11-2006', 'DD-MM-YYYY'))
        SUBPARTITIONS 4,
    PARTITION dec_sales VALUES LESS THAN (TO_DATE('31-12-2006', 'DD-MM-YYYY'))
        (SUBPARTITION dec_1, SUBPARTITION dec_2, SUBPARTITION dec_3, SUBPARTITION dec_4)
);
```

두 개의 컬럼(위 예의 경우 sold\_date와 product\_id)에 대한 조건으로 빈번하게 조회가 일어나는 대용량 테이블에 대해 이런 식으로 복합 파티셔닝을 하면 검색할 데이터의 양이 크게 줄기 때문에 성능상의 큰 이득을 볼 수 있습니다.

{% hint style="info" %}
**참고**

각 복합 파티션에 대한 문법은 "[Tibero SQL 참조 안내서](/tibero-manuals/7.2.6.manuals/sql-reference-guide.md)"를 참고합니다.
{% endhint %}

### 인터벌 파티셔닝

인터벌 파티션은 레인지 파티션의 확장으로 최초에 선언되지 않은 범위의 데이터가 들어왔을 때 그에 맞는 파티션을 내부적으로 생성하는 기능입니다.

아래는 인터벌 파티션을 사용하여 테이블을 생성하는 예입니다.

**\[예 47] 인터벌 파티션의 생성**

```
CREATE TABLE PARTITIONED_TABLE_INTERVAL
(
    C1 NUMBER,
    C2 CLOB,
    C3 NUMBER
)
PARTITION BY RANGE (C1)
INTERVAL (10)
(
    PARTITION PART1 VALUES LESS THAN (10),
    PARTITION PART2 VALUES LESS THAN (20),
    PARTITION PART3 VALUES LESS THAN (30)
);
```

#### **인터벌 파티셔닝 시 주의사항**

인터벌 파티셔닝을 할 때 다음과 같은 주의사항이 있습니다.

* 인터벌 파티셔닝의 파티션 키는 반드시 Numerical 또는 Date range이어야 합니다.
* 테이블을 생성하는 경우 최소 하나의 파티션은 지정하거나 생성해야 합니다.
* Composite partitioning에서 primary 파티셔닝으로 사용 가능하지만 subpartition에서는 사용할 수 없습니다.

### 인덱스 파티션 생성

테이블뿐만 아니라 인덱스도 파티션을 지정할 수 있습니다. 인덱스 또한 파티션을 통해 데이터베이스 성능을 향상시킬 수 있습니다. 인덱스는 다음과 같이 두 가지 방법으로 파티션을 나눌 수 있습니다.

#### **로컬 파티션**

테이블이 파티션되었을 때 테이블 파티션에 들어가는 키로 파티션을 나누는 방법입니다. 각 파티션에 아무런 정보를 입력하지 않고 단지 **LOCAL**이라고 선언하면 됩니다. 이름은 자동으로 생성되며 그 외 정보는 기본값으로 설정됩니다.

로컬 파티션으로 설정된 인덱스는 테이블의 한 파티션과 1:1로 대응됩니다. 로컬 파티션으로 설정된 인덱스의 한 파티션은 테이블의 한 파티션에 있는 로우만을 가리킵니다.

다음은 로컬 파티션으로 인덱스를 생성하는 예입니다.

**\[예 48] 로컬 파티션 인덱스의 생성**

```
CREATE TABLE PARTITIONED_TABLE1 (C1 NUMBER, C2 CLOB, C3 NUMBER)
        PARTITION BY RANGE (C1, C3)
(
        PARTITION PART1 VALUES LESS THAN (30, 40),
        PARTITION PART2 VALUES LESS THAN (50, 60),
        PARTITION DEF_PART VALUES LESS THAN (MAXVALUE, MAXVALUE)
);

CREATE INDEX PARTITIONED_INDEX1 ON PARTITIONED_TABLE1 (C1) LOCAL
(
        PARTITION IPART1 INITRANS 3,
        PARTITION IPART2 PCTFREE 10,
        PARTITION IPART3
);
```

#### **글로벌 파티션**

테이블과는 무관하게 인덱스에 따로 파티션을 설정하는 방법입니다. 테이블이 파티션으로 나뉘어져 있든 아니든 글로벌 파티션 인덱스를 만들 수 있습니다. 글로벌 파티션 인덱스의 한 파티션은 테이블의 어느 파티션에 있는 로우라도 가리킬 수 있습니다.

다음은 글로벌 파티션으로 인덱스를 생성하는 예입니다.

**\[예 49] 글로벌 파티션 인덱스의 생성**

```
CREATE TABLE PARTITIONED_TABLE1 (C1 NUMBER, C2 CLOB, C3 NUMBER)
        PARTITION BY RANGE (C1, C3)
(
        PARTITION PART1 VALUES LESS THAN (30, 40),
        PARTITION PART2 VALUES LESS THAN (50, 60),
        PARTITION DEF_PART VALUES LESS THAN (MAXVALUE, MAXVALUE)
);

CREATE INDEX PARTITIONED_INDEX1 ON PARTITIONED_TABLE1 (C3, C1)
        GLOBAL PARTITION BY RANGE (C3)
(
        PARTITION IPART1 VALUES LESS THAN (20) INITRANS 3,
        PARTITION IPART2 VALUES LESS THAN (70) PCTFREE 10,
        PARTITION IPART3 VALUES LESS THAN (MAXVALUE)
);
```

### 파티션 정보 조회

Tibero에서는 파티션된 스키마의 정보를 제공하기 위해 다음 표에 나열된 정적 뷰를 제공하고 있습니다.

DBA나 일반 사용자 모두 사용할 수 있습니다.

<table><thead><tr><th width="195">정적 뷰</th><th>설명</th></tr></thead><tbody><tr><td>DBA_PART_TABLES</td><td>Tibero 내의 파티션된 모든 테이블의 정보를 조회하는 뷰</td></tr><tr><td>USER_PART_TABLES</td><td>현재 사용자에 속한 파티션된 테이블의 정보를 조회하는 뷰</td></tr><tr><td>ALL_PART_TABLES</td><td>사용자가 접근 가능한 파티션된 테이블의 정보를 조회하는 뷰</td></tr><tr><td>DBA_PART_INDEXES</td><td>Tibero 내의 파티션된 모든 인덱스의 정보를 조회하는 뷰</td></tr><tr><td>USER_PART_INDEXES</td><td>현재 사용자에 속한 파티션된 인덱스의 정보를 조회하는 뷰</td></tr><tr><td>ALL_PART_INDEXES</td><td>사용자가 접근 가능한 파티션된 인덱스의 정보를 조회하는 뷰</td></tr></tbody></table>

{% hint style="info" %}
**참고**

정적 뷰에 대한 자세한 내용은 "[Tibero 참조 안내서](/tibero-manuals/7.2.6.manuals/reference-guide.md)"를 참고합니다.
{% endhint %}


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://docs.tibero.com/tibero-manuals/7.2.6.manuals/administrator-guide/schema-object-management.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.
