Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Linux 환경에서 티베로 DBMS 클라이언트 설치 관련하여 사전 준비사항, 고려사항, DB 설치방법에 대해서 설명합니다.
본 문서는 총 2개의 장으로 구성됩니다.
Tibero 클라이언트 설치 전 준비사항과 주의사항 및 설치 후 고려사항에 대해서 설명합니다.
🔎
UNIX 환경에서Tibero 클라이언트를 수동 모드로 설치하는 방법을 설명합니다.
🔎
Linux, Windows 등 다양한 환경에서 Tibero DB 설치 방법을 안내합니다.
Windows 환경 내 티베로 DB 설치 방법을 안내합니다.
티베로 DBMS 사용 가이드를 주제별로 안내합니다. 설치부터 전환, 관리, 개발, 보안 관련 정보를 확인하세요.
Windows 환경 내 티베로 DBMS 클라이언트 설치 관련하여 사전 준비사항, 고려사항, 설치 방법에 대해 설명합니다.
본 문서는 총 2개의 장으로 구성됩니다.
Tibero 클라이언트 설치 전 준비사항과 주의사항 및 설치 후 고려사항에 대해서 설명합니다.
🔎
Windows 환경에서 Tibero 클라이언트를 수동 모드로 설치하는 방법을 설명합니다.
🔎
Linux 환경에서 Tibero DB 설치 방법 (Tibero DBMS Install on Linux)을 안내합니다.
Linux와 Windows 환경 내 티베로 DBMS 클라이언트 설치 관련하여 사전 준비사항, 고려사항, 설치 방법에 대해 설명합니다.
본 문서는 총 2개의 장으로 구성됩니다.
Tibero 클라이언트 설치 전 준비사항과 주의사항 및 설치 후 고려사항에 대해서 설명합니다.
Tibero 클라이언트를 수동 모드로 설치하는 방법을 설명합니다.
(SQL, tbPSM, Text and tbESQL)
Tibero Database Undo 테이블스페이스 크기 산정 방법에 대해 설명합니다.
데이터의 갱신이 많은 시스템인 경우 Undo 테이블스페이스(Undo Tablespace)의 I/O가 많이 발생하므로 Undo 테이블 스페이스를 여러 개의 데이터 파일로 작성하여 데이터 파일을 분산시킵니다.
설계 및 관리 용이(rollback,segment)
UNDO Data의 overwrite 방지
영역확장 용이
플래시백 쿼리 이용 가능
다음은 Undo 테이블 스페이스 크기를 산정할 때 고려할 사항입니다.
데이터 파일 용량, UNDO_RETENTION, Undo Segment 수
자동 관리일 경우 Undo Segment의 개별 공간은 자동으로 관리되므로 전체 Undo Segment의 최소/최대개수와 데이터 파일 용량만 설정합니다.
최소 Undo Segment 개수(_USGMT_ONLINE_MIN)는 보통 10(default)으로 설정합니다. 단, 동시 수행 트랜잭션 수가 많은 경우 부하 중에 추가 Undo Segment를 생성하는 오버헤드가 있을 수 있다. 이경우예상되는동시수행트랜잭션수만큼최소 Undo Segment 개수를 설정해두면 Undo Segme 추가 생성 오버헤드를 줄일 수 있습니다.
최소 Undo Segment 설정 개수가 이미 만들어져 있는 Undo Segment 개수보다 많은 경우 부팅 과정에 서 Undo Segment를 추가로 생성합니다. TAC의 경우 각 노드별로 적용한다. 예를 들어 NODE1은 _USGMT_ONLINE_MIN=30, NODE2는 40 으 로설정하고부팅하면각각 30개와 40개의 Undo Segment가 생성되어있는것을확인할 수 있습니다.
Undo 테이블스페이스(Undo Tablespace)를 생성하는데 필요한 최소 크기와 예상 동시 수행 트랜잭션수를 기준으로 한 예상 크기, 그리고 APM 정보를 이용한 실제 사용 크기로 나누어 생각해 볼 수 있습니다.
최초로 DB를 설치하는 경우 최소 크기 및 예상 크기 중 큰 값을 기준으로 Undo 테이블 스페이스 크기를 산정하고 이후 APM에서 최대 부하가 들어 올때 초당 소모하는 UNDO block 수를 기준으로 실제 크기와 산정한 크기가 맞는지 검증할 수 있습니다.
최소 크기
예상 크기
실제 크기
상황별 DBMS 성능 개선 방법에 대해 설명합니다.
Tibero 클라이언트는 데이터가 지정한 크기만큼 바인딩되기 전까지 서버로 업로드되지 않으므로 대용량 의 데이터를 업로드할 때 효율적으로 사용할 수 있습니다.
tbLoader에서 제공하는 아래의 옵션을 사용하여 이관합니다.
rows
사용자가 대용량 데이터를 업로드할 때 Commit을 수행할 레코드 개수를 지정하는 파라미터 (단, tbLoader는 성능을 고려하여 지정한 레코드의 개수를 정확히 맞춰 서버로 데이터를 보내지는 않음)
Direct Path Load 방식으로 데이터를 로드할 때 테이블에 존재하는 인덱스의 생성 방법을 MULTI INSERT 방식과 FAST BUILD 방식 중에 하나 선택할 수 있습니다.
아래는 인덱스 생성 방법에 대한 설명입니다.
인덱스 생성 방법을 지정하는 컨트롤 파일의 세부 내용은 아래와 같습니다.
Linux 환경 내 Tibero DB Client 설치 관련하여 사전 준비사항과 주의사항, 설치 후 고려사항에 대해 설명합니다.
Tibero를 설치하기 위해서는 각 플랫폼별로 약간의 차이가 있지만 최소 2GB 이상의 하드디스크 여유 공간이 필요합니다. 이는 Tibero 설치 후 데이터베이스를 생성할 때 최소로 필요한 하드디스크 공간을 의미하기도 합니다.
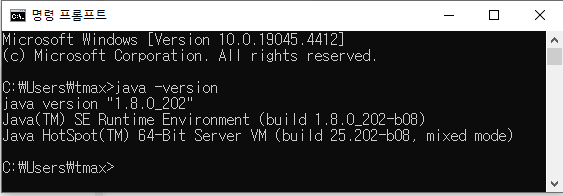
Tibero 클라이언트 인스톨러를 이용해 설치하기 위해서는 JDK 1.5.17 이상이 반드시 설치되어 있어야 합니다.
[그림 1] JDK 설치 확인
Tmax group의 TechNet에서 회원가입 후 설치파일을 다운로드합니다.
🔎
Tibero를 설치한 후 타 제품과 연동을 위해 JDBC를 제공합니다.
JDBC 연동을 할 경우 Tibero DB 서버의 해당 경로에서 드라이버 파일을 받아 연동합니다.
아래는 서버의 운영체제별 드라이버 파일 위치에 대한 설명입니다.
아래는 Tibero 버전 별 드라이버 파일명에 대한 설명입니다.
Tibero DBMS 설치 및 운영하기 전 효율적 시스템 사용을 위한 DB 물리 설계 방법을 제시합니다.
Tibero DB Redo 로그 파일 크기 산정 방법에 대해 설명합니다.
Redo 로그 파일은 최소 2개 그룹을 권장하며, Archivelog 모드인 경우 최소 3개 그룹을 권장합니다. 이는 Redo 로그가 순환할 때 rewrite 방지를 위한 hangup 현상을 막기 위함이며 최소 2개의 멤버를 권장합니다. 성능을 위해 각각 다른 물리 디스크에 배치하도록 합니다.
Redo 로그 파일의 크기를 사전에 정확하게 추측하기가 어렵기 때문에 수행하는 업무의 일부를 수행한 후 Redo 로그 양을 측정하고 전체 업무를 수행했을 때의 Redo 로그 파일의 크기를 예측하는 것을 권장합니다.
아래는 Redo 로그 파일 크기를 산정할 때 고려할 사항입니다.
트랜잭션 처리 중 Log Switch가 발생하는 경우 트랜잭션 성능 저하가 발생합니다.
OLTP 중심의 시스템에서 트랜잭션 처리의 피크 타임에 Log Switch가 빈번하게 일어나지 않도록 Redo로그 크기의 조정이 필요합니다.
Redo 로그 파일의 크기가 크면 Log Switch 발생 가능성이 낮은 반면 Recovery 시간은 길어집니다.
위 고려 사항을 참고해서 다음의 모드 중에 하나를 선택합니다.
LOGGING / NOLOGGING 모드
테이블/인덱스에 대한 모든 변경사항은 기본적으로 Redo 로그로 기록되지만 NOLOGGING 테이블/ 인덱스에 대해 Direct-Path(DP) 방식으로 데이터를 추가하는 경우 Redo 로그를 기록하지 않습니다. DP에 대한 Redo 로그가 남지 않는 경우에 Media Recovery가 수행될 때 DP로 추가한 테이블 데이터 가 복구되지 않기 때문에 DP로 데이터를 추가한 후에는 백업을 받도록 권장합니다.
아래는 LOGGING 모드에서 하나의 DML당 로그 발생량 및 확인 방법입니다.
로그의 발생량을 DML 한 건으로 측정하기가 쉽지 않기 때문에 여러 건의 DML을 수행한 후 전체 로그 발생량을 측정해서 건수로 나누는 방법을 권장합니다.
로그 발생량은 v$sysstat 테이블의 'name' 컬럼이 'Redo log size'인 항목으로 확인 가능하며 alter system clear stat 명령으로 v$sysstat 테이블의 내용을 clear할 수 있습니다.
ARCHIVELOG / NOARCHIVELOG 모드 Redo 로그 파일은 Cache Recovery될 때 더 이상 필요없는 경우에 재사용됩니다. (일반적으로 3개의 Redo 로그 파일들을 생성해서 순차적으로 돌면서 재사용하는 구조입니다.)
Redo 로그에는 사용자 데이터에 가해지는 변경사항이 저장되며 DML의 종류에 따라 아래와 같은 내용이 저장됩니다.
추가로 아래와 같은 내용을 포함합니다.
트랜잭션 처리(begin/commit)를 위한 Redo 로그
Segment의 공간 관리(extent add, block format, index split)에 대한 Redo 로그
Undo 블록에 대한 변경사항
블록 내 각 ROW에서 수행했던 트랜잭션의 commit 여부를 확인하고 변경하는 Redo 로그
Redo 로그 파일에 쓰여지는 데이터량은 SQL 및 갱신 데이터량에 의해 크게 바뀌기 때문에 운영 전 사전에 정확한 추측이 불가능합니다.
시스템의 크기에 따라서 다음과 같이 사전 설정 후 실제 운영 중 REDO 발생량을 보고 조정해야 합니다.
Tibero DB SQL Execution Work Area 크기 산정 방법에 대해 설명합니다.
다른 워킹 프로세스 및 워킹 스레드와 공유되지 않은 독립적인 메모리 공간으로 세부 영역은 다음과 같습니다.
세션 정보 영역 로그온 및 세션 관련 정보
커서 정보 영역 (SQL영역) SQL 문 처리할 때 필요한 메모리 공간
SQL Work Area (SQL 작업 영역) Sort, hash-Join, Bitmap 생성 및 Merge(병합) 작업할 때 사용되는 메모리 영역
UNIX 환경 내 Tibero Database Client 수동 모드 설치 방법을 안내합니다.
설치 파일(tar.gz)과 라이선스 파일(license.xml)을 준비합니다.
클라이언트 계정을 생성합니다.
Windows 환경 내 Tibero DB 클라이언트 수동 모드 설치 및 제거방법을 설명합니다.
설치 파일을 준비합니다. Tibero 클라이언트를 설치할 폴더를 생성하고 압축을 해제하면 폴더들이 생성됩니다.
환경변수를 설정합니다.
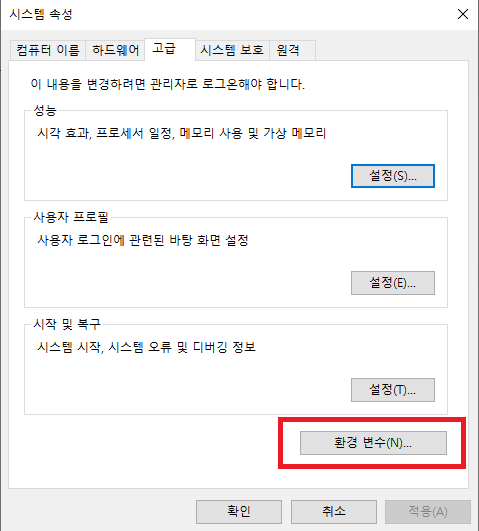
(1) Windows에서 [시스템 환경 변수 편집] -> [고급] -> [환경변수]를 선택한 후 [시스템 변수]를 설정합니다.
[그림 2] 시스템 변수 설정
계정 및 권한, 파일환경 점검 등 Tibero DBMS 운용과 관리에 대한 보안 위험분석 및 영향도, 그리고 해결방안을 제시합니다.
본 문서는 총 5개의 장으로 구성됩니다.
계정 관리에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
🔎
권한 관리에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
🔎
DBMS 보안 설정에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
🔎
타 DB, 대용량 DB 등을 Tibero DBMS 전환 이관 방법에 대해 안내합니다.
UNIX, Linux 계열
Technet의 tar.gz 파일을 다운받아 사용합니다.
UNIX 계열
$TB_HOME/client/lib/jar
Tibero 7
tibero7-jdbc.jar
환경 파일 점검에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
보안 감사 설정에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
초당 UNDO block 소모량
운영 중 최대 부하 당시의 APM 리포트에서 Undo Statistics의 Undo blocks값을 APM 구간(초)로 나눈 값이 다
UNDO_RETENTION
TIP 설정 값이다. (기본값: 900초)
여유값
KB 값이다. Long 트랜잭션이 비정기적으로 들어올 경우 (INDEX rebuild등도 포함)를 대비하여 충분한 크기를 잡 아 두는 것이 좋다.
항목
설명
Undo 테이블 스페이스당 Undo Segment 최소 개수
Single/TAC 모두 경우 _USGMT_ONLINE_MIN 값이다.
Undo Tablespace당 Undo Segment 최대 개수
예상되는 최대 동시 수행 트랜잭션 수이다.
Single의 경우 : _USGMT_ONLINE_MAX 값
TAC의 경우 : _USGMT_ONLINE_MAX / 노드수
_USGMT_UNIFORM_EXTSIZE * 2
Undo Segment는 최소 2개의 UNDO extent가 필요하고
Undo extent 하나의 크기는_USGMT_UNIFORM_EXTSIZE이다.
bindsize
배열에 사용될 최대 바이트 수를 지정하는 파라미터 (기본값 : 64KB)
MULTI INSERT INDEXES
인덱스를 여러 개의 레코드 단위로 최적화 하여 한 번에 생성
FAST BUILD INDEXES
기존의 인덱스를 무시하고 데이터 파일의 데이터를 모두 로드하여 다시 생성
NOARCHIVELOG 모드 및 LOGGING 모드 NOARCHIVELOG 모드인 경우 Media Recovery가 지원되지 않기 때문에 LOGGING 테이블인 경우 라도 성능 개선을 목적으로 DP를 수행할 때 Redo 로그를 남기지 않습니다. ARCHIVELOG/NOARCHIVELOG 모드는 Redo 로그를 재사용하기 전 백업 수행 여부에 대한 판단이 기 때문에 LOGGING/NOLOGGING과는 개념상 큰 연관성은 없습니다.
Direct-Path Loading / Direct-Path Insert (DPL/DPI) 모드
DP로 데이터를 추가하는 경우 데이터를 row 단위로 건건이 추가하는 방식이 아니라 batch 단위로 추가 하기 때문에 성능이 빠르며 Redo 로그의 양도 row 단위로 건건이 추가할 때보다 적게 생성됩니다.
최대 크기
Tibero 5 SP1 : 4GB
Tibero 6 이상 : 2TB
Tibero 7 : 2TB
구분
설명
로그 파일 최대 개수
CREATE DATABASE 절의 MAXLOGFILES 파라미터
Group당 로그 파일 최대 개수
Unlimited
최소 크기
구분
설명
소규모 시스템
4MB~100MB
중규모 시스템
100MB~1GB
대규모 시스템
4MB
1GB 이상
profile을 설정합니다. 클라이언트 서버의 profile에 해당 내용을 환경에 맞게 수정한 후 추가합니다.
gen_tip.sh를 실행합니다.
네트워크 파일 (tbdsn)을 설정합니다. tbdsn.tbr 파일은 서버의 접속 경로를 설정하는 파일로 $TB_HOME/client/config에 위치합니다. 아래와 같이 tbdsn.tbr 파일을 수동으로 설정합니다.
Tibero Client를 이용해서 Tibero Server로 접속합니다.
(Undo 테이블 스페이스당 Undo Segment 최소 개수 * _USGMT_UNIFORM_EXTSIZE * 2
* Block size(8KB)) + 여유값(Undo 테이블 스페이스당 Undo Segment 최대 개수 * _USGMT_UNIFORM_EXTSIZE * 2
* Block size(8KB)) + 여유값(초당 UNDO Block 소모량 * UNDO retention * Block size(8KB)) + 여유값# MULTI INSERT INDEXES 적용
$cat control.ctl
LOAD DATA
...
MULTI INSERT INDEXES
...
(...)
# FAS BUILD INDEXES 적용
$cat control.ctl
LOAD DATA
...
FAST BUILD INDEXES
...
(...)INSERT 하는 ROW의 내용(TABLE row 전체 + INDEX key 전체) +
INSERT에 대한 UNDO(delete할 rowid + delete할 INDEX key)UPDATE 내용(ROW의 내용 중 새로 변경되는 내용 + 변경되는 컬럼의 INDEX key delete/insert)
+ UPDATE에 대한 UNDO(row 변경을 되돌리는 내용 + INDEX key delete/insert)DELETE되는 ROW에 대한 내용(rowid 정보 + INDEX key 전체)
+ DELETE에 대한 UNDO(row 전체 + INDEX key 전체)$ useradd -d /home/tibero7_client -g dba tibero7_client
$ passwd tibero7_client$ ls
tibero7-bin-FS02-windows64_2008-269353-20240314021215.zip
$ unzip tibero7-bin-FS02-linux64_3.10-254994.tar.gz```shell
$ vi ~/.bash_profile
export TB_HOME=/home/tibero7_client/tibero7
export TB_SID=tibero
export PATH=$TB_HOME/bin:$TB_HOME/client/bin:$PATH
export LD_LIBRARY_PATH=$TB_HOME/client/lib:$LD_LIBRARY_PATH
$ source ~/.bash_profile$ cd $TB_HOME/config
$ sh gen_tip.sh Using TB_SID "tibero"
/home/tibero7_client/tibero7/config/tibero.tip generated
/home/tibero7_client/tibero7/config/psm_commands generated
/home/tibero7_client/tibero7/client/config/tbdsn.tbr generated.
Running client/config/gen_esql_cfg.sh
Done.$ cd $TB_HOME/client/config
$ ls
gen_esql_cfg.sh tbco_file_id tbdsn.tbr tbimport_hl.config.default tbpcb.cfg
tbc_file_id tbdfdump.cfg tbertl.cfg tbpc.cfg
$ vi tbdsn.tbr
#------------------------------------------------------------
# /home/tibero7_client/tibero7/client/config/tbdsn.tbr
# Network Configuration File.
# Generated by gen_tip.sh at 2023. 06. 12. (월) 14:30:16 KST
tibero=(
(INSTANCE=(HOST=192.168.xxx.xxx)
(PORT=8629)
(DB_NAME=tibero)
)
)/tbsql tibero/tmax
TmaxTibero Corporation Copyright (c) 2020-. All rights reserved.
Connected to Tibero.
SQL> SELECT
IPADDR, USERNAME
FROM
V$SESSION; 2 3 4
IPADDR
----------------------------------------------------------
USERNAME
-----------------------------------------------------------------------------------
192.168.xxx.xxx
TIBERO아래는 관련 파라미터에 관한 설명입니다.
구분
설명
총 SQL Execution Work Area
산정방법
MEMORY_TARGET - TOTAL_SHM_SIZE
MEMORY_TARGET
총 메모리 사용량이다.
TOTAL_SHM_SIZE
대용량의 데이터를 Full Table Scan으로 읽어들여 정렬, 조인 및 분석을 수행하는 쿼리가 대부분이고 Parallel Execution을 이용하는 환경입니다. 읽어들이는 데이터의 크기가 물리적인 메모리 크기에 담을 수 없을 정도의 크기인 경우가 많기 때문에 효율적인 Buffer Cache 이용을 기대할 수가 없는 상황이므로 공유 메모리 영역에서 Buffer Cache의 크기를 줄이고 독립적으로 사용 가능한 SQL Execution Work Area 메모리 크기에 따라 성능이 크게 좌우되는 정렬, 조인 및 분석 작업을 위해 대부분의 물리 메모리 를 SQL Work Area에 할당하는 것이 효율적입니다.
다음은 SQL Execution Work Area 크기 산정하는 방법입니다.
항목
설명
일반적인 온라인 업무 환경 (OLTP)
SQL Execution Work Area (SQL 실행 작업 영역) : 20%
TOTAL_SHM_SIZE : MEMORY_TARGET 값의 80% (OS 및 다른 서비스 사용 영역 제외) EX_MEMORY_OPERATION_LIMIT : 5000
_OP_MEM_MAX_SIZE (Tibero 7 기준 (IPARAM(MEMORY_TARGET) - IPARAM(TOTAL_SHM_SIZE)) * 0.05
_OP_MEM_MAX_SIZE (Tibero7 기준)
데이터 분석 업무 환경
(OLAP)
SQL Execution Work Area (SQL 실행 작업 영역) : 80% (가용 메모리 한계 내에서 최적의 작업 영역을 지정하여 디스크 I/O를 줄이고 SQL의 수행 속도를 높일 수 있도록 조절하기 위해서)
TOTAL_SHM_SIZE : MEMORY_TARGET 값의 20%
EX_MEMORY_OPERATION_LIMIT : 20000 (Tibero 7 기준 Deprecated)
_OP_MEM_MAX_SIZE(Tibero 7 기준) (IPARAM(MEMORY_TARGET) - IPARAM(TOTAL_SHM_SIZE)) * 0.2
총 SQL Execution
Work Area
(2) [환경변수]에서 [시스템 변수] -> [새로 만들기]를 선택 한 후 TB_HOME, TB_SID를 설정합니다.
[그림 3] TB_HOME, TB_SID 설정
(3) C:\Tibero 디렉터리에서 압축된 바이너리 실행 파일(tar.gz)을 해제합니다. 그 후에 %TB_HOME%의 license라는 하위 디렉터리에 발급받은 라이선스 파일(license.xml)을 복사합니다.
(4) tbinstall.vbs 실행 후 레지스트리 등록을 확인합니다.
[그림 4] 설치완료 확인창
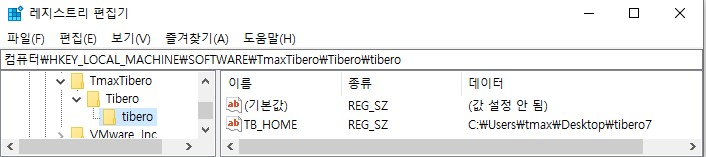
레지스트리 확인(regedit)에서 HKEY_LOCAL_MACHINE\SOFTWARE\TmaxTibero\Tibero\tibero 경로에 TB_HOME과 TB_SID가 등록되었는지 확인합니다.
[그림 5] TB_HOME, TB_SID 등록 확인
(5) gen_tip.bat를 실행합니다.
(6) 필요없는 폴더를 제거합니다. bin과 client 폴더를 남기고 나머지는 제거합니다.
(7) 네트워크 파일(tbdsn)을 설정합니다. tbdsn.tbr 파일은 서버의 접속 경로를 설정하는 파일로 "%TB_HOME%\client\config"에 위치합니다.
(8) Tibero Client를 이용해서 Tibero Server로 접속합니다.
tbuninstall.vbs를 실행하여 레지스트리에서 제거합니다.
[그림 6] 제거완료 확인창
물리 파일을 삭제합니다. %TB_HOME%으로 설정된 경로의 디렉터리를 삭제하여 Tibero 클라이언트를 삭제합니다.
$ echo %TB_HOME% %TB_SID%
$ cd %TB_HOME%\bin
$ tbinstall.vbs %TB_HOME% %TB_SID%$ echo %TB_HOME% %TB_SID%
$ cd %TB_HOME%\config
$ gen_tip.bat\tibero=(
(INSTANCE=(HOST=192.168.xxx.xxx)
(PORT=8629)
(DB_NAME=tibero)
)
)C:\Users\tmax\Desktop\tibero7\config>tbsql tibero/tmax
SQL> SELECT IPADDR, USERNAME FROM V$SESSION;
IPADDR
-----------------------------------------------
USERNAME
---------------------------------------------------------------------------------
192.168.xxx.xxx
TIBERO
1 row selected.$ echo %TB_HOME% %TB_SID%
$ cd %TB_HOME%\bin
$ tbuninstall.vbsWindows 환경 내 Tibero 클라이언트 설치 관련하여 사전 준비 사항 및 주의 사항, 고려 사항에 대해서 설명합니다.
Tibero를 설치하기 위해서는 각 플랫폼별로 약간의 차이가 있지만 최소 2GB 이상의 하드디스크 여유 공간이 필요합니다. 이는 Tibero 설치 후 데이터베이스를 생성할 때 최소로 필요한 하드디스크 공간을 의미하기도 합니다.
Tibero 클라이언트 인스톨러를 이용해 설치하기 위해서는 JDK 1.5.17 이상이 반드시 설치되어 있어야 합니다.
[그림 1] JDK 설치 확인
Tmax group의 TechNet에서 회원가입 후 설치파일을 다운로드합니다.
🔎
Tibero를 설치한 후 타 제품과 연동을 위해 JDBC를 제공합니다.
JDBC 연동을 할 경우 Tibero DB 서버의 해당 경로에서 드라이버 파일을 받아 연동합니다.
아래는 Tibero 버전 별 드라이버 파일명에 대한 설명입니다.
티베로 DB Shared Memory 크기 산정 방법에 대해 설명합니다.
Tibero Shared Memory는 부팅할 때 고정된 용도로 사용되는 Fixed 영역과 운영 중에 자동으로 할당되어 사용되는 Shard Pool 영역으로 구분할 수 있습니다.
Fixed Memory DB가 부팅할 때 파라미터 값을 바탕으로 크기가 고정되는 영역입니다.
Buffer Cache(Database Buffer)
Log Buffer
기존 데이터베이스를 Tibero DBMS로 전환하는 Table Migrator 유틸리티에 대해 안내합니다.
기존 데이터베이스를 Tibero로 전환하는 Table Migrator 유틸리티에 대해 안내합니다.
Table Migrator 유틸리티의 특징 입니다.
Command 기반이며, 내부적으로 JAVA의 JDBC 드라이버를 이용하여 DBMS에 접속합니다.
별도 컴퓨터(클라이언트)가 필요하지 않으며 Source 또는 Target 서버에서 수행 가능합니다.
DB 전환 전 고려사항에 대해서 설명합니다.
table_migrator.zip 바이너리 압축 파일을 해제하면 다음과 같은 파일이 생성됩니다.
_OP_MEM_MAX_SIZE(Tibero 7 기준) (IPARAM(MEMORY_TARGET) - IPARAM(TOTAL_SHM_SIZE)) * 0.3
총 공유 메모리 사용량이다.
_OP_MEM_MAX_SIZE
하나의 operation(정렬, 조인, 분석)에서 사용할 최대 메모리 사용량이다. (Tibero 7 기준)
_OP_MEM_PX_MAX_SIZE
하나의 operation(정렬, 조인, 분석)이 parallel로 수행될 때 slave들이 사용 할 수 있는 총 최대 메모리 사용량이다. (Tibero 7 기준)
EX_MEMORY_OPERA TION_LIMIT
하나의 operation에서 사용할 최대 메모리 사용량을 계산한다. (단위: MB) parallel 쿼리에서 slave들도 위의 최대 메모리 사용량을 쓰려고 하기 때문에 과다 메모리를 사용하려고 하고 memory tunner에 의해 나중에 수행되는 slave 의 경우 메모리 사용에 불이익을 받게 될 수도 있다.
최대 MEMORY_TARGET - TOTAL_SHM_SIZE만큼 사용이 가능하다.



Tibero 7
tibero7-jdbc.jar
그 외 항목 : 전역 변수를 위한 공간, 워킹 스레드 정보와 세션 정보를 관리하는 영역
Shared Pool Memory 운영 중에 동적으로 할당되어 사용되는 영역입니다.
DD Cache
PP Cache(Library Cache)
그 외 항목
아래는Shared Memory 크기를 산정할 때 고려해야 할 사항입니다.
Shared Memory 크기를 운영 중에 동적으로 늘릴 수 없습니다.
Buffer Cache와 Shared Pool 사용 패턴을 분석하여 전체 Shared Memory 크기를 알맞게 정해야 합니다.
Buffer Cache
주요 Workload를 돌려본 후 APM 리포트의 Buffer Cache Hit율을 보고 판단합니다.
Hit율이 90 % 이하 : Buffer Cache 크기 늘려야 합니다.
Shared Pool Memory
Workload를 돌려본 후 v$sga의 ‘SHARED POOL MEMORY’ 항목의 사용률 보고 판단합니다.
Shared Pool 사용률이 너무 높으면 (Free 영역이 적은 경우) Shared Pool 크기를 늘려야 합니다.
세션당 최소 1M 이상의 Shared Pool 영역 확보가 필요합니다.
Shared Memory 각 영역의 크기는 v$sga에서 확인할 수 있습니다.
Shared Memory의 크기는 초기화 파라미터로 설정해서 조회할 수 있습니다.
싱글 모드 : TOTAL_SHM_SIZE의 2/3 TAC 모드 : TOTAL_SHM_SIZE의 1/2
싱글 모드 전체 shared pool 크기가 MIN_SHARED_POOL_SIZE보다 커야 합니다. (MIN_SHARED_POOL_SIZE 기본값: 1M * MAX_SESSION_COUNT)
TAC 모드 TAC를 위한 CCC와 CWS 공간이 충분히 확보되어야 합니다. CCC와 CWS를 위해 전체 Buffer Cache 크기의 25% 가량을 Shared Pool에서 사용합니다. CCC와 CWS를 위한 공간을 제외한 Shared Pool 영역이 _MIN_SHARED_POOL_SIZE 보다 커야 합니다.
PP Cache와 DD Cache 등을 위한 Free Shared Pool 크기는 CCC와 CWS 공간보다 커야 합니다.
internal-jdbc-16.jar
Tibero JDBC 드라이버
migrator.bat
Windows 계열 실행 파일
migrator.sh
POSIX 계열 실행 파일
migrator.properties.eg
Table Migrator 컨트롤파일
msllogger-14.jar
로그 관련 인터페이스 클래스
antlr-4.3-complete.jar
문자열 파싱 관련 인터페이스 클래스
postgresql-42.2.27.jre6.jar
PostgreSQL JDBC 드라이버
UNIX 계열인 경우 migrator.sh, Windows 계열인 경우는 migrator.bat 파일을 수정합니다.
classpath 설정에 Source DB의 JDBC 드라이버가 설정되어 있는지 확인하고 없을 경우 추가합니다.
아래는 Table Migrator를 실행하는 2가지 예로 UNIX 계열인 경우 migrator.sh, Windows 계열인 경우는migrator.bat 명령어를 입력합니다.
파라미터의 값을 컨트롤 파일에 설정한 후 실행합니다.
migrator_cli.jar
Table Migrator 클래스
toolcom.jar
Tibero 유틸리티 공통 라이브러리
SQL> select * from v$sga;
NAME TOTAL USED
------------------------------------- -------------------- ---------------
SHARED MEMORY 1258291200 1258291200
FIXED MEMORY 1032962080 1032962080
SHARED POOL MEMORY 225312768 222298112
SHARED POOL ALLOCATORS (LC) 25165824 24048688
SHARED POOL ALLOCATORS (DD) 16777216 3620240
SHARED POOL ALLOCATORS (SLAB) 79691776 76092320
SHARED POOL ALLOCATORS (MISC) 100663296 98956536
SHARED POOL ALLOCATORS (Total) 222298112 202717784
Database Buffers 838860800 838860800
Redo Buffers 10485760 10485760
10 rows selected.
SQL> show param total_shm_size
NAME TOTAL USED
------------------------------------- -------------------- ---------------
TOTAL_SHM_SIZE INT64 1258291200SQL> show param db_cache_size
NAME TOTAL USED
------------------------------------- -------------------- ---------------
DB_CACHE_SIZE UINT64 838860800SQL> show param log_buffer
NAME TOTAL USED
------------------------------------- -------------------- ---------------
FLASHBACK_LOG_BUFFER UINT32 0
LOG_BUFFER UINT32 10485760TOTAL_SHM_SIZE - [Fixed Memory][전체 Shared Pool 크기] = _MIN_SHARED_POOL_SIZE + [CCC 공간] + [CWS 공간]
+ [Free Shared Pool 크기][Free Shared Pool 크기] > ([전체 Shared Pool 크기] - _MIN_SHARED_POOL_SIZE) / 2java -classpath migrator_cli.jar:ojdbc6.jar:postgresql-42.2.27.jre6.jar:msllogger-
14.jar:toolcom.jar:internal-jdbc-16.jar:antlr-4.3-complete.jar com.m.migrator.Main "$@”sh migrator.sh SOURCE_TYPE=ORACLE \
SOURCE_URL=jdbc:oracle:thin:@127.0.0.1:1521:orcl \
SOURCE_USER=system SOURCE_PASSWORD=manager SOURCE_LOGIN_AS=NORMAL \
SOURCE_SCHEMA=scott SOURCE_TABLE=emp \
TARGET_URL=jdbc:internal:thin:@127.0.0.2:8629:t7 \
TARGET_USER=dbtech TARGET_PASSWORD=dbtechsh migrator.sh PROPERTY_FILE=migrator.properties옵션을 사용하여 다양한 방법으로 전환이 가능합니다. (SELECT 옵션, DPL, P-DPL 지원)
아래는 Table Migrator 유틸리티 실행 전 준비사항 입니다.
JRE 1.6 이상 설치
Table Migrator 설치 전 아래의 파일이 준비여부 확인
- table_migrator.zip : Table Migrator 바이너리
- Source DB의 JDBC 드라이버
Oracle
ojdbc6.jar (Source DB 버전에 맞는 드라이버 사용)
MSSQL
sqljdbc4.jar (Source DB 버전에 맞는 드라이버 사용)
DB2
Table Migrator 바이너리를 Source DB 또는 Target DB(Tibero)에 위치합니다.
이관 대상 Table을 생성 DDL을 이용하여 Target DB(Tibero)에 미리 생성합니다.
Table Migrator 유틸리티를 실행할 때 아래와 같은 사항에 유의합니다.
Source DB의 Table을 이관할 경우 Target DB(Tibero)에 Tablespace, User, Table을 미리 생성 후 TableMigrator를 수행합니다.
DBMS 접속 계정에 DBA 권한이 필요합니다.
만약, 고객사의 정책상 DBA 권한을 부여받지 못할 경우 이관 작업을 위한 사용자별 최소한의 권한 예시는 아래와 같습니다.
Oracle (SOURCE DB)
CONNECT, SELECT ANY TABLE, SELECT ANY DICTIONARY, ALTER SESSION
Tibero (TARGET DB)
CONNECT, SELECT ANY TABLE, SELECT ANY DICTIONARY, RESOURCE, ALTER SESSION
long, longraw 컬럼을 지원하지 않습니다.
index가 존재하는 Table일 경우 DPL 옵션을 사용하지 못합니다.
본 문서는 총 3개의 장으로 구성됩니다.
Table Migrator 유틸리티 실행 방법을 안내합니다.
파라미터 지정 과정을 예시와 함께 설명합니다.
타사 DB에서 Tibero DB로 전환에 대한 예시입니다.
티베로 DBMS 보안 설정에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
데이터 Dictionary는 물리적 및 논리적 구조, 객체 정의 및 공간 할당, 사용자, 룰, 권한, 감사 등 데이터베이스의 핵심에 해당하는 정보를 담고 있으므로 사용자 및 외부로부터 보호해야 합니다.
보호되지 않을 경우 누구나 DROP ANY TABLE 명령어로 데이터 Dictionary의 내용을 삭제할 수 있습니다.
데이터 Dictionary 정보의 삭제가 가능합니다.
Tibero는 해당 기능이 없으므로 해당사항이 없습니다.
Listener logging 기능이 활성화 되어있지 않으면 공격자에 의한 악의적인 Listener command 사용 또는Listener 패스워드를 알아내기 위한 Brute Force 공격의 파악이 불가능합니다.
침해 사고 또는 장애 발생의 경우 원인 파악이 어렵습니다.
$TB_HOME/instance/$TB_SID/log/lsnr/trace_list.log 파일을 디폴트로 남깁니다.
Listener는 클라이언트로부터 접속 요구를 감시하는 프로세스로 클라이언트는 Listener를 통해 데이터베이스 에 접속합니다. Listener 설정 파일은 Listener가 기동할 때 읽혀져 클라이언트의 접근을 가능하게 하며 악의적인 사용자에 의해 사용될 경우 원격으로 Listener의 구성 설정을 변경할 수 있습니다.
버퍼 오버플로우, 정보 유출, 악의적인 목적으로 파일을 변조할 수 있습니다.
Tibero는 Oracle과 아키텍처 차이로 Listener가 별도로 존재하지 않습니다.
백업 관리를 통해 장애 및 외부 침입에 대해서 대비해야 합니다.
데이터베이스의 장애가 발생할 경우 복구가 불가능합니다.
백업 정책을 수립하여 주기적인 백업 또는 각기 다른 미디어에 복사본을 보유하고 시스템 유지 보수, Upgrade, Migration 등의 서비스 운휴 및 수정 작업의 경우는 가장 가까운 시간까지의 백업본을 보유합니다.
침해 사고가 발생할 경우 계정별 수행 Query와 시스템 및 응용 애플리케이션에 대한 로그를 관리합니다.
침해 사고 또는 장애 발생의 경우 원인 파악이 어렵습니다.
데이터베이스에서 발생하는 각종 로그는 원격지 관리 시스템을 통해 일정 기간(3개월 이상) 저장 관리하여 특이사항이 발생할 경우 원활한 분석이 가능하도록 지원해야 합니다.
UTL_FILE, UTL_SMTP 등 여러 PL/SQL 패키지는 시스템과 데이터베이스에 영향을 미치는 취약점을 가지고 있 으므로 해당 패키지의 사용 권한이 Public에 부여되는 것을 제한해야 합니다.
파일 시스템의 접근 또는 내부 파일의 외부 유출이 가능합니다.
아래와 같은 패키지의 실행 권한을 사용하지 않는 경우 Public role에서 ‘실행 권한’을 제거합니다.
티베로 DB 보안 감사 설정에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
일반 계정으로 데이터베이스의 관리 및 통계 등의 Meta 데이터를 가지고 있는 System Catalog에 접근하여 데이터베이스의 정보를 획득할 수 있습니다.
데이터베이스의 System Catalog 정보 유출 가능성이 있습니다.
데이터베이스의 Meta 데이터를 가지고 있는 System Catalog는 소수의 데이터베이스 관리자만 사용할 수 있도록 설정합니다.
REVOKE <privilege> ON <system catalog object> FROM PUBLIC;원격 서버로부터 DBMS 정보가 노출될 수있습니다.
인가되지 않은 IP 주소 사용자에게 정보 유출 가능성이 있습니다.
$TB_SID.tip 파일에 아래의 항목들을 정의하여 접근 허용 및 접근 제한 IP 주소를 지정합니다.
LSNR_INVITED_IP
LSNR_DENIED_IP
LSNR_INVITED_IP_FILE
LSNR_DENIED_IP_FILE다음은 LSNR_INVITED_IP 항목의 등록 예제 입니다.
LSNR_INVITED_IP="192.168.20.0/24;192.168.10.101"위와 같이 등록하면 $TB_HOME/instance/$TB_SID/log/lsnr/trace_list.log 파일에 다음과 같이 등록됩니다.
*** listener started and got into main loop ***
[INVITED-IP] 192.168.20.0 / 255.255.255.0
[INVITED-IP] 192.168.10.101 / 255.255.255.255다음은 LSNR_INVITED_IP_FILE 항목의 등록 예제 입니다.
위와 같이 등록한 후 LSNR_INVITED_IP_FILE 항목에 등록한 파일(invited.list)에 허용할 IP 주소 List를 작성합니다.
DB Link는 클라이언트 또는 현재의 데이터베이스에서 네트워크 상의 다른 데이터베이스에 접속하기 위한 접속설정을 정의하는 Tibero 객체입니다.
클라이언트와 데이터베이스 간의 DB Link가 암호화되지 않으면 원격 서버에 접근할 경우 패스워드와 같은 중요 정보가 노출될 수 있습니다.
악의가 있는 사용자가 스니핑 등의 네트워크 공격을 통해 패스워드를 노출할 가능성이 있습니다.
Tibero는 DB Link를 설정할 때 원격 서버의 패스워드가 암호화되므로 해당사항이 없습니다.
감사를 수행할 수 있게 설정하여 사용자에 의한 문장, 권한, 객체에 대해 감사를 수행할 수 있습니다. 침해 사고 및 장애가 발생할 때 감사 자료를 이용하여 정확한 분석을 할 수 있습니다.
침해 사고 또는 장애 발생의 경우 원인 파악이 어렵습니다.
감사를 활성화하기 위하여 TIP 파일에 'AUDIT_TRAIL'의 값을 { NONE | DB | DB_EXTENDED | OS } 중에서 하나 선택합니다.
다음은 $TB_HOME/config/$TB_SID.tip 파일의 설정 예제 입니다.
감사 로그를 다른 사용자가 읽기, 쓰기 할 수 있는 경우 서버의 중요 정보가 노출될 위험성이 있습니다.
비인가 사용자에 의한 파일의 변조 및 노출이 가능합니다.
AUDIT_FILE_DEST에 설정된 경로의 디렉터리 권한을 750 또는 700 이하로 설정합니다.
Tibero DBMS Temp 테이블 스페이스 크기 산정방법에 대해 설명합니다.
Join이나 대량 Sort 처리가 많은 경우 Temp 테이블 스페이스에서의 I/O가 다발적으로 발생합니다. (CREATE INDEX / ANALYZE / SELECT DISTINCT / ORDER BY / GROUP BY / UNION / SORT-MERGE)
Temp 테이블 스페이스 크기 산정을 위해서는 SQL Execution Work Area와 Temp 테이블 스페이스 간의 관계 이해가 필수입니다.
아래는 Temp 테이블 스페이스의 크기를 산정할 때 고려할 사항입니다.
시스템유형 : OLTP, DSS, DW, Batch Job
User Load
Transaction Volume
Data Size
Query & Statements 튜닝
Temp 테이블 스페이스 자체를 여러 개의 데이터 파일로 작성해서 분산 관리 또는 User별 다른 Temp테이블 스페이스 할당
Temp 테이블 스페이스 Group 설정
티베로 데이터베이스 환경 파일 점검에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
Tibero를 사용하여 DBMS에 접근할 경우 명령어 행의 계정 및 패스워드를 붙여서 사용하면 쉘 히스토리 (.history 또는 .sh_history) 파일에 사용한 계정과 패스워드의 기록이 남습니다.
계정 및 패스워드가 유출될 가능성이 있습니다.
Tibero 명령을 사용할 경우 명령어 행에 계정과 패스워드를 Line Mode가 아닌 Interactive Mode로 실행합니다. 쉘 히스토리(.history 또는 .sh_history) 파일에 대한 보호를 위하여 접근 권한 설정을 600으로 설정합니다.
UTL_FILE_DIR은 UTL_FILE을 통해 호스트의 파일 시스템 접근 허용 디렉터리를 제한합니다.
만약 UTL_FILE_DIR의 설정값이 '*'로 설정된 경우 전체 파일 시스템에 접근이 가능하므로 '*'로 설정할 경우에는 매 우 제한적으로 사용해야 합니다.
호스트의 전체 파일 시스템에 접근이 가능합니다.
'*' 설정값을 제거합니다.
UTL_SMTP 패키지를 Public 그룹에서 사용할 수 있도록 권한을 부여하면 허가받지 않은 메일의 전송이 발생 할 수 있습니다.
시스템 내부의 파일을 외부로 전송할 수 있습니다.
Public 그룹과 같은 사용자에게 권한을 부여하지 않고 특정 사용자에게 부여하여 해당 사용자에게만 메일이 전송될 수 있게 합니다.
db2jcc.jar (Source DB 버전에 맞는 드라이버 사용)
MYSQL
mysql-connector-java-5.1.4.jar (Source DB 버전에 맞는 드라이버 사용)
PostgreSQL
postgresql-42.2.27.jre6.jar (Source DB 버전에 맞는 드라이버 사용)
Sybase ASE
jconn3.jar (Source DB 버전에 맞는 드라이버 사용)
Informix
ifxjdbc.jar (Source DB 버전에 맞는 드라이버 사용)
데이터베이스의 운영 환경정보 노출 가능성이 있습니다.
Sample DB를 제거합니다.
Tibero의 중요 파일 중에 하나인 initialization 파일의 변경으로 시스템 장애가 발생합니다.
DB 기동 및 운영에 위협적인 영향을 줄 수 있습니다.
$ chmod 640 $TB_HOME/config/$TB_SID.tip 파일의 접근 권한을 설정합니다. (권장값 : 600 또는 640)
Tibero의 중요 파일인 Control 파일, Redo 로그 파일, 데이터 파일의 삭제 및 변경으로 시스템 장애가 발생합니다.
DB 운영 정지 및 데이터의 유실 위험이 있습니다.
Control 파일, Redo 로그 파일, 데이터 파일의 접근 권한을 설정합니다. (권장값 : 600 또는 640)
접근 권한을 640으로 설정한 경우
$ tbsql <username>/<password>로 접속하지 않습니다.
UTL_HTTP, UTL_FILE, DBMS_RANDOM, DBMS_LOB, DBMS_SQL, DBMS_JOB,
DBMS_OBFUSCATION_TOOLKITSQL> REVOKE EXECUTE ON <패키지명> FROM PUBLIC;LSNR_INVITED_IP_FILE="/home/tibero/tibero7/invited.list"# WAS_JEUS
192.168.22.20
192.168.44.10
### END OF FILE ####AUDIT Setting
AUDIT_TRAIL=OS
AUDIT_SYS_OPERATIONS=Y
AUDIT_FILE_DEST=/tibero/tbdata/audit/$ chmod 640 [Control 파일|Redo 로그 파일|데이터 파일]구분
설명
EXTENT SIZE
SORT_AREA_SIZE*2 + Block Size (기본 1MB 권장)
SORT AREA의 최대 크기
SORT_AREA_SIZE → 6KB, 세션 → 1000이라면 Sort 영역의 최대 크기는 16MB가 된다.
(기본값: (MEMORY_TARGET - TOTAL_SHM_SIZE) * 0.3)
SORT SEGMENT
인스턴스 시작 후 첫 SQL이 Temp 테이블 스페이스를 이용하여 Sort Segment를 생성한다. DB가 shutdown되면 release된다.
V$SORT_SEGMENT : SORT_SEGMENT영역 할당 및 해제 확인한다.
V$SORT_USAGE : SORT_SEGMENT를 사용하고 있는 사용자를 확인 한다.
V$TEMPFILE, DBA_TEMP_FILES : Temp 테이블 스페이스에 할당된 tempfiles을 확인한다.
대용량 데이터 이관 방법 및 고려사항, 예제와 데이터베이스 성능 개선에 대해 안내합니다.
이기종 데이터베이스를 이관할 때 대용량 테이블이 있다면 이관 방법을 통해 수행 시간을 단축할 수 있습니다. 고객사의 환경(네트워크, Disk I/O, 데이터 속성)을 고려하여 적절한 방법을 선택합니다.
아래는 이관 방법들의 특징에 대한 설명입니다.
T-UP
GUI 기반의 클라이언트 (네트워크 오버헤드가 커서 대용량 데이터를 이관할 경우 미권장)
DPL을 지원
아래는 각 데이터 이관 방법들이 지원하는 방식에 대한 설명입니다.
아래는 대용량 데이터를 이관할 때 고려해야 할 사항입니다.
충분한 네트워크 대역을 확보합니다.
IO 대역을 고려하여 스케줄 또는 DOP를 적용한다. DPL, Parallel DPL을 최대한 활용합니다.
DPL, Parallel DPL이 불가능할 때에는 CPL을 병렬로 수행합니다. (Multi Insert)
Index, Constraint, Trigger 등은 데이터 이관이 끝난 다음 생성합니다.
Parallel DPL의 경우 Tibero 5 r69848 이후부터 지원합니다.
SUBPARTITIONED TABLE은 DPL 또는 Parallel DPL을 미지원합니다.
IOT는 DPL 또는 Parallel DPL을 미지원합니다.
Partitioned INDEX의 경우 Normal Index만 DPL을 지원합니다.
본 문서는 총 2개의 장으로 구성됩니다.
대용량 데이터 이관 방법의 예제를 설명합니다.
🔎
각 상황에 따른 성능 개선 방법에 대해 설명합니다.
🔎
데이터베이스 계정 관리에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
개발 시스템과 운영 시스템을 하드웨어적으로 분리하여 Link가 설정되지 않아야 하며, 운영 시스템의 데이터를 개발 시스템으로 이전할 때 중요 데이터의 삭제 같은 통제와 검증 절차를 거쳐야 합니다.
운영 시스템의 중요 데이터가 개발 시스템으로 누출될 가능성이 있습니다.
개발 시스템과 운영 시스템의 분리를 회사의 정책으로 정의하고 개발자와 운영자를 원칙적으로 분리합니다. 만약 분리할 수 없다면 개발자가 운영 시스템에 접근할 경우 통제 절차를 거치도록 해야 합니다.
인가되지 않은 사용자가 DBA 권한으로 DBMS를 오용 및 남용할 수 있습니다.
DBA 권한을 사용하여 시스템 장애 및 데이터베이스를 변조할 가능성이 있습니다.
DBA 권한이 있는 계정의 사용자와 필요성을 확인합니다. 만약 불필요하게 DBA 권한이 허용된 계정이 있다면 계정을 없애거나 DBA 권한을 제거하고 데이터 누출 및 유실을 막기 위해 보안 정책을 수립합니다.
다음은 DBA 권한 제거 방법입니다.
SQL> REVOKE DBA FROM <username>;잘 알려진 디폴트 계정과 디폴트 패스워드를 이용하여 데이터베이스에 접근할 수 있습니다.
데이터베이스 접근 또는 상위 권한을 획득하여 데이터를 열람, 수정, 삭제할 수 있습니다.
OS, DB 레벨에서 원천적으로 접근을 제한하기 위해 사용하지 않는 애플리케이션 계정을 삭제합니다.
계정은 다른 용도로 사용하고 특정 데이터베이스의 접근만 제한해야 하는 경우 SUPER USER 또는 설치 계정 의 GROUP에서 삭제합니다.
디폴트 생성 DB 사용자(SYSCAT, SYSGIS, OUTLN, TIBERO, TIBERO1)의 디폴트 패스워드를 이용하여 인가되 지 않은 사용자가 DBMS에 접근할 수 있습니다.
데이터베이스 접근 및 상위 권한을 획득하여 데이터를 열람, 수정, 삭제할 수 있습니다.
사용하지 않는 디폴트 DB 계정은 삭제하거나 Lock 시키고, 사용하는 계정이라면 디폴트 패스워드를 수정합니다.
무제한으로 로그인 시도가 가능한 경우 Brute Force 공격으로 무제한 로그인 시도가 발생할 수 있습니다.
Brute Force 공격의 피해가 발생할 수 있습니다.
로그인 실패 횟수를 설정하는 FAILED_LOGIN_ATTEMPTS 항목을 설정하여 일정 횟수로 로그인을 실패할 경우 계정이 Lock 되게 합니다.
profile은 사용자 패스워드 관리 정책을 다양하게 생성하고 각각의 사용자에게 특정 정책을 사용하도록 지정 함으로써 사용자별로 그룹화된 패스워드 정책을 관리할 수 있는 기능을 제공합니다.
악의적인 사용자의 Brute Force 공격으로 무제한 로그인 시도가 발생할 수 있습니다.
Brute Force 공격의 피해가 발생할 수 있습니다.
패스워드 Lock 기간을 설정하는 PASSWORD_LOCK_TIME 항목을 설정하여 일정 시간동안 로그인을 할 수 없도록 계정이 Lock 되게 합니다. (기본값 : UNLIMITED, 권장값 : 1 또는 2 또는 24)
DBA_USERS 계정에 대해 주기적으로 패스워드를 변경하지 않고 취약한 패스워드로 설정할 경우 인증되지 않은 사용자에게 DBA 또는 USER 권한을 줄 수 있습니다.
권한이 노출되어 남용될 수 있습니다.
profile의 PASSWORD_LIFE_TIME 항목 설정값을 변경합니다. (기본값 : UNLIMITED, 권장값 : 30 ~ 90days)
profile 변경
DBA_USERS 계정의 패스워드를 변경할 때 패스워드 재사용 기간을 설정하지 않고 동일 패스워드를 사용할 경우 인증되지 않은 사용자에게 DBA 권한을 줄 수 있습니다.
권한이 노출되어 남용될 수 있습니다.
PASSWORD_REUSE_TIME에 지정한 날짜 동안에는 전에 사용했던 패스워드를 재사용하지 못하게 profile의 PASSWORD_REUSE_TIME 항목 설정값을 변경합니다. (기본값 : UNLIMITED, 권장값 : 30 ~ 90 days)
profile 변경
DB 권한 관리에 대한 위험 분석, 위험 영향, 해결 방안을 설명합니다.
개발 시스템과 운영 시스템을 하드웨어적으로 분리하여 Link가 설정되지 않아야 하며, 운영 시스템의 데이터를 개발 시스템으로 이전할 때 중요 데이터의 삭제 같은 통제와 검증 절차를 거쳐야 합니다.
운영 시스템의 중요 데이터가 개발 시스템으로 누출될 가능성이 있습니다.
개발 시스템과 운영 시스템의 분리를 회사의 정책으로 정의하고 개발자와 운영자를 원칙적으로 분리합니다. 만약 분리할 수 없다면 개발자가 운영 시스템에 접근할 경우 통제 절차를 거치도록 해야 합니다.
DBA가 SYS 패스워드를 입력하지 않고 접근하면 그룹을 가진 멤버들이 SYS 권한으로 로그인이 가능하므로 SYS 암호를 반드시 입력해야 합니다.
인증 없이 SYS 권한 획득이 가능합니다.
Tibero에는 Oracle의 sqlplus /as sysdba와 같은 접속 방법이 없으므로 해당사항이 없다.
Listener를 구동 또는 중지하는 작업은 DBA와 같은 특권자에게만 부여하며 Listener에 대한 접근 통제를 위해Listener 접근 패스워드를 설정해야 합니다.
비인가자의 Listener 접근이 가능합니다.
Tibero는 Listener와 서버 프로세스가 동시에 기동되기 때문에 해당사항이 없습니다.
운영에 중요한 환경 파일을 아무나 접근해서 수정할 경우 침입자가 환경 파일을 열어 설정값을 변경함으로써DB 운영에 영향을 줄 수 있습니다.
DBA_TEMP_FREE_SPACE
SQL> ALTER USER <username> ACCOUNT LOCK;SQL> ALTER USER <username> IDENTIFIED BY ‘<new_password>’;SQL> CREATE PROFILE <profile_name>
LIMIT PASSWORD_VERIFY_FUNCTION verify_function
FAILED_LOGIN_ATTEMPTS <횟수>;SQL> ALTER PROFILE <profile_name> LIMIT FAILED_LOGIN_ATTEMPTS <횟수>;SQL> ALTER USER <username> PROFILE <profile_name>;SQL> ALTER PROFILE <profile_name> LIMIT PASSWORD_LOCK_TIME <시간>;SQL> ALTER USER <username> PROFILE <profile_name>;SQL> ALTER PROFILE <profile_name> LIMIT PASSWORD_LIFE_TIME <일수>;SQL> ALTER USER <username> PROFILE <profile_name>;SQL> ALTER PROFILE <profile_name> LIMIT PASSWORD_REUSE_TIME <일수>;SQL> ALTER USER <username> PROFILE <profile_name>;LONG 컬럼이 포함된 255개 이상의 Column을 가진 테이블은 DPL을 미지원합니다.
LOB 계열의 컬럼이 있는 경우 DPL만 지원합니다.
INDEX가 생성되어 있는 경우 DPL만 지원합니다.
Table Migrator
테이블 단위로 데이터를 옮기는데 최적화된 툴
SELECT 옵션의 CONDITION, PARTITION을 지원
DPL, P-DPL을 지원
DB Link + DPI
SOURCE DB에 맞는 Gateway를 설치하고 DB LINK를 설정
APPEND 힌트를 통해 DPI를 지원
SAM 파일 + tbLoader
변화가 없는 테이블에 대해 SAM 파일로 내려 tbLoader를 이용하여 데이터를 로드
DPL, P-DPL을 지원
External Table + DPI 이용가능
Parallel Processing
O
O
O
$TB_HOME/config/$TB_SID.tip 파일의 퍼미션값을 변경합니다. (권장값 : 600 또는 640)
OS 계정에 의해 수정 및 관리되도록 하고 일반 계정의 접근을 금지합니다.
중요 파일에 불필요한 소유권 또는 그룹 권한이 주어질 경우 해당 파일로 인해 인증되지 않은 사용자가 정보를 획득할 수 있습니다.
시스템 또는 네트워크 환경설정 파일의 권한이 취약하게 설정되어 있거나 Tibero 사용자가 소유권을 가져야 하는 파일을 권한없는 사용자가 소유한다면비인가자가 시스템 권한을 획득하거나 중요 데이터를 파괴할 수 있습니다.
$TB_HOME/client/config/tbdsn.tbr 파일의 퍼미션값을 변경합니다. (권장값 : 600 또는 640)
Object의 사용 권한을 Public에 부여하면 Object 사용 권한이 없는 모든 계정이 해당 Object에 접근 가능하고Object의 정보를 획득할 수 있습니다.
새로 생성된 계정의 Object 사용 권한이 Public에 불필요하게 부여된 경우 권한 남용의 위험이 있습니다.
Object의 사용 권한이 불필요하게 Public에 부여된 경우 권한을 제한합니다.
다음은Public으로부터 권한을 제거하는 방법입니다.
GRANT 옵션과 함께 권한을 받은 사용자는 해당 권한을 다른 사용자에게 부여할 수 있습니다.
불필요하게 GRANT 옵션이 부여된 계정이 있는 경우 권한 남용의 위험이 있습니다. (단, 담당자가 확인하여 권한이 필요하다고 인정하는 경우는 제외합니다.)
GRANT 옵션 권한 부여는 DBA만 할 수 있도록 제한합니다. 불필요하게 GRANT 옵션이 부여된 계정은 권한을 제 거하고 GRANT 옵션 없이 권한을 다시 부여합니다.
ADMIN 옵션과 함께 시스템 권한을 받은 사용자는 해당 권한을 다른 사용자에게 부여할 수 있습니다.
불필요하게 ADMIN 옵션이 부여된 계정이 있는 경우 권한 남용의 위험이 있습니다. (단, 담당자가 확인하여 권한이 필요하다고 인정하는 경우는 제외합니다.)
ADMIN 옵션 권한 부여는 DBA만 할 수 있도록 제한합니다. 불필요하게 ADMIN 옵션이 부여된 계정은 권한을 제 거하고 ADMIN 옵션 없이 권한을 다시 부여합니다.
O
Select Condition
X
O
O
X
Direct Path Load
O
O
O
O
Multi Thread
O
O
X
O
Rows Per Commit
X
X
X
O
SQL> REVOKE <권한> ON <object> FROM PUBLICSQL> REVOKE <권한> ON <object명> FROM <user_name>;SQL> GRANT <권한> ON <object명> TO <user_name>;SQL> REVOKE <권한> ON <object명> FROM <user_name>;SQL> GRANT <권한> ON <object명> TO <user_name>;Table Migrator 유틸리티로 Oracle(Source DB)에서 Tibero(Target DB)로 DBMS 전환을 수행하는 예제입니다.
Oracle에 테스트 Table, 데이터, 접속할 계정을 생성합니다.
Oracle에 테스트 Table, 데이터, 접속할 계정을 생성합니다.
--DBTECH 계정에 Tablespace, User, Table, Table Data 생성
SQL> create tablespace DBTECH_TBS
2 datafile 'dbtech_tbs01.dtf' size 50M
3 AUTOEXTEND ON NEXT 20M MAXSIZE 5G
4 EXTENT MANAGEMENT LOCAL AUTOALLOCATE;
Tablespace created.
SQL> create user dbtech identified by dbtech
2 default tablespace DBTECH_TBS;
User created.
SQL> grant connect, resource to dbtech;
Grant succeeded.
CONNECT dbtech/dbtech;
SQL> create table board (no number,
2 empno number(4),
3 title varchar(20),
4 contents clob,
5 regdate date default sysdate,
6 hit number default 0)
7 PCTFREE 10
8 INITRANS 2;
Table created.
SQL> INSERT INTO BOARD VALUES
(1, 7369, 'introduction', 'Hello, my name is SMITH.', sysdate, 0);
1 row created.
SQL> INSERT INTO BOARD VALUES
(2, 7499, 'introduction', 'Hello, my name is ALLEN.', sysdate, 0);
1 row created.
SQL> INSERT INTO BOARD VALUES
(3, 7521, 'introduction', 'Hello, my name is WARD.', sysdate, 0);
1 row created.
SQL> INSERT INTO BOARD VALUES
(4, 7566, 'introduction', 'Hello, my name is JONES.', sysdate, 0);
1 row created.
SQL> INSERT INTO BOARD VALUES
(5, 7654, 'introduction', 'Hello, my name is MARTIN.', sysdate, 0);
1 row created.
SQL> commit;
Commit complete.
--Migration할 때 접속할 계정(DBTECH_TEST) 생성
SQL> CONNECT /as sysdba
Connected.
SQL> create user dbtech_test identified by dbtech_test
2 default tablespace DBTECH_TBS;
User created.
--DBTECH_TEST 계정에 권한 부여(connect)
SQL> grant connect to dbtech_test;
Grant succeeded.
--DBTECH_TEST 계정에 Table 조회 권한 부여(select on dbtech.board)
SQL> grant select on dbtech.board to dbtech_test;
Grant succeeded.
--DBTECH_TEST 계정에 권한 부여(select any dictionary)
SQL> grant select any dictionary to dbtech_test;
Grant succeeded.SQL> create tablespace DBTECH_TBS
2 datafile 'dbtech_tbs01.dtf' size 50M
3 AUTOEXTEND ON NEXT 20M MAXSIZE 5G
4 EXTENT MANAGEMENT LOCAL AUTOALLOCATE;
Tablespace 'DBTECH_TBS' created.
SQL> create user dbtech identified by dbtech
2 default tablespace DBTECH_TBS;
User 'DBTECH' created.
SQL> grant connect, resource, select any dictionary to dbtech;
Granted.
SQL> conn dbtech/dbtech
Connected to Tibero.
SQL> create table board (no number,
2 empno number(4),
3 title varchar(20),
4 contents clob,
5 regdate date default sysdate,
6 hit number default 0)
7 PCTFREE 10
8 INITRANS 2;
Table 'BOARD' created.
SQL> exit
Disconnected.
$ ls -lrt
-rw-r--r--. 1 tibero dba 1340431 Nov 15 15:29 antlr-4.3-complete.jar
-rw-r--r--. 1 tibero dba 1376 Nov 15 15:29 ANTLR4_License.txt
-rw-r--r--. 1 tibero dba 1604783 Nov 15 15:29 internal-jdbc-16.jar
-rw-r--r--. 1 tibero dba 167 Nov 15 15:29 migrator.bat
-rw-r--r--. 1 tibero dba 8313 Nov 15 15:29 migrator.properties.eg
-rw-r--r--. 1 tibero dba 170 Nov 15 15:29 migrator.sh
-rw-r--r--. 1 tibero dba 167137 Nov 15 15:29 migrator_cli.jar
-rw-r--r--. 1 tibero dba 352917 Nov 15 15:29 msllogger-14.jar
-rw-r--r--. 1 tibero dba 1320 Nov 15 15:29 pgjdbc_License.txt
-rw-r--r--. 1 tibero dba 850563 Nov 15 15:29 postgresql-42.2.27.jre6.jar
-rw-r--r--. 1 tibero dba 4054 Nov 15 15:29 readme.txt
-rw-r--r--. 1 tibero dba 123556 Nov 15 15:29 toolcom.jar
-rwxr-xr-x. 1 tibero dba 4210517 Nov 16 13:54 ojdbc6.jar
$sh migrator.sh SOURCE_TYPE=ORACLE SOURCE_URL=jdbc:oracle:thin:@localhost:1525:oraclesb SOURCE_USER=dbtech_test SOURCE_PASSWORD=dbtech_test SOURCE_LOGIN_AS=NORMAL SOURCE_SCHEMA=dbtech SOURCE_TABLE=board TARGET_URL=jdbc:internal:thin:@localhost:6213:JSH_T7_DB TARGET_USER=dbtech TARGET_PASSWORD=dbtech TARGET_SCHEMA=dbtech TARGET_TABLE=board
SOURCE_USER=dbtech_test SOURCE_PASSWORD=dbtech_test SOURCE_LOGIN_AS=NORMAL
SOURCE_SCHEMA=dbtech SOURCE_TABLE=board
TARGET_URL=jdbc:internal:thin:@localhost:6213:JSH_T7_DB TARGET_USER=dbtech
TARGET_PASSWORD=dbtech TARGET_SCHEMA=dbtech TARGET_TABLE=board
INFO[16:51:45,676][main]TableMigrator.initAndDoMigrate()(1429)
********************************************************************************
*
* Start Log for table migrator.
* Vendor: tibero
* Product: table migrator
* Version: 263750
*
* Trace is started on 16:51:45.675
* Log level: INFO
*
********************************************************************************
INFO[16:51:45,679][main]TableMigrator.initAndDoMigrate()(1431)
=== Parameters ===
SOURCE_TYPE=ORACLE
SOURCE_DRIVER=oracle.jdbc.OracleDriver
SOURCE_URL=jdbc:oracle:thin:@localhost:1525:oraclesb
SOURCE_USER=DBTECH_TEST
SOURCE_PASSWORD=************
SOURCE_LOGIN_AS=NORMAL
SOURCE_SCHEMA=dbtech
SOURCE_SCHEMAORIGN=dbtech
SOURCE_TABLE=board
SELECT_SUBPARTITION=
BATCH_THRESHOLD=128
EXTRACT_PARALLEL=N
EXTRACT_THREAD_COUNT=1
SOURCE_TABLE_DEDUPLICATE=N
USE_PARALLEL_HINT=N
PARALLEL_HINT_CNT=-1
USE_OBJECT_PARALLEL_HINT=N
TARGET_TYPE=DEFAULT
TARGET_DRIVER=com.m.internal.jdbc.MInternalDriver
TARGET_URL=jdbc:internal:thin:@localhost:6213:JSH_T7_DB
TARGET_USER=DBTECH
TARGET_PASSWORD=************
TARGET_SCHEMA=dbtech
TARGET_TABLE=board
COMMIT_SIZE=-1
INDEX_DISABLE=N
SELECT_FETCH_SIZE=1024
SELECT_AS_BYTE=N
DB_FILE_MULTIBLOCK_READ_COUNT=-1
INSERT_METHOD=dpl
INSERT_BATCH=Y
INSERT_PARALLEL=N
INSERT_THREAD_COUNT=1
INSERT_ZERO_LENGTH_STRING_AS_NULL=Y
DPL_LOG_UNIT=500
LOG_FILE_NAME=tableMigrator.log
LOG_LEVEL=INFO
CHECK_COLUMN_METADATA=N
==================
INFO[16:51:45,784][TabMig[16:51:45.680]]TbCmdConnection.connect()(58) Connect To The Source- URL : jdbc:oracle:thin:@localhost:1525:oraclesb ID : DBTECH_TEST
INFO[16:51:45,983][TabMig[16:51:45.680]]TbCmdConnection.connect()(58) Connect To The Target- URL : jdbc:internal:thin:@localhost:6213:JSH_T7_DB ID : DBTECH
INFO[16:51:46,228][TabMig[16:51:45.680]]TableMigrator.migrate()(256) SOURCE_TYPE : ORACLE
INFO[16:51:46,228][TabMig[16:51:45.680]]TableMigrator.migrate()(257) SOURCE_SCHEMA : dbtech
INFO[16:51:46,228][TabMig[16:51:45.680]]TableMigrator.migrate()(275) SOURCE_TABLE : board
INFO[16:51:46,229][TabMig[16:51:45.680]]TableMigrator.migrate()(277) TARGET_TYPE : DEFAULT
INFO[16:51:46,229][TabMig[16:51:45.680]]TableMigrator.migrate()(278) TARGET_SCHEMA : dbtech
INFO[16:51:46,229][TabMig[16:51:45.680]]TableMigrator.migrate()(293) TARGET_TABLE : board
INFO[16:51:46,236][TabMig[16:51:45.680]]OracleTableInfo.getTableInfo()(52) SELECT column_name, data_type, virtual_column, hidden_column FROM DBA_TAB_COLS WHERE OWNER=? AND TABLE_NAME=? order by column_id
INFO[16:51:46,292][TabMig[16:51:45.680]]OracleTableInfo.getTableInfo()(55) setString(1) : DBTECH
INFO[16:51:46,292][TabMig[16:51:45.680]]OracleTableInfo.getTableInfo()(58) setString(2) : BOARD
INFO[16:51:46,308][TabMig[16:51:45.680]]OracleTableInfo.getTableInfo()(125) SELECT iot_type FROM dba_tables WHERE OWNER = ? and TABLE_NAME = ?
INFO[16:51:46,309][TabMig[16:51:45.680]]OracleTableInfo.getTableInfo()(128) setString(1) : DBTECH
INFO[16:51:46,309][TabMig[16:51:45.680]]OracleTableInfo.getTableInfo()(131) setString(2) : BOARD
INFO[16:51:46,311][TabMig[16:51:45.680]]TableMigrator.migrate()(375) start extracting thread...
INFO[16:51:46,315][TabMig[16:51:45.680].E0]OracleDataExtractor.run()(86) run
INFO[16:51:46,315][TabMig[16:51:45.680].E0]DataExtractor.loggingTabAndColInfo()(531) Extract Information
INFO[16:51:46,316][TabMig[16:51:45.680].E0]DataExtractor.loggingTabAndColInfo()(532) table name : DBTECH.BOARD
INFO[16:51:46,316][TabMig[16:51:45.680].E0]DataExtractor.loggingTabAndColInfo()(538) columns [6] - "NO" "EMPNO" "TITLE" "REGDATE" "HIT" "CONTENTS"
INFO[16:51:46,318][TabMig[16:51:45.680].E0]OracleDataExtractor.run()(93) TabMig[16:51:45.680].E0 - sql : SELECT '0', t."NO", t."EMPNO", t."TITLE", t."REGDATE", t."HIT", t."CONTENTS" FROM DBTECH.BOARD t
INFO[16:51:46,327][TabMig[16:51:45.680]]TableMigrator.migrate()(536) start loading thread...
INFO[16:51:46,328][TabMig[16:51:45.680]]DataLoader.setRemainThr()(85) Set Remain Threads [0], to [1]
INFO[16:51:46,332][L0]TbDPLDataLoader.setDirPathStream()(525) DPL Loading Information
INFO[16:51:46,332][L0]TbDPLDataLoader.setDirPathStream()(526) table name : dbtech.board
INFO[16:51:46,332][L0]TbDPLDataLoader.setDirPathStream()(532) columns [6] - "NO" "EMPNO" "TITLE" "REGDATE" "HIT" "CONTENTS"
INFO[16:51:46,337][TabMig[16:51:45.680].E0]OracleDataExtractor.run()(282)
Total Extract Time : 20ms
Time For Putting Row on Queue : 0ms
Time For Executing Query Time : 12ms
Time For Executing Fetch Time : 4ms
Percentage of Query and Fetch => 80.00%
INFO[16:51:46,337][TabMig[16:51:45.680].E0]OracleDataExtractor.run()(283) TOTAL Extracted ROWS: 5 (source schema = DBTECH, source table = BOARD)
INFO[16:51:46,338][TabMig[16:51:45.680]]TableMigrator.migrate()(580) Extractor termFlag : [true], isError : [false]
INFO[16:51:46,338][TabMig[16:51:45.680].E0]DataExtractor.setTermFlag()(543) Set termFlag and isError : [false]
INFO[16:51:46,338][TabMig[16:51:45.680].E0]DataExtractor.setTermFlag()(544) complete
INFO[16:51:46,354][L0.TbDPLDataLoader0]DataLoaderManager.run()(47) run
INFO[16:51:46,361][L0.TbDPLDataLoader0]DataLoaderManager.run()(240) Total Insert Time : 29ms
Time For Taking Row From Queue: 0ms
Time For Executing Batch : 4ms
Time For Executing Commit : 2ms
Percentage of Batch and Commit Time => 20.69%
INFO[16:51:46,361][L0.TbDPLDataLoader0]DataLoaderManager.run()(242) [L0.TbDPLDataLoader0]1700121106361 TOTAL Loaded ROWS: 5 (target schema = dbtech, target table = board)
INFO[16:51:46,374][TabMig[16:51:45.680]]TableMigrator.migrate()(613) Loader remainThr : [0], isError : [false]
INFO[16:51:46,374][L0.TbDPLDataLoader0]DataLoader.finish()(80) Decrement remainThr : [0] and isError : [false]
INFO[16:51:46,375][TabMig[16:51:45.680]]TableMigrator.resetThrs()(1359) terminate extract thread...1
INFO[16:51:46,375][TabMig[16:51:45.680]]TableMigrator.resetThrs()(1373) terminate loader thread...1
INFO[16:51:46,375][TabMig[16:51:45.680]]TableMigrator.migrate()(627) [VERIFICATION] Source Info : dbtech.board : 5 Rows, Target Info : dbtech.board : 5 Rows [OK]
INFO[16:51:46,375][TabMig[16:51:45.680]]TableMigrator.migrate()(686) extract conneciton close
INFO[16:51:46,377][TabMig[16:51:45.680]]TableMigrator.migrate()(695) loader connection close
INFO[16:51:46,377][TabMig[16:51:45.680]]TableMigrator.migrate()(705) Elapsed Time (milliseconds) : 697
INFO[16:51:46,377][TabMig[16:51:45.680]]TableMigrator.migrate()(707) End Migration티베로 DB 데이터 타입별 크기 산정 방법에 대해 설명합니다.
아래 표는 테이블과 인덱스 크기 시트의 계산식에서 적용되는 데이터 타입별 실제 소비 사이즈이며 저장 되는 크기는 산정 길이 +1로 합니다. 예를 들면 데이터의 산정 길이는 8bytes이며 실제 저장 데이터는 8+1=9bytes입니다.
문자형
타입
고정/ 가변
숫자형
날짜형
간격형
대용량 객체형
내재형
NULL일 때
크기가 0일 때
크기가 4000보다 작을 때
크기가 96KB 보다 작을 때
그 이상일 때
위 계산에서 LOB 데이터를 별도 segment로 저장하기 위한 overhead는 계산하지 않습니다.
long의 경우 데이터의 길이가 길어지면 chained row piece로 나뉘어서 저장되는데, row piece를 연결시키기 위한 추가 overhead는 고려하지 않습니다.
독립적인 가상화 환경을 생성하는 도커 플랫폼의 이미지를 활용함으로써 더욱 편리하고 안정적으로 Tibero를 설치하는 방법을 안내합니다.
아래 두 가지 방법 중 적합한 방식으로 도커 이미지를 사용합니다.
아래 경로에서 Tibero 공식 도커 이미지를 다운로드 합니다.
Tibero 공식 도커 이미지 다운로드
Tibero 7 패치셋 버전 업데이트
적합한 바이너리를 다운로드 받아 tibero.tar.gz 파일명으로 변경합니다. Dockerfile 과 동일한 경로에 바이너리 파일을 위치합니다.
도커 이미지 빌드를 위해 도커파일(Dockerfile)을 생성합니다.
아래 예시는 rockylinux9 을 사용합니다. 준비한 티베로 바이너리의 Major 버전으로 TB_VERSION 을 수정합니다.
컨테이너 이미지에 필요한 패키지를 설치하는 스크립트입니다.
필요한 패키지가 있다면 스크립트에 추가합니다. Dockerfile 과 같은 경로의 scripts 디렉토리 내 install_dependency.sh 파일명으로 생성합니다.
Dockerfile에 작성한 ENTRYPOINT 로 컨테이너 생성, 재시작 시 수행되는 스크립트입니다. Dockerfile 과 같은 경로의 scripts 디렉토리 내 entrypoint.sh 파일명으로 생성합니다.
Tibero 설치 스크립트로 바이너리 내 tb_create_db.sh 를 사용합니다. Dockerfile 과 같은 경로의 scripts 디렉토리 내 install_tibero.sh 파일명으로 생성합니다.
아래 커맨드를 통해 도커 이미지를 빌드합니다. 원하는 이미지명과 태그로 수정해서 사용합니다.
이때 도커 이미지 빌드를 위해 필요한 파일은 아래와 같습니다.
아래 Tibero 공식 도커허브를 참고하여, 빌드한 도커 이미지를 통해 컨테이너를 생성합니다.
Tibero 공식 도커 허브
주의
Tibero 바이너리 압축파일명은 반드시 "tibero.tar.gz" 로 지정 합니다.
FROM rockylinux:9
# Tibero 설치를 위한 환경 변수 설정
ENV TB_VERSION=7
ENV TB_BASE=/opt
ENV TB_HOME=$TB_BASE/tibero$TB_VERSION
ENV LD_LIBRARY_PATH=$TB_HOME/lib:$TB_HOME/client/lib
ENV PATH=$PATH:$TB_HOME/bin:$TB_HOME/client/bin
# Tibero 바이너리 파일 복사
COPY tibero.tar.gz /tmp/tibero.tar.gz
# 필수 패키지 설치
COPY ./scripts/install_dependency.sh /opt/install_dependency.sh
RUN chmod +x /opt/install_dependency.sh
RUN /opt/install_dependency.sh
# Tibero 설치
COPY ./scripts/install_tibero.sh /opt/install_tibero.sh
RUN chmod +x /opt/install_tibero.sh
# Entrypoint 스크립트 복사 및 권한 설정
COPY ./scripts/entrypoint.sh /opt/entrypoint.sh
RUN chmod +x /opt/entrypoint.sh
ENTRYPOINT ["/opt/entrypoint.sh"]#!/bin/bash
set -e
# Install dependencies for Tibero
dnf update -y
dnf install -y gcc
dnf install -y gcc-c++
dnf install -y libaio
dnf install -y libaio-devel
dnf install -y sysstat
dnf install -y glibc-utils
dnf install -y ncurses-devel
dnf install -y libnsl
dnf install -y libnsl2
dnf install -y gdb
dnf install -y gdb-doc
dnf install -y gdb-gdbserver
dnf install -y gdb-headless
dnf install -y gdb-minimal
dnf install -y gdbm-libs
dnf install -y tar
dnf install -y vim
dnf install -y vi
dnf install -y hostname
# Tibero process 확인용 (pgrep)
dnf install -y procps-ng
dnf clean all
curl -O https://dl.fedoraproject.org/pub/epel/epel-release-latest-9.noarch.rpm
rpm -ivh epel-release-latest-9.noarch.rpm
dnf install -y nmon
dnf install -y java-1.8.0-openjdk-devel
dnf install -y ncurses-compat-libs
ln -s /usr/lib64/libncurses.so.6.2 /usr/lib64/libncurses.so.5 || true
ln -s /usr/lib64/libtinfo.so.6.2 /usr/lib64/libtinfo.so.5 || true
ln -s /usr/lib64/libform.so.6.2 /usr/lib64/libform.so.5 || true#!/usr/bin/env bash
set -euo pipefail
# BOOT_POLICY=auto(기본) | manual
: "${BOOT_POLICY:=auto}"
: "${INSTALL_TGZ:=/tmp/tibero.tar.gz}"
: "${TB_PROC:=tbsvr}" # Tibero 메인 프로세스명
: "${TB_START_CMD:=tbboot}" # Tibero 기동 명령
: "${TB_DOWN_CMD:=tbdown}" # Tibero 종료 명령
if [ -f /etc/bashrc ]; then
set +u
# /etc/bashrc 내부에서 BASHRCSOURCED를 사용할 수 있으므로 기본값 보장
: "${BASHRCSOURCED:=0}"
source /etc/bashrc || true
set -u
fi
if [ -f "${HOME}/.bashrc" ]; then
set +u
: "${BASHRCSOURCED:=0}"
source "${HOME}/.bashrc" || true
set -u
fi
graceful_shutdown() {
echo "[signal] Shutting down database (if running)..."
${TB_DOWN_CMD} immediate >/dev/null 2>&1 || true
exit 0
}
trap graceful_shutdown SIGINT SIGTERM
# ===== 수동 모드: 설치/기동 모두 생략, 컨테이너만 유지 =======================
if [[ "${BOOT_POLICY}" == "manual" ]]; then
echo "[mode] BOOT_POLICY=manual → skip install/boot. keeping container alive."
echo "[note] even if ${INSTALL_TGZ} exists, will NOT install. will NOT run tbboot."
# 컨테이너 생존 유지
exec sleep infinity
fi
# ===== 자동 모드: 설치 및 기동 시도 ==========================================
# 1) 최초 생성 판단: tar.gz 존재시 설치 시도
if [ -f "${INSTALL_TGZ}" ]; then
echo "[init] Found ${INSTALL_TGZ} → running /opt/install_tibero.sh ..."
/opt/install_tibero.sh
fi
# 2) 서버 기동 시도
if ! pgrep "${TB_PROC}" >/dev/null 2>&1; then
echo "[start] Starting Tibero..."
if ! ${TB_START_CMD} >/dev/null 2>&1; then
echo "[error] Failed to start Tibero (${TB_START_CMD}). Check logs."
exit 1
fi
fi
# 3) 기동 검증
if pgrep "${TB_PROC}" >/dev/null 2>&1; then
echo "#########################"
echo "Tibero is Ready To Use!"
echo "#########################"
else
echo "[error] Tibero process not found after start attempt."
exit 1
fi
# 4) 컨테이너 생존 유지 (로그 tail이 필요 없으면 단순 sleep으로 유지)
exec sleep infinity#!/bin/bash
set -e
if [ -f "/tmp/tibero.tar.gz" ]; then
: "${TB_BASE:?TB_BASE is required}"
mkdir -p "${TB_BASE}"
tar -xzf "/tmp/tibero.tar.gz" -C "${TB_BASE}" && rm -f "/tmp/tibero.tar.gz"
chmod -R 775 $TB_HOME
fi
echo "10% complete"
echo "Setting Environment Variables"
if [[ -n "${TB_USER_FILE:-}" && -f "${TB_USER_FILE}" ]]; then
TB_USER="$(< "${TB_USER_FILE}")"
export TB_USER
fi
if [[ -n "${TB_PASSWORD_FILE:-}" && -f "${TB_PASSWORD_FILE}" ]]; then
TB_PASSWORD="$(< "${TB_PASSWORD_FILE}")"
export TB_PASSWORD
fi
# 루트 패스워드 필수
if [[ -z "${TB_ROOT_PASSWORD:-}" ]]; then
echo "[ERROR] TB_ROOT_PASSWORD environment variable is not set. Exiting." >&2
exit 1
fi
if [[ -n "${TB_ROOT_PASSWORD_FILE:-}" && -f "${TB_ROOT_PASSWORD_FILE}" ]]; then
TB_ROOT_PASSWORD="$(< "${TB_ROOT_PASSWORD_FILE}")"
export TB_ROOT_PASSWORD
fi
: "${TB_HOME:?TB_HOME is required}"
if [ -f "${TB_HOME}/bin/base_env.sh" ]; then
sed -i "s|^svr_sys_password=\"tibero\"$|svr_sys_password=\"${TB_ROOT_PASSWORD}\"|" \
"${TB_HOME}/bin/base_env.sh"
fi
: "${TB_SID:=tibero}"
export TB_SID
echo "export TB_VERSION=\"${TB_VERSION}\"" >> "${HOME}/.bashrc"
echo "export TB_BASE=\"${TB_BASE}\"" >> "${HOME}/.bashrc"
echo "export TB_HOME=\"${TB_HOME}\"" >> "${HOME}/.bashrc"
echo "export LD_LIBRARY_PATH=\"${LD_LIBRARY_PATH}\"" >> "${HOME}/.bashrc"
echo "export PATH=\"${PATH}\"" >> "${HOME}/.bashrc"
echo "export TB_SID=\"${TB_SID}\"" >> "${HOME}/.bashrc"
echo "20% complete"
# Generating Tip file
echo "Generating tip file"
TIP_FILE_PATH=${TB_HOME}/config/${TB_SID}.tip
"${TB_HOME}/config/gen_tip.sh" -s "${TB_SID}"
# LOG_ARCHIVE_DEST 반영 (있으면 교체, 없으면 추가)
if [ -n "${LOG_ARCHIVE_DEST:-}" ]; then
if grep -q "^LOG_ARCHIVE_DEST=" "${TIP_FILE_PATH}"; then
sed -i "s|^LOG_ARCHIVE_DEST=.*|LOG_ARCHIVE_DEST=${LOG_ARCHIVE_DEST}|" "${TIP_FILE_PATH}"
else
printf "\nLOG_ARCHIVE_DEST=%s\n" "${LOG_ARCHIVE_DEST}" >> "${TIP_FILE_PATH}"
fi
fi
echo "30% complete"
# # Setting DB Create environment variables
args=()
[ -n "$CHAR_SET" ] && args+=("-ch" "$CHAR_SET")
[ -n "$NCHAR_SET" ] && args+=("-nch" "$NCHAR_SET")
[ -n "$MAX_DATAFILE" ] && args+=("--max-datafile" "$MAX_DATAFILE")
[ -n "$MAX_LOGGROUP" ] && args+=("--max-loggroup" "$MAX_LOGGROUP")
[ -n "$MAX_LOGMEMBER" ] && args+=("--max-logmember" "$MAX_LOGMEMBER")
[ -n "$LOG_SIZE" ] && args+=("--log-size" "$LOG_SIZE")
[ -n "$LOG_GROUP" ] && args+=("--log-group" "$LOG_GROUP")
[ -n "$LOG_FILE" ] && args+=("--log-file" "$LOG_FILE")
[ -n "$LOG_DIR" ] && args+=("--log-dir" "$LOG_DIR")
[ -n "$SYS_SIZE" ] && args+=("--sys-size" "$SYS_SIZE")
[ -n "$SYS_DIR" ] && args+=("--sys-dir" "$SYS_DIR")
[ -n "$SYS_AUTOEXTEND" ] && args+=("--sys-autoextend" "$SYS_AUTOEXTEND")
[ -n "$SYS_NEXTSIZE" ] && args+=("--sys-nextsize" "$SYS_NEXTSIZE")
[ -n "$SYS_MAXSIZE" ] && args+=("--sys-maxsize" "$SYS_MAXSIZE")
[ -n "$TEMP_SIZE" ] && args+=("--temp-size" "$TEMP_SIZE")
[ -n "$TEMP_DIR" ] && args+=("--temp-dir" "$TEMP_DIR")
[ -n "$TEMP_AUTOEXTEND" ] && args+=("--temp-autoextend" "$TEMP_AUTOEXTEND")
[ -n "$TEMP_NEXTSIZE" ] && args+=("--temp-nextsize" "$TEMP_NEXTSIZE")
[ -n "$TEMP_MAXSIZE" ] && args+=("--temp-maxsize" "$TEMP_MAXSIZE")
[ -n "$UNDO_SIZE" ] && args+=("--undo-size" "$UNDO_SIZE")
[ -n "$UNDO_DIR" ] && args+=("--undo-dir" "$UNDO_DIR")
[ -n "$UNDO_AUTOEXTEND" ] && args+=("--undo-autoextend" "$UNDO_AUTOEXTEND")
[ -n "$UNDO_NEXTSIZE" ] && args+=("--undo-nextsize" "$UNDO_NEXTSIZE")
[ -n "$UNDO_MAXSIZE" ] && args+=("--undo-maxsize" "$UNDO_MAXSIZE")
[ -n "$USR_SIZE" ] && args+=("--usr-size" "$USR_SIZE")
[ -n "$USR_DIR" ] && args+=("--usr-dir" "$USR_DIR")
[ -n "$USR_AUTOEXTEND" ] && args+=("--usr-autoextend" "$USR_AUTOEXTEND")
[ -n "$USR_NEXTSIZE" ] && args+=("--usr-nextsize" "$USR_NEXTSIZE")
[ -n "$USR_MAXSIZE" ] && args+=("--usr-maxsize" "$USR_MAXSIZE")
[ -n "$SYSSUB_SIZE" ] && args+=("--syssub-size" "$SYSSUB_SIZE")
[ -n "$SYSSUB_DIR" ] && args+=("--syssub-dir" "$SYSSUB_DIR")
[ -n "$SYSSUB_AUTOEXTEND" ] && args+=("--syssub-autoextend" "$SYSSUB_AUTOEXTEND")
[ -n "$SYSSUB_NEXTSIZE" ] && args+=("--syssub-nextsize" "$SYSSUB_NEXTSIZE")
[ -n "$SYSSUB_MAXSIZE" ] && args+=("--syssub-maxsize" "$SYSSUB_MAXSIZE")
[ -n "$BACKUP_CTRLFILE" ] && args+=("--backup-ctrlfile" "$BACKUP_CTRLFILE")
[ -n "$SYSTEM_SCRIPT" ] && args+=("--system-script" "$SYSTEM_SCRIPT")
# creating the database
echo "Creating the database"
$TB_HOME/bin/tb_create_db.sh "${args[@]}"
echo "70% complete"
# Setting Archive log mode
if [ -n "$ARCHIVE_LOG_MODE" ] && [ "$ARCHIVE_LOG_MODE" == "Y" -o "$ARCHIVE_LOG_MODE" == "y" ]; then
echo "Setting Archive log mode"
tbdown
tbboot mount
tbsql sys/"$TB_ROOT_PASSWORD" <<EOF
ALTER DATABASE ARCHIVELOG;
EOF
tbdown
tbboot
fi
echo "90% complete"
# Setting up the database user
echo "Setting up the database user"
if { [ -n "${TB_USER:-}" ] && [ -z "${TB_PASSWORD:-}" ]; } || \
{ [ -z "${TB_USER:-}" ] && [ -n "${TB_PASSWORD:-}" ]; }; then
echo "Cannot create database user: both TB_USER and TB_PASSWORD must be provided."
fi
if [ -n "${TB_USER:-}" ] && [ -n "${TB_PASSWORD:-}" ]; then
tbsql "sys/${TB_ROOT_PASSWORD}" <<EOF
create user ${TB_USER} identified by '${TB_PASSWORD}';
grant dba to ${TB_USER};
EOF
fi
echo "100% complete"
echo "Tibero installation and database creation completed successfully."docker build -t <이미지명>:<태그> ..
├── Dockerfile
├── tibero.tar.gz
└── scripts
├── entrypoint.sh
├── install_dependency.sh
└── install_tibero.sh가변
NUMBER와 같다.
FLOAT
가변
NUMBER와 같다.
TIMESTAMP
가변
12bytes
TIMESTAMP WITH TIME ZONE
고정 1
7bytes
TIMESTAMP WITH LOCAL TIME ZONE
고정
12bytes
가변
실제로 저장되는 데이터의 길이 ("" 참조)
XMLTYPE
가변
CLOB과 같다.
길이 산정 예
설명
CHAR
고정/ 가변
CHAR(10) = 10bytes
CHAR(10 BYTE), CHAR(10 CHAR) 문자열의 길이는 byte와 문자를 기준으로 지정한다.
CHAR(10)의 형태로 선언하면, byte로 문자 열의 길이가 지정된다.
CHAR로 길이를 선언하면 문자가 몇 byte로 표현되는지에 따라 그 길이가 달라진다.
VARCHAR
가변
VARCHAR 가변 VARCHAR(10) =
(10*0,7)= 7bytes
지정된 데이터 길이의 0.7로 가정
NCHAR
고정
NCHAR(10) = 30bytes(UTF8),
20bytes(UTF16 )
UTF8 : size의 최대 3배
UTF16 : size의 최대 2배
NVARCHAR
가변
NVARCHAR(10) = (10*0.7)*3 =
21bytes(UTF8), 14bytes(UTF16)
UTF8 : size의 최대 3배
UTF16 : size의 최대 2배
RAW
가변
실제로 저장되는 데이터의 길이
LONG
가변
실제로 저장되는 데이터의 길이
LONG RAW
가변
실제로 저장되는 데이터의 길이
타입
고정/ 가변
길이 산정 예
설명
NUMBER
가변
NUMBER(7)
=roundup(7/2) = 4bytes
roundup(size/2) size가 38 자리수보다 크면 38 로 정 의하고 38 자리수 미만의 음수는 1byte를 더한다.
타입
고정/가변
길이 산정 예
DATE
고정
8bytes
TIME
고정
타입
고정/가변
길이 산정 예
INTERVAL YEAR TO MONTH
고정
5bytes
INTERVAL DAY TO SECOND
고정
타입
고정/가변
길이 산정 예
설명
CLOB
가변
실제로 저장되는 데이터의 길이 ("LOB Type 저장에 필요한 overhead" 참조)
타입
고정/가변
길이 산정 예
설명
ROWID
고정
10bytes
0byte16bytes(lob locator)16bytes(lob locator) + 16bytes(lob inode)16bytes(lob locator) + 16bytes(lob inode) + 48bytes(12 page dbas)16bytes(lob locator) + 16bytes(lob inode) + 48bytes * (LOB 컬럼 크기 / 64KB)(lob index)INTEGER
8bytes
12bytes
BLOB
Tibero DB 테이블 크기 산정 방법에 대해 설명합니다.
테이블 크기를 산정하기 위해서는 컬럼의 데이터 타입별 실제 소비 크기와 저장되는 길이를 산정해야 합니다. 이 정보는 테이블 크기를 산정하기 위한 항목별 크기 산정 방법에 사용됩니다.
아래는 컬럼 정의 및 계산 방식의 예입니다. 크기 산정 테이블은 5개의 컬럼으로 구성되었다고 가정합니다.
이름
데이터타입
데이터길이
비고
""의 데이터 타입별 사이즈 표를 참고하여 위 테이블을 구성하는 각 컬럼의 데이터 타입별 실제 소비사이즈를 산정하면 아래와 같습니다.
테이블 크기를 산정하기 위해 필요한 항목은 아래와 같습니다.
크기 예는 각 항목별로 기본으로 정해진 크기, 파라미터로 설정할 수 있는 크기와 운영할 시스템에서 사전 조사된 수치를 나타냅니다.
250bytes 이하 및 초과 컬럼 개수는 Row의 데이터 길이 테이블을 참고합니다. 초기 예상 건수, 월중 예상 추가 건수, 데이터 보관 월 수는 운영할 시스템의 사용자 환경의 정보입니다.
본 절에서는 Tibero에서 테이블 크기를 산정하는 방법에 대해서 설명합니다.
block당 사용 가능한 데이터 공간 크기입니다.
데이터베이스 파라미터 지정 과정을 예시와 함께 설명합니다.
파라미터를 지정하는 컨트롤 파일은 기본으로 migrator.properties 파일로 지정됩니다.
(migrator.properties 파일에 설정)
SOURCE_TYPE=ORACLE
SOURCE_DRIVER=oracle.jdbc.OracleDriver
SOURCE_URL=jdbc:oracle:thin:@localhost:1539:orcl
SOURCE_USER=sys
SOURCE_PASSWORD=oracle
SOURCE_LOGIN_AS=sysdba
SOURCE_SCHEMA=SCOTT
SOURCE_TABLE=t1
SOURCE_TABLE_DEDUPLICATE=N
TARGET_TYPE=DEFAULT
TARGET_DRIVER=com.m.internal.jdbc.MInternalDriver
TARGET_URL=jdbc:internal:thin:@localhost:59166:tibero
TARGET_USER=tibero
TARGET_PASSWORD=tmax
TARGET_SCHEMA=TIBERO
TARGET_TABLE=t1
EXTRACT_PARALLEL=N
EXTRACT_PARALLEL_RANGE_BY_ROWID=N
EXTRACT_THREAD_COUNT=1
SELECT_TSN=17322052
SELECT_CONDITION= c1>1
SELECT_FETCH_SIZE=1024
SELECT_PARTITION=part1
SELECT_SUBPARTITION=subpar1
SELECT_AS_BYTE=N
DB_FILE_MULTIBLOCK_READ_COUNT=-1
OPTIMIZER_HINT=/*+ FULL(t) PARALLEL(t, 4) */
USE_PARALLEL_HINT=N
USE_OBJECT_PARALLEL_HINT=N
PARALLEL_HINT_CNT=-1
INSERT_METHOD=dpl
COMMIT_SIZE=-1
INDEX_DISABLE=N
INSERT_BATCH=Y
BATCH_THRESHOLD=128
DPL_LOG_UNIT=500
INSERT_PARALLEL=N
INSERT_THREAD_COUNT=1
INSERT_PARTITION=
INSERT_ZERO_LENGTH_STRING_AS_NULL=Y
TRIM=
BYTEA_TO_BLOB=N
TEXT_TO_CLOB=N
MONITORING_LOG=N
MONITORING_LOG_UNIT=500
MONITORING_SESS_STAT=CPU used by this session;parse time cpu;parse count(hard)
CHECK_COLUMN_METADATA=N
ROW_QUEUE_TYPE=ARRAY(10240)
VERIFY_TABLE=N
VERIFY_TABLE_NAME=VERIFY_TBL
LOG_LEVEL=INFO
LOG_FILE_NAME=tableMigrator.log
LOG_DIR=각 파라미터의 설명은 아래와 같습니다.
c1
CHAR(10)
10
c2
DATE
8
c3
NUMBER(7,2)
4
roundup(7/2)
c4
CHAR(500)
500
c5
VARCHAR(3000)
2,100
3,000 * 0,7
Row의 데이터 길이
2,622
c1 + c2+ c3 + c4 + c5
구분
설명
CHAR
문자열의 길이는 byte와 문자를 기준으로 지정한다. CHAR(10) = 10, CHAR(500) = 500
DATE
고정 8bytes 이다.
NUMBER
항목
크기 예
단위
설명
Row Directory
2
bytes
row 하나당 bytes
한 Row 저장에 필요한 공간 = Row Directory + Row Header + Row의 데이터 길이
+ (1 * <250bytes 이하 컬럼개수>) + (3 * <250bytes 초과 컬럼개수>)Row Directory
2
2
한 블록의 데이터 공간 = (Block Size - Block Header - ITL공간) * (100 - PCTFREE) / 100항목
사전 정보 크기
실제 저장 크기
비고
Block Size
8192
8192
/ Row Space ( 한 블록의 데이터 공간 / 한 Row의 저장에 필요한 공간 )항목
사전 정보 크기
실제 저장 크기
비고
Data Space per Block
7,286
7,286
총 데이터 Row 개수 = <초기 예상 건수> + <월중 예상 추가 건수> * (<데이터 보관 월 수> + 1)항목
사전 정보 크기
실제 저장 크기
비고
초기 예상 건수
100,000
100,000
필요한 총 데이터 공간 = Block Size * Total Row Size / Row Size per Block (Block Size
* 총 데이터 Row 개수 / 한 블록에 들어갈 수 있는 Row 개수)항목
사전 정보 크기
실제 저장 크기
비고
Block Size
8,192
8,192
SOURCE_TYPE
Source DB의 타입을 설정하는 파라미터 – ORACLE(기본값) : Source DB가 Oracle일 때 설정하며 SOURCE_LOGIN_AS 파라미터의 설정이 필요 – GENERIC : Source DB가 일반 DB일 때 설정한다. 특정 벤더별 API를 사용하지 않고 표준 JDBC API만을 이용하여 동작하며 SOURCE_DRIVER 파라미터의 설정이 필요 – DEFAULT : Source DB가 Tibero일 때 설정
SOURCE_DRIVER
Source DB에 접속할 때 사용하는 JDBC Driver 클래스를 설정하는 파라미터로 SOURCE_TYPE=GENERIC일 경우 설정이 필요 – Oracle(기본값) : oracle.jdbc.OracleDriver – MSSQL : com.microsoft.sqlserver.jdbc.SQLServerDriver – DB2 : com.ibm.db2.jcc.DB2Driver – MYSQL : com.mysql.jdbc.Driver – PostgreSQL : org.postgresql.Driver – Sybase ASE : com.sybase.jdbc3.jdbc.SybDriver – Informix : com.informix.jdbc.IfxDriver
SOURCE_URL
Source DB의 JDBC 연결 URL을 설정하는 파라미터 – Oracle(기본값) : jdbc:oracle:thin:@localhost:1521:orcl – MSSQL : jdbc:sqlserver://127.0.0.1:1433;databaseName=master – DB2 : jdbc:db2://127.0.0.1:50000/logdb – MYSQL : jdbc:mysql://127.0.0.1:3306/mysql – PostgreSQL : jdbc:postgresql://127.0.0.1:5432/postgres – Sybase ASE : jdbc:sybase:Tds:127.0.0.1:7100?ServiceName=sybase – Informix : jdbc:informix-sqli://127.0.0.1:18220/informix:INFORMIXSERVER=informix
SOURCE_USER
Source DB에 로그인하는 사용자 이름을 설정하는 파라미터
기본적으로 대문자로 인식되며 큰따옴표를 통해 대소문자 구분이 가능 (기본값 : sys)
SOURCE_PASSWORD
Source DB에 로그인 하는 사용자 패스워드를 설정하는 파라미터 (기본값 : oracle)
SOURCE_LOGIN_AS
Oracle에 접속할 때 권한을 설정하는 파라미터로 SOURCE_TYPE=ORACLE인 경우에만 설정 – SYSDBA(기본값) – NORMAL
SOURCE_SCHEMA
Source DB에서 이관하는 Table의 실제 사용자 이름을 설정하는 파라미터기본적으로 대문자로 인식되며 큰따옴표를 통해 대소문자 구분이 가능 (기본값 : SOURCE_USER에서 설정한 사용자 이름)
SOURCE_TABLE
Source DB에서 이관하는 Table 이름을 설정하는 파라미터
기본적으로 대문자로 인식되며 큰따옴표를 통해 대소문자 구분이 가능
(필수 입력)
SOURCE_TABLE_DEDUPLICATE
dedup 옵션이 사용된 테이블의 이관 동안 발생하는 deadlock 에러를 무시하는 파라미터
BATCH_THRESHOLD=2 이상일 경우 데이터 무결성이 보장되지 않으므로 BATCH_THRESHOLD=1인 경우에만 설정 - Y - N
TARGET_TYPE
Target DB의 타입을 설정하는 파라미터 – DEFAULT : Target DB가 Tibero일 때 설정
TARGET_DRIVER
Target DB에 접속할 때 사용하는 JDBC Driver 클래스를 설정하는 파라미터 (기본값 : com.m.internal.jdbc.MInternalDriver)
TARGET_URL
EXTRACT_PARALLEL
SOURCE DB에서 데이터를 추출하는 Thread의 parallel 동작 여부를 설정하는 파라미터 SOURCE_TYPE이 Oracle, default, postgresql인 경우에만 사용 가능
row가 rowid Hashing을 통해 나눠지므로 이관 동안 rowid 변경이 발생하지 않도록 주의 - Y - N (기본값)
EXTRACT_PARALLEL_RANGE_BY_ROWID
rowid의 범위를 지정하여 row를 나누도록 설정하는 파라미터
SOURCE_TYPE=Oracle, EXTRACT_PARALLEL=Y인 경우에만 설정 가능ora_hash function을 지원하지않는 Oracle 9버전 이하에서 성능적 이점 존재
IOT 테이블은 해당 옵션 사용불가 - Y - N
EXTRACT_THREAD_COUNT
INSERT_METHOD
데이터의 INSERT 방식을 지정하는 파라미터
– DPL(기본값) : DIRECT PATH LOADING – CPL : CONVENTIONAL PATH LOADING
COMMIT_SIZE
TARGET_DB에 데이터를 commit하는 사이즈를 지정하는 파라미터
INSERT_METHOD=cpl인 경우에만 동작하며 COMMIT_SIZE=-1로 설정하는 경우 기본값인 commit only once로 동작 (기본값 : commit once after loading)
INDEX_DISABLE
BYTEA_TO_BLOB
bytea 타입을 blob 타입으로 전환하도록 설정하는 파라미터 - Y - N(기본값)
TEXT_TO_CLOB
text 타입을 clob 타입으로 전화하도록 설정하는 파라미터 - Y - N(기본값)
MONITORING_LOG
모니터링 로그 출력 여부를 설정하는 파라미터
이관에 사용된 동작에 대한 평균 시간 로그를 출력 - Y - N (기본값)
MONITORING_LOG_UNIT
모니터링 로그에서 시간을 평균 낼 때 사용할 로우의 수를 설정하는 파라미터 (기본값 : 500)
MONITORING_SESS_STAT
크기를 2로 나누어 반올림한 값이다. NUMBER(7,2) = roundup(7/2) = 4
VARCHAR
지정된 길이의 70%로 가정한다. VARCHAR(3000) = 3,000 * 0,7 = 2,100
Row Header
3
bytes
row 하나당 bytes
250bytes 이하 컬럼개수
3
개수
위의 Row의 데이터 길이 테이블에 c1, c2, c3가 대상
250bytes 초과 컬럼개수
2
개수
위의 Row의 데이터 길이 테이블에 c4, c5가 대상
Block Size
8192
개수
기본값: 8192 (파라미터)
Block Header
48
bytes
고정 (Fixed Header)
INITRANS
2
개수
기본값: 2 (파라미터)
PCTFREE
10
%
기본값: 10% (파라미터)
ITL 공간
48
bytes
24 * 2 (24 * INITRANS)
초기 예상 건수
100,000
Rows
사용자 환경
월중 예상 추가 건수
20,000
Rows
사용자 환경
데이터 보관 월 수
120
개월
사용자 환경
Row Header
3
3
Row의 데이터 길이
2,622
2622
250bytes 이하 컬럼개수
3
1 * 3
1 * 250bytes 이하 컬럼개수
250bytes 초과 컬럼개수
2
3 * 2
3 * 250bytes 초과 컬럼개수
Row Space
2,636
2+3+2622+(1*3)+(3*2)
Block Header
48
48
ITL공간
48
48
24 * 2 (24 * INITRANS)
PCTFREE
10
10
Data Space per Block
7,286
(8192-48-48)*(100-10)/100
Row Space
2,636
2,636
Row Size per Block
2
7,286 / 2,636
월중 예상 추가 건수
20,000
20,000
데이터 보관 월 수
120
120+1
<데이터 보관 월 수> + 1
Total Row Size
2,520,000
100,000 +20,000 *(120+1)
Total Row Size
2,520,000
2,520,000
Row Size per Block
2
2
Total Table Size
10,321,920,000 (9.613037GB)
8,192 * 2,520,000 / 2
Target DB의 JDBC 연결 URL을 설정하는 파라미터 (기본값 : jdbc:internal:thin:@localhost:8629:tibero)
TARGET_USER
Target DB에 로그인하는 사용자 이름을 설정하는 파라미터
기본적으로 대문자로 인식되며 큰따옴표를 통해 대소문자 구분이 가능 (기본값 : sys)
TARGET_PASSWORD
Target DB에 로그인하는 사용자 패스워드를 설정하는 파라미터 (기본값 : tibero)
TARGET_SCHEMA
Target DB에 이관 받는 Table의 실제 사용자 이름
기본적으로 대문자로 인식되고 큰따옴표를 통해 대소문자 구분이 가능 (기본값 : TARGET_USER에서 설정한 사용자 이름)
TARGET_TABLE
Target DB에 이관 받는 Table 이름을 설정하는 파라미터
기본적으로 대문자로 인식되고 큰따옴표를 통해 대소문자 구분이 가능 (기본값 : SOURCE_TABLE에서 설정한 Table 이름)
데이터를 추출하는 Thread의 수를 설정하는 파라미터
EXTRACT_PARALLEL_RANGE_BY_ROWID 옵션을 사용하는 경우 테이블의 extent 수에 따라 적절한 값으로 설정 (기본값 : 1)
SELECT_TSN
특정 TSN (Oacle에서는 SCN) 시점 이후의 데이터를 추출하도록 설정하는 파라미터 (기본값 : 미사용)
SELECT_CONDITION
Table 데이터 전체가 아닌 조건절에 해당하는 데이터만 추출하도록 설정하는 파라미터 (기본값 : 미사용)
SELECT_FETCH_SIZE
Source DB에서 추출해온 결과 set을 fetch 해오는 단위 (row 수)를 설정하는 파라미터 (기본값 : 1024)
SELECT_PARTITION
파티션 Table에서 지정한 파티션에서만 데이터를 추출하도록 설정하는 파라미터 (기본값 : 미사용)
SELECT_SUBPARTITION
파티션 Table에서 지정한 서브 파티션에서만 데이터를 추출하도록 설정하는 파라미터 SELECT_PARTITION 옵션과 같이 사용할 경우 SELECT_PARTITION 옵션이 적용 (기본값 : 미사용)
SELECT_AS_BYTE
Table의 char, varchar와 같은 문자열을 저장하기 위한 열에 데이터베이스 설정과 다른 캐릭터셋을 사용하여 실제 문자열이 저장되면 문자열 형태로 데이터를 가져올 시 문자열의 정상적 배열 불가
이를 방지하기 위하여 문자열이 아닌 바이너리 형태로 데이터를 가져오고, 바이너리 형태로 Tibero에 옮기도록 설정하는 파라미터 - Y - N (기본값)
DB_FILE_MULTIBLOCK_READ_COUNT
이관 전 해당 세션에 대한 DB_FILE_MULTBLOCK_READ_COUNT 값을 설정하는 파라미터
SOURCE_TYPE=Oracle인 경우에만 설정 가능하며 값을 -1로 설정 시 동작하지 않음 (기본값 : -1)
OPTIMIZER_HINT
SOURCE DB로 부터 데이터를 SELECT 할 때 사용할 힌트를 설정하는 파라미터
테이블 이름은 't'를 사용하며 SOURCE_TYPE=Oracle, SOURCE_TYPE=Default인 경우에만 사용 가능 만약 USE_PARALLEL_HINT 옵션과 동시에 사용된다면, OPTIMIZER_HINT 옵션이 우선적으로 적용 - 예 : OPTIMIZER_HINT=/*+ FULL(t) PARALLEL(t, 4)
USE_PARALLEL_HINT
SOURCE DB에서 데이터를 SELECT 할 때 PARALLEL 힌트 사용 여부를 설정하는 파라미터 SOURCE_TYPE=Oracle, SOURCE_TYPE=Default인 경우에만 사용 가능 - Y - N (기본값)
USE_OBJECT_PARALLEL_HINT
PARALLEL 힌트 사용 시 Table 이름을 명시할 수 있도록 설정하는 파라미터
해당 옵션을 활성화하기 위해서는 USE_PARALLEL_HINT=Y 설정이 필요, SOURCE_DB가 Default, Oracle인 경우에만 사용 가능 - Y - N (기본값)
PARALLEL_HINT_CNT
PARALLEL 힌트 사용 시 DOP를 설정하는 파라미터
해당 옵션을 활성화하기 위해서는 USE_PARALLEL_HINT=Y 설정이 필요
(기본값 : -1)
TARGET_TABLE의 INDEX를 자동으로 DISABLE 하도록 설정하는 파라미터 - Y - N (기본값)
INSERT_BATCH
Table의 데이터를 Batch Insert 방식으로 load 하도록 설정하는 파라미터
INSERT_METHOD=CPL인 경우에만 동작 - Y - N
BATCH_THRESHOLD
TARGET_DB에 Batch를 실행할 때 단위(row 수)를 설정하는 파라미터
INSERT_METHOD=CPL, INSERT_BATCH=Y 인 경우에만 동작하며 -1 값을 입력하면 미 동작 (기본값 : 32)
DPL_LOG_UNIT
로그를 출력하는 row의 로딩 단위를 설정하는 파라미터
INSERT_METHOD=DPL인 경우에만 사용 가능하며 0으로 설정하는 경우 로그가 미 출력 (기본값 : 500)
INSERT_PARALLEL
데이터를 load하는 Thread의 parallel 동작 여부를 설정하는 파라미터 - Y(기본값) - N
INSERT_THREAD_COUNT
데이터 loader thread 개수를 설정하는 파라미터 INSERT_PARALLEL=Y인 경우에만 동작 (기본값 : 4)
INSERT_PARTITION
지정한 파티션에 이관할 경우 설정하는 파라미터 (기본값 : 미사용)
INSERT_ZERO_LENGTH_STRING_AS_NULL
길이가 0인 String 타입 데이터가 이관 시 NULL로 들어가도록 설정하는 파라미터 INSERT_ZERO_LENGTH_STRING_AS_NULL=N으로 설정 시 길이가 0인 데이터는 공백('')으로 들어가며 SOURCE_TYPE=Oracle인 경우 설정이 무시 - Y(기본값) - N
TRIM
CHAR 타입 데이터의 선행, 후행에 있는 pad 문자 제거 - Y - N(기본값)
모니터링할 stat을 설정하는 파라미터
여러개의 stat을 설정할 경우 ;로 구분해주며 해당 옵션은 SOURCE_TYPE=ORACLE인 경우에만 설정 가능 (기본값 : 미사용) - 예 : MONITORING_SESS_STAT=CPU used by this session;parse time cpu;parse count (hard)
CHECK_COLUMN_METADATA
INSERT_METHOD=dpl인 경우 이관하기 전에 SOURCE DB table과 TARGET DB table의 메타데이터를 확인하는 옵션 - Y(기본값) - N
ROW_QUEUE_TYPE
추출한 데이터를 저장하는 queue 타입을 설정하는 파라미터 EXTRACT_PARALLEL=Y, INSERT_PARALLEL=Y 인 경우 SYNCHRO 타입을 사용하는 것이 성능상 좋으며 ARRAY 타입은 사이즈 특정 가능 - ARRAY (기본값 : 10240) - SYNCHRO
VERIFY_TABLE
이관 검증 테이블 사용 여부를 설정하는 파라미터 - Y - N (기본값)
VERIFY_TABLE_NAME
검증 테이블 이름을 설정하는 파라미터 (기본값 : VERIFY_TBL)
LOG_LEVEL
로그 레벨을 설정하는 파라미터 (기본값 : INFO)
LOG_FILE_NAME
로그 파일 이름을 설정하는 파라미터 (기본값 : tableMigrator.log)
LOG_DIR
로그 파일이 생성되는 디렉토리 경로를 설정하는 파라미터 (기본값 : Migrator 실행 경로)
Tibero DB 인덱스 크기 산정 방법에 대해 설명합니다.
Tibero에서 인덱스 크기 산정에 필요한 사전 정보로 Key Column 총 길이, Base RowID 산정 기준 그리고 항목별 크기 산정 정보가 필요합니다.
아래는 Key Column 총 길이, Base RowID 산정 기준 그리고 항목별 크기 산정의 예입니다.
인덱스 크기를 산정하기 위해서는 컬럼의 데이터 타입별 실제 소비 크기와 저장되는 길이을 산정해야하며 이 정보는 인덱스 크기를 산정하기 위한 항목별 크기 산정방법에 사용됩니다. 인덱스 크기를 산정할 때 컬럼에 지정된 데이터 타입별 저장되는 크기 산정이 필요합니다.
아래는 컬럼 정의 및 계산 방식의 예입니다. 크기 산정 테이블은 5개의 컬럼으로 구성되었다고 가정합니다.
이름
""의 데이터 타입별 사이즈 표를 참고하여 위 테이블을 구성하는 각 컬럼의 데이터 타입별 실제 소비사이즈를 산정한 수치입니다. 자세한 항목별 수치 산정 방법은 ""를 참고합니다.
크기 선정 대상인 위 테이블의 인덱스는 Local Index와 Not Unique Index로 선별 되었습니다.
인덱스 크기를 산정하기 위해 필요한 항목은 아래와같습니다.
크기 예는 각 항목별로 기본으로 정해진 크기, 파라미터로 설정할 수 있는 크기와 운영할 시스템에서 사전 조사된 수 치를 나타냅니다.
본 절에서는 Tibero에서 인덱스 크기를 산정하는 방법을 설명합니다.
Leaf Block 일정수마다 Branch Block이 생성됩니다.
""의 산정방식 (Block Size * (A+B)) 중 A는 Leaf Block을 B는 Branch Block을 의미합니다.
Index Split이 일어난 경우 실제 블록의 50% 공간만 차지하게 되므로 사용 공간 최대 값은 최종 계산 결과 * 2를 해 줍니다.
인덱스의 경우 Create Index로 데이터를 처음 적재하는 경우 PCTFREE로 지정된 비율을 제외하고 블록을 최 대한 사용하여 데이터를 저장합니다.
인덱스 생성 이후 신규로 인덱스 키 데이터가 추가되는 경우 해당 인덱스 키가 추가되어야 하는 블록에 여유 공 간이 없을 때 SPLIT이 발생하게 됩니다.
SPLIT이 발생하게 되면 새로운 블록이 할당되고 기존 블록에 있던 인덱스 키 데이터를 통상 5:5 비율로 분할하 여 나누어 가지기 때문에 두 개의 블록에 빈 공간이 50% 생깁니다.
따라서, 인덱스에 데이터 추가가 계속된다고 하면 특정 시점 이후에 Index Split이 얼마나 발생했는지는 정확하게 예측하기는 어렵습니다. 다만, 처음 SPLIT이 발생된 이후, 다음 번 SPLIT이 발생되기까지 빈 공간이 0% ~ 50% 범위에서 유지되기 때문에 평균적으로 절반 정도의 블록이 SPLIT이 되어 있다라고 가정하는 것이 가장 근사하게 추정하는 방법일 것입니다.
Index Size시트의 크기 산정 방식에서 최종 계산 결과(Total Table Size for Index Spli)에 2를 곱한 것은 모 든 블록이 SPLIT되어 있을 때 최대 사용공간을 가정하여 산출한것이며 만약 평균 개념으로 추정한다면 1.5를 곱해서 계산하는 것이 현실적일 수 있습니다.
데이터타입
데이터길이
비고
c1
CHAR(10)
10
c2
DATE
8
c3
NUMBER(7,2)
4
roundup(7/2)
c4
CHAR(500)
500
c5
VARCHAR(3000)
2,100
3,000*0,7
Key Column 총 길이
18
c1 + c2
Name
Type
데이터길이
비고
A
Global Index
10
Global, Local 선별
항목
크기 예
단위
설명
Row Directory
2
bytes
기본값: 2
Row Directory + Index Header + Base RowID
+ Key Column 총 길이 + (1 * <250bytes 이하 컬럼개수>) + (3 * <250bytes 초과 컬럼개수>)항목
사전 정보 크기
실제 저장 크기
비고
Row Directory
2
2
(Block Size - Block Header - ITL 공간) * (100 - PCTFREE) / 100항목
사전 정보 크기
실제 저장 크기
비고
Block Size
8192
8192
/Data Space per Block / Index Entry Space (한 블록의 데이터 공간
/ 한 Index Entry의 저장에 필요한 공간)항목
사전 정보 크기
실제 저장 크기
비고
Data Space per Block
7,128
7,128
초기 예상 건수 + 월중 예상 추가 건수 * (데이터 보관 월 수 + 1)항목
사전 정보 크기
실제 저장 크기
비고
초기 예상 건수
100,000
100,000
1 / Entry Size per Block (1 / 한 블록에 들어가는 Entry 개수)항목
사전 정보 크기
실제 저장 크기
비고
Entry Size per Block
229.9355
229.9355
Block Size *( Total Row Size / Entry Size per Block + Total Row Size
/ Entry Size per Block ^ 2 )항목
사전 정보 크기
실제 저장 크기
비고
Block Size
8,192
8,192
Index Split이 일어난 경우 데이터 공간 = Total Index Size * 2 (필요한 총 데이터 공간 * 2 )항목
사전 정보 크기
실제 저장 크기
비고
Total Index Size
90,161,152
90,161,152
Unique Index
6
Global, Local 선별
B
Unique Index
0
Unique, Not Unique 선별
Not Unique Index
1
Unique, Not Unique 선별
Base RowID 총 길이
8
A + B의 합계
Index Header
2
bytes
기본값: 2
250bytes 이하 컬럼 개수
2
개수
위의 Key Column 총 길이 테이블에 c1, c2 가 대상이다.
250bytes 초과 컬럼 개수
0
개수
Block Size
8192
개수
기본값: 8192 (파라미터)
Block Header
224
bytes
INITRANS
2
개수
기본값: 2 (파라미터)
PCTFREE
10
%
기본값: 10% (파라미터)
ITL공간
48
bytes
24 * 2 (24 * INITRANS)
초기 예상 건수
100,000
Rows
사용자 환경
월중 예상 추가 건수
20,000
Rows
사용자 환경
데이터 보관 월 수
120
개월
사용자 환경
Base RowID
7
bytes
6 + 1
Index Header
2
2
Base RowID
7 7
6 +1
Key Column 총 길이
18
18
250bytes 이하 컬럼개수
2
1 * 2
1 * 250bytes 이하 컬럼개수
250bytes 초과 컬럼개수
0
3 * 0
3 * 250bytes 초과 컬럼개수
Index Entry Space
31
2+2+7+18+(1*2)+(3*0)
Block Header
224
224
ITL공간
48
48
24 * 2 (24 * INITRANS)
PCTFREE
10
10
Data Space per Block
7,128
(8192-224-48)*(100-10)/100
Index Entry Space
31
31
Entry Size per Block
229.9355
7,128 / 31
월중 예상 추가 건수
20,000
20,000
데이터 보관 월 수
120
120+1
<데이터 보관 월 수> + 1
Total Row Size
2,520,000
100,000 + 20,000 * (120+1)
Index Branch Ratio
0.004349046
1 / 229.9355
Total Row Size
2,520,000
2,520,000
Entry Size
per Block
229.9355
229.9355
Total Index Size
90,161,152
8192*(TRUNC(2520000/229.9355,0)
+TRUNC(2520000/229.9355^2,0))
Total Index Size for Index Split
180,322,304
90,161,152 *2
대용량 데이터 이관 방법의 예제를 설명합니다.
데이터 이관은 다양한 방법을 이용하여 수행할 수 있고 이로 인해 수행 속도를 최적화 시킬 수 있습니다.
아래는 예제에서 사용하는 테이블 정보입니다.
CREATE TABLE DBTECH.LINEITEM (
L_ORDERKEY NUMBER,
L_PARTKEY NUMBER,
L_SUPPKEY NUMBER,
L_LINENUMBER NUMBER,
L_QUANTITY NUMBER(15,2),
L_EXTENDEDPRICE NUMBER(15,2),
L_DISCOUNT NUMBER(15,2),
L_TAX NUMBER(15,2),
L_RETURNFLAG CHAR(1),
L_LINESTATUS CHAR(1),
L_SHIPDATE DATE,
L_COMMITDATE DATE,
L_RECEIPTDATE DATE,
L_SHIPINSTRUCT CHAR(25),
L_SHIPMODE CHAR(10),
L_COMMENT VARCHAR(44)
) NOLOGGING;Table Migrator 방법으로 대용량 데이터를 이관하는 순서입니다.
migrator.properties 파일에 속성값을 설정합니다.
$ cat migrator.properties
#######################
# Source DB Connection
#######################
# Source DB type (Optional, generic | default | ORACLE)
# ORACLE option needs SOURCE_LOGIN_AS property
# GENERIC option needs SOURCE_DRIVER property
SOURCE_TYPE=ORACLE
# Source DB JDBC driver class name
# Use with SOURCE_TYPE=GENERIC option
SOURCE_DRIVER=oracle.jdbc.OracleDriver
#SOURCE_DRIVER=com.mysql.jdbc.Driver
# Source DB JDBC connection URL (Optional,
Default=jdbc:oracle:thin:@localhost:1521:orcl)
SOURCE_URL=jdbc:oracle:thin:@localhost:1539:orcl
#SOURCE_URL=jdbc:mysql://127.0.0.1:3306/mysql
# Source DB login ID (Optional, Default=sys)
#SOURCE_USER="user1"
SOURCE_USER=tibero
# Source DB login password (Optional, Default=oracle)
SOURCE_PASSWORD=tmax
# Oracle source DB login option (Optional, Default=sysdba)
# Use with SOURCE_TYPE=ORACLE option
SOURCE_LOGIN_AS=NORMAL
# Source table schema (Optional)
# Default value is the same with SOURCE_USER
#SOURCE_SCHEMA=SCOTT
#SOURCE_SCHEMA="dbo"
#SOURCE_SCHEMA=
# Source table name (Mandatory)
#SOURCE_TABLE=tableName1
#SOURCE_TABLE="tableName2"
#SOURCE_TABLE=bt_scen_tran
SOURCE_TABLE=t1
# Ignore deadlock error that occur during migration for the tables created using the dedup option
# Use when BATCH_THRESHOLD=1
# If not, Data integrity is not guaranteed
SOURCE_TABLE_DEDUPLICATE=N
#######################
# Target DB Connection
#######################
# Target DB type (Optional, DEFAULT)
TARGET_TYPE=DEFAULT
# Target DB JDBC driver class name
#TARGET_DRIVER=com.tmax.tibero.jdbc.TbDriver
TARGET_DRIVER=com.m.internal.jdbc.MInternalDriver
# Target DB JDBC connection URL (Optional,
Default=jdbc:internal:thin:@localhost:8629:tibero)
#TARGET_URL=jdbc:tibero:thin:@192.1.5.63:39208:tibero
TARGET_URL=jdbc:internal:thin:@localhost:59166:tibero
# Target DB login ID (Optional, Default=sys)
#TARGET_USER="user1"
TARGET_USER=tibero
# Target DB login password (Optional, Default=tibero)
TARGET_PASSWORD=tmax
# Target table schema (Optional)
# Default value is the same with TARGET_USER
# TARGET_SCHEMA=TIBERO
# Target table name (Optional)
# Default value is the same with SOURCE_TABLE
# TARGET_TABLE=t1
#################
# Data Extractor
#################
# Use parallel Extracting (Optional, Y | N Default=N)
EXTRACT_PARALLEL=N
# Number of data extractor thread (Optional, Default=1)
EXTRACT_THREAD_COUNT=1
# Use TSN(or SCN) option (Optional)
#SELECT_TSN=17322052
# Where conditions (Optional)
# ex. column1 > 10 AND column2 = 'abc'
#SELECT_CONDITION= c1>1
# Fetch size of source table cursor (Optional, Default=1024)
# Some DB is not supported this feature.
#SELECT_FETCH_SIZE=1024
# Source table partition name (Optional)
#SELECT_PARTITION=
# Source table subpartition name (Optional)
#SELECT_SUBPARTITION=subpar1
#SELECT_SUBPARTITION="subpart2"
#SELECT_SUBPARTITION=
# Ignore source/target DB character set (Optional, y | N )
SELECT_AS_BYTE=N
# db_file_multiblock_read_count (Optinal, Option for Oracle), Defalut=-1)
DB_FILE_MULTIBLOCK_READ_COUNT=-1
# Use parallel excution of SQL statements (Optinal, Option for Oracle), Defalut=N)
USE_PARALLEL_HINT=N
# Use with USE_PARALLEL_HINT=Y (Defalut=-1)
PARALLEL_HINT_CNT=-1
##############
# Data Loader
##############
# Use direct path loading (Optional, cpl | DPL)
# CPL means conventional path loading
# DPL means direct path loading I
NSERT_METHOD=dpl
# Use commit size option(Optinal, Default = commit once after loading)
# Use with INSERT_METHOD=CPL option
# set commit_size-1 to commit only once
COMMIT_SIZE=-1
# Use index disable option(Optional, Default = N, Y/N)
INDEX_DISABLE=N
# Use batch insert (Optional, Y | n)
# Use with INSERT_METHOD=CPL option
INSERT_BATCH=Y
# batch threshold size (Optional, Default=32)
BATCH_THRESHOLD=128
# Use parallel loading (Optional, Y | n)
INSERT_PARALLEL=N
# Number of data loader thread (Optional, Default=4)
# Use with INSERT_PARALLEL=Y option
INSERT_THREAD_COUNT=1
# Target table partition name (Optional)
#INSERT_PARTITION=
# Specifies whether to keep the column names of the source table case-sensitive.
(Optional, Y | n )
# If set to Y, the original column name format will be preserved by enclosing it in
double quotes.
# If set to N, the column name format will follow the database naming rules.
INSERT_COLUMN_NAME_CASE_SENSITIVE=N
# Use zero length string data migration as null (Optional, Y | n, Default=Y, Option ignored for Oracle)
# If set to N, the zero length data will be inserted as ' '.
INSERT_ZERO_LENGTH_STRING_AS_NULL=Y
# Trim leading and trailing pad character of CHAR type data. (Optional, Y | n, Default=N)
#TRIM=
##############
# Common
##############
# Use MetaData Checking for DPL. (Optional, Default=Y)
CHECK_COLUMN_METADATA=N
# Log
LOG_LEVEL=INFO
LOG_FILE_NAME=tableMigrator.log
#LOG_DIR=Background Process를 이용하여 병렬 프로세싱으로 migrator를 수행합니다.
수행 결과와 로그 파일을 확인합니다.
DB Link로 insert ... select ... 구문을 수행할 때 parallel 힌트를 사용하면 select는 serial하게 동작하고, insert일 때만 parallel로 동작합니다. 따라서 DB Link 원본 데이터가 존재하는 서버의 사양이 좋을 경우 parallel 힌트를 사용하여 view를 생성하고 해당 view를 Tibero에서 select하는 방식으로 이관하면 성능 향상을 기대할 수 있습니다.
아래는 DB Link 방법으로 대용량 데이터를 이관하는 순서입니다.
전체 건수를 균등하게 나눌 수 있는 조건을 검토합니다.
만족하는 조건이 있는 경우 SQL문을 나눈 후에 병렬 세션(터미널 또는 다른 컴퓨터)으로 수행하며 Temp와 Undo Tablespace 사용량의 모니터링이 필요합니다.
SQL문에 append, parallel 힌트를 사용합니다.
append Insert하는 대상 테이블에 대해서 nologging 옵션이 적용되있어야 합니다.
parallel 힌트를 적용하기 위해 해당 세션에 parallel dml 옵션을 enable해야 합니다.
아래는 세션이 2개일 경우 DB Link를 수행하는 예입니다.
세션 1수행 L_LINESTATUS가 '0'에 대해서 Insert합니다.
세션 2수행 L_LINESTATUS가 'F'에 대해서 Insert합니다.
COMMIT된 데이터 확인
Load할 SAM 파일을 n등분하고 직접 로딩과 병렬 프로세싱을 동시에 사용합니다.
데이터를 로딩하는 방식으로 디스크에서 wait만 발생하지 않는다면 최적의 수행 속도가 보장됩니다.
아래는 tbLoader 방법으로 대용량 데이터를 이관하는 순서입니다.
Unload(spool 또는 unload 유틸을 이용하여 데이터 unload) 및 SAM 파일을 전송합니다.
Load할 SAM 파일을 n등분 하여 n개의 SAM 파일을 준비합니다.
각 SAM 파일을 읽는 n개의 컨트롤 파일을 작성하고, 작성할 때 append 옵션을 사용합니다.
아래는 2개의 컨트롤 파일을 작성하는 방법입니다.
Background Process를 이용하여 병렬 프로세싱으로 tbloader를 실행하고, tbloder 명령어에 'direct=y dpl_parallel=y' 옵션을 사용합니다.
아래는 2개의 SAM 파일 및 컨트롤 파일을 가지고 tbLoader를 수행하는 예입니다.
세션 1 수행
세션 2 수행
$ cat run.sh
# dbtech.lineitem 테이블 (조건 l_linestatus='0'에 해당하는 데이터)
nohup migrator.sh SOURCE_TYPE=ORACLE \
SOURCE_URL=jdbc:oracle:thin:@localhost:1521:ORCL \
SOURCE_USER=dbtech SOURCE_PASSWORD=dbtech SOURCE_LOGIN_AS=NORMAL \
SOURCE_SCHEMA=dbtech SOURCE_TABLE=lineitem \
TARGET_URL=jdbc:tibero:thin:@localhost:8629:tibero \
TARGET_USER=dbtech TARGET_PASSWORD=dbtech SELECT_CONDITION="l_linestatus='O'" >
migrator_a_set.log &
# dbtech.lineitem 테이블 (조건 l_linestatus='F'에 해당하는 데이터)
nohup migrator.sh SOURCE_TYPE=ORACLE \
SOURCE_URL=jdbc:oracle:thin:@localhost:1521:ORCL
\ SOURCE_USER=dbtech SOURCE_PASSWORD=dbtech SOURCE_LOGIN_AS=NORMAL \
SOURCE_SCHEMA=dbtech SOURCE_TABLE=lineitem \
TARGET_URL=jdbc:tibero:thin:@localhost:8629:tibero \
TARGET_USER=dbtech TARGET_PASSWORD=dbtech SELECT_CONDITION="l_linestatus='F'" >
migrator_b_set.log &# dbtech.lineitem 테이블의 조건 l_linestatus='0' migrator 수행 로그 확인
$ cat migrator_a_set.log
=== Parameters ===
PROPERTY_FILE=migrator.properties
SOURCE_TYPE=ORACLE
SOURCE_URL=jdbc:oracle:thin:@localhost:1521:ORCL
SOURCE_USER=dbtech
SOURCE_PASSWORD=************
SOURCE_LOGIN_AS=NORMAL
SOURCE_SCHEMA=dbtech
SOURCE_TABLE=lineitem
TARGET_TYPE=DEFAULT
TARGET_URL=jdbc:tibero:thin:@localhost:8629:tibero
TARGET_USER=dbtech
TARGET_PASSWORD=************
SELECT_CONDITION=l_linestatus='F'
SELECT_FETCH_SIZE=1024
SELECT_AS_BYTE=N
INSERT_METHOD=DPL
INSERT_BATCH=Y
INSERT_PARALLEL=Y
INSERT_THREAD_COUNT=4
==================
[E0]1373322363068 - STARTED
[L0]1373322363189 Loader started
[L1]1373322363192 Loader started
[L2]1373322363196 Loader started
[L3]1373322363198 Loader started
[L1] 1000
[L0] 1000
[L3] 1000
[L2] 1000
... 중략 ...
[E0]1373322793890 - TOTAL Extracted ROWS: 3004998
[L3]1373322793913 TOTAL Loaded ROWS: 617366
[L0]1373322793921 TOTAL Loaded ROWS: 893541
[L1]1373322793924 TOTAL Loaded ROWS: 898889
[L2]1373322793935 TOTAL Loaded ROWS: 595202
Loading is ended.
Elapsed Time : 431636
ADD BATCH : 0
EXECUTE BATCH : 0
[VERIFICATION] Source Info : dbtech.lineitem: 3004998 Rows, Target Info :
dbtech.lineitem : 3004998 Rows [OK]
# dbtech.lineitem 테이블의 조건 l_linestatus='F' migrator 수행 로그 확인
$ cat migrator_b_set.log
=== Parameters ===
PROPERTY_FILE=migrator.properties
SOURCE_TYPE=ORACLE
SOURCE_URL=jdbc:oracle:thin:@localhost:1521:ORCL
SOURCE_USER=dbtech
SOURCE_PASSWORD=************
SOURCE_LOGIN_AS=NORMAL
SOURCE_SCHEMA=dbtech
SOURCE_TABLE=lineitem
TARGET_TYPE=DEFAULT
TARGET_URL=jdbc:tibero:thin:@localhost:8629:tibero
TARGET_USER=dbtech
TARGET_PASSWORD=************
SELECT_CONDITION=l_linestatus='O'
SELECT_FETCH_SIZE=1024
SELECT_AS_BYTE=N
INSERT_METHOD=DPL
INSERT_BATCH=Y
INSERT_PARALLEL=Y
INSERT_THREAD_COUNT=4
==================
[E0]1373322363042 - STARTED
[L0]1373322363168 Loader started
[L1]1373322363172 Loader started
[L2]1373322363176 Loader started
[L3]1373322363215 Loader started
[L1] 1000
[L0] 1000
[L3] 1000
[L2] 1000
...(중략)
[E0]1373322795287 - TOTAL Extracted ROWS: 2996217
[L1]1373322795290 TOTAL Loaded ROWS: 767331
[L3]1373322795303 TOTAL Loaded ROWS: 759888
[L2]1373322795312 TOTAL Loaded ROWS: 739667
[L0]1373322795314 TOTAL Loaded ROWS: 729331
Loading is ended.
Elapsed Time : 432951
ADD BATCH : 0
EXECUTE BATCH : 0
[VERIFICATION] Source Info : dbtech.lineitem: 2996217 Rows, Target Info :
dbtech.lineitem : 2996217 Rows [OK]-- nologging 테이블 확인
select logging from user_tables where table_name = 'LINEITEM';
-- DB Link를 통해 ITAS 수행 (appned)
insert /*+ append */ into dbtech.lineitem b
select * from lineitem@olink where l_linestatus='O';-- dml 병렬 파라미터 활성화
alter session enable parallel dml;
-- DB Link를 통해 ITAS 수행 (parallel)
insert /*+ parallel(b 4) */ into dbtech.lineitem b
select * from lineitem@olink where l_linestatus='O';-- 세션1과 세션2에서 입력한 최종 데이터
SQL> select l_linestatus, count(*) from dbtech.lineitem@olink group by l_linestatus;
L_LINESTATUS COUNT(*)
------------ --------
F 2996217
O 3004998
2 rows selectedSQL> set timing on
SQL> alter session enable parallel dml;
Session altered.
Total elapsed time 00:00:00.005235
SQL> insert /*+ append parallel(b 4) */ into dbtech.lineitem b
select * from lineitem@olink where l_linestatus='O';
3004998 rows inserted.
Total elapsed time 00:07:07.806974
SQL> commit;
Commit completed.
Total elapsed time 00:00:00.000307SQL> set timing on
SQL> alter session enable parallel dml;
Session altered.
Total elapsed time 00:00:00.005235
SQL> insert /*+ append parallel(b 4) */ into dbtech.lineitem b
select * from lineitem@olink where l_linestatus='F';
2996217 rows inserted.
Total elapsed time 00:07:01.692934
SQL> commit;
Commit completed.
Total elapsed time 00:00:00.000307SQL> select count(*) from dbtech.lineitem;
COUNT(*)
-----------
6001215
1 row selected.# SAM 파일을 특정 기준으로 N개로 파일을 나눈다.
# 나눈 파일 마다 tbLoader Control 파일을 만들어준다.
# aa 컨트롤 파일
$ cat lineitem.ctl.aa
load data
infile 'lineitem.tbl.aa'
logfile 'lineitem.tbl.aa.log'
badfile 'lineitem.tbl.aa.bad'
append
into table lineitem
fields terminated by '|'
(L_ORDERKEY,
L_PARTKEY,
L_SUPPKEY,
L_LINENUMBER,
L_QUANTITY,
L_EXTENDEDPRICE,
L_DISCOUNT,
L_TAX,
L_RETURNFLAG,
L_LINESTATUS,
L_SHIPDATE,
L_COMMITDATE,
L_RECEIPTDATE,
L_SHIPINSTRUCT,
L_SHIPMODE,
L_COMMENT)
# ab 컨트롤 파일
$ cat lineitem.ctl.ab
load data
infile 'lineitem.tbl.ab'
logfile 'lineitem.tbl.ab.log'
badfile 'lineitem.tbl.ab.bad'
append
into table lineitem
fields terminated by '|'
(L_ORDERKEY,
L_PARTKEY,
L_SUPPKEY,
L_LINENUMBER,
L_QUANTITY,
L_EXTENDEDPRICE,
L_DISCOUNT,
L_TAX,
L_RETURNFLAG,
L_LINESTATUS,
L_SHIPDATE,
L_COMMITDATE,
L_RECEIPTDATE,
L_SHIPINSTRUCT,
L_SHIPMODE,
L_COMMENT)$ cat run.sh
# aa 파일 tbLoader 명령
nohup tbloader userid=dbtech/dbtech@tibero control=lineitem.ctl.aa
direct=y dpl_parallel=y &
# ab 파일 tbLoader 명령
nohup tbloader userid=dbtech/dbtech@tibero control=lineitem.ctl.ab
direct=y dpl_parallel=y &-- lineitem.tbl.aa.log:
tbLoader 7
TmaxTibero Corporation Copyright (c) 2020-. All rights reserved.
Data File : lineitem.tbl.aa
Bad File : lineitem.tbl.aa.bad Discard File : lineitem.tbl.aa.dsc
Table 'LINEITEM' was loaded from the data file.
COLUMN_NAME POSITION DATATYPE
--------------------- ----------- -----------------
L_ORDERKEY 1 CHARACTER
L_PARTKEY 2 CHARACTER
L_SUPPKEY 3 CHARACTER
L_LINENUMBER 4 CHARACTER
L_QUANTITY 5 CHARACTER
L_EXTENDEDPRICE 6 CHARACTER
L_DISCOUNT 7 CHARACTER
L_TAX 8 CHARACTER
L_RETURNFLAG 9 CHARACTER
L_LINESTATUS 10 CHARACTER
L_SHIPDATE 11 DATE
L_COMMITDATE 12 DATE
L_RECEIPTDATE 13 DATE
L_SHIPINSTRUCT 14 CHARACTER
L_SHIPMODE 15 CHARACTER
L_COMMENT 16 CHARACTER
Table LINEITEM :
------------------
0 Rows were skipped.
3000608 Rows were requested to load.
3000608 Rows were loaded successfully.
0 Rows were failed to load because of some errors
0 Rows were discarded.
0 Rows were failed to load because of some errors
Elapsed time was: 00:00:33.670898-- lineitem.tbl.ab.log:
tbLoader 7
TmaxTibero Corporation Copyright (c) 2020-. All rights reserved.
Data File : lineitem.tbl.ab
Bad File : lineitem.tbl.ab.bad
Discard File : lineitem.tbl.ab.dsc
Table 'LINEITEM' was loaded from the data file.
COLUMN_NAME POSITION DATATYPE
----------------------------- ----------- -----------
L_ORDERKEY 1 CHARACTER
L_PARTKEY 2 CHARACTER
L_SUPPKEY 3 CHARACTER
L_LINENUMBER 4 CHARACTER
L_QUANTITY 5 CHARACTER
L_EXTENDEDPRICE 6 CHARACTER
L_DISCOUNT 7 CHARACTER
L_TAX 8 CHARACTER
L_RETURNFLAG 9 CHARACTER
L_LINESTATUS 10 CHARACTER
L_SHIPDATE 11 DATE
L_COMMITDATE 12 DATE
L_RECEIPTDATE 13 DATE
L_SHIPINSTRUCT 14 CHARACTER
L_SHIPMODE 15 CHARACTER
L_COMMENT 16 CHARACTER
Table LINEITEM :
------------------
0 Rows were skipped.
3000607 Rows were requested to load.
3000607 Rows were loaded successfully.
0 Rows were failed to load because of some errors
0 Rows were discarded.
0 Rows were failed to load because of some errors
Total Elapsed Time: 00:00:33.795058