ProSync의 Flow Control을 위해 사용되는 기능들을 정리한 문서이다. 데이터가 동기화되는 일련의 과정이 안정적으로 운영되기 위해선 데이터 처리 속도가 관건이다.
처리가 너무 느리다면 동기화 로직 상 데이터는 계속해서 쌓이게 된다. 쌓인 데이터를 계속해서 메모리에 적재하면 당연히 문제가 발생하기 때문에 임계값을 통해 데이터를 파일로 저장하거나 일시적으로 지연시키는 동작이 수행된다.
또한 처리 속도를 올리기 위해서 사용되는 기능들도 존재한다. 처리 속도가 빠르면 그만큼 추출한 데이터가 실시간성이 높게 반영이 된다는 의미이므로, 이 부분을 고려하여 환경 설정을 하는 것이 좋다.
마지막으로 에러가 발생했을 때, 정합성을 위해 기본적으로 동기화가 멈추게 되어있는데, 이렇게 되면 데이터가 더이상 처리될 수 없어서 영구적인 지연이 발생할 수 있다. 따라서 에러가 발생했을 때, 이를 자동으로 생략하거나 Rule에 맞춰서 데이터를 처리하는 방법에 대해서도 알아본다.
ProSync의 데이터 흐름도를 상세히 이해하고, 이를 통해 Memory 사용량 조절방식을 안내한다.
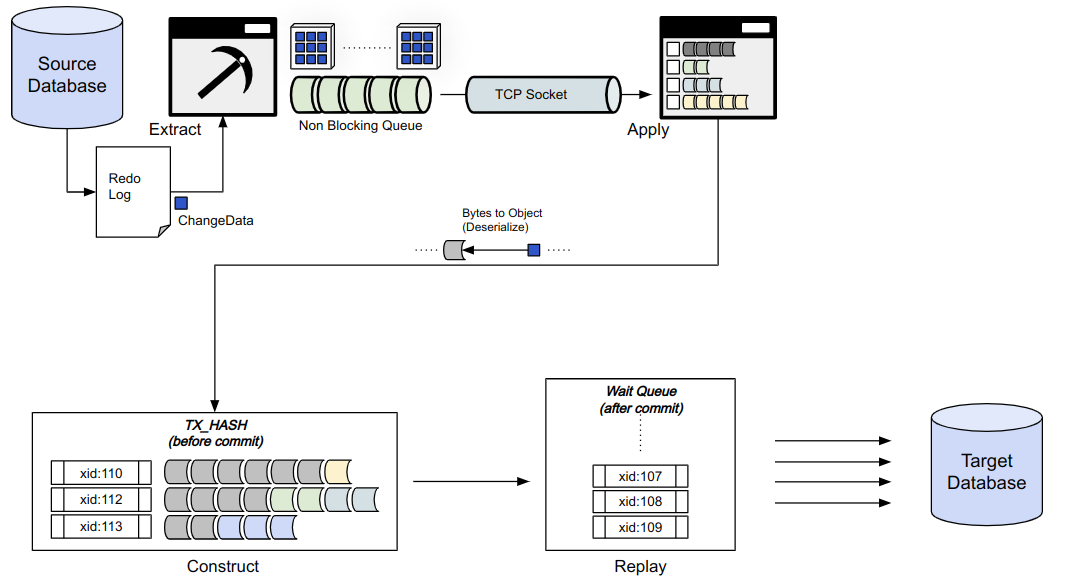
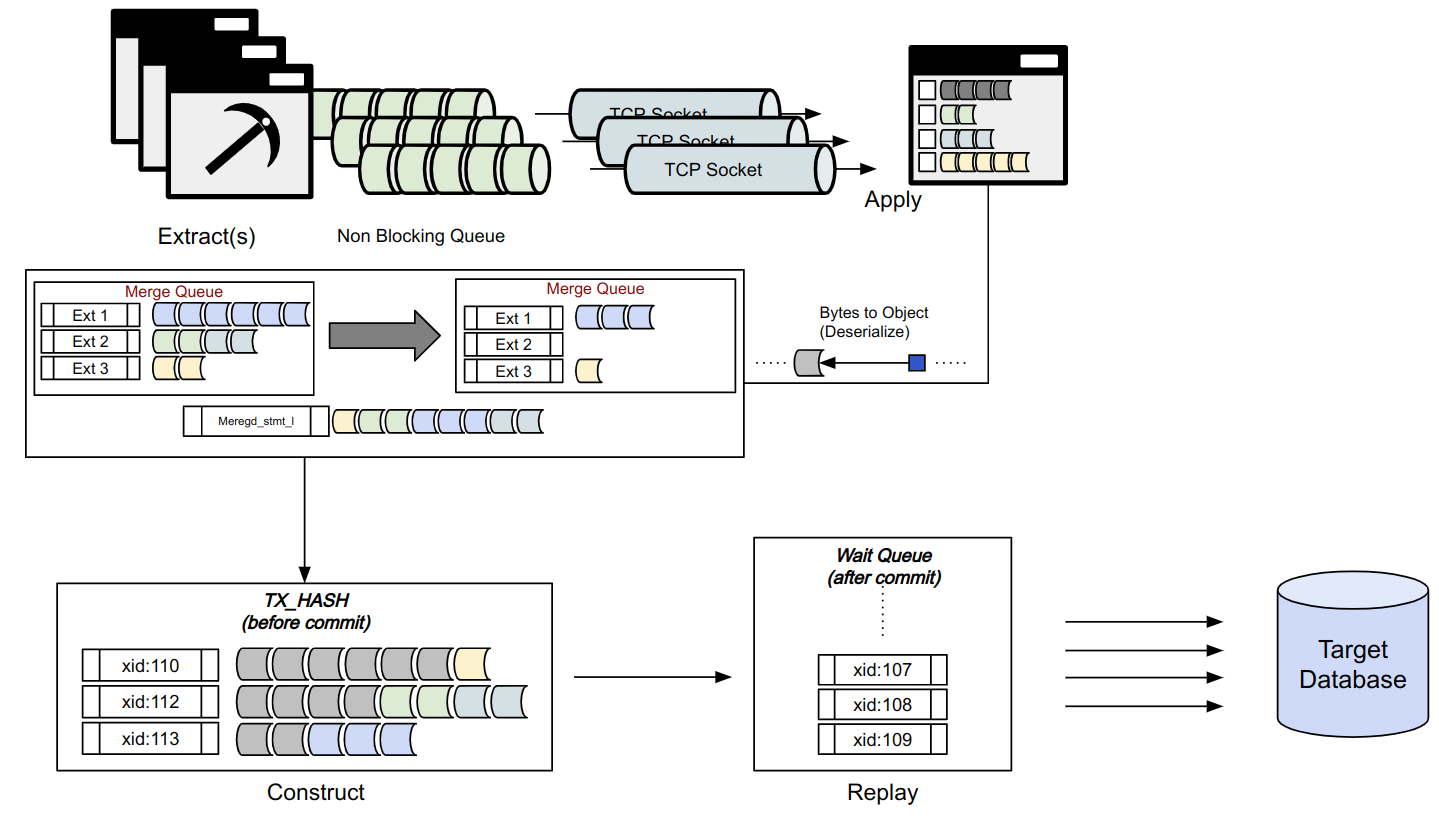
데이터가 처음 생성되는 위치는 Source DB의 Redo Log이다. Redo Log에서 발생된 데이터를 Extract 가 추출하여 Chunk 단위로 데이터를 적재한다.
적재된 데이터는 TCP Socket을 통해 전송이 된다. Non Blocking 통신이기 때문에 전체 데이터에 대한 전송이 실패하면, 이후의 데이터들은 Non Blocking Queue에 쌓이게 된다. 이 Queue에 쌓인 데이터는 커널로부터 반대쪽 TCP Recv Buffer가 비어있다는 신호가 올 때, 순서대로 다시 데이터를 보내게 된다.
Apply는 받은 데이터를 모두 객체화 (역직렬화) 하여 TX_HASH에 쌓이게 된다. xid 는 트랜잭션 고유의 id 를 의미하며, ACID를 지켜주기 위해 트랜잭션의 커밋까진 이 위치에서 데이터를 계속 보관한다. 트랜잭션의 커밋이 들어오면 해당 트랜잭션은 Target Database에 반영이 가능한 상태로 판단하고 Replay Queue로 데이터를 넘겨준다.
Wait Queue에 쌓인 데이터는 트랜잭션들이 커밋된 순서에 맞게 Target Database로 반영이 된다. 이 때 반영 중인 트랜잭션과 반영 대기 중인 트랜잭션이 있을 텐데, 이들간의 의존성 검사를 통하여 시간 순서에 맞고, 의존성이 없는 트랜잭션들은 병렬 처리하여 성능을 높인다.
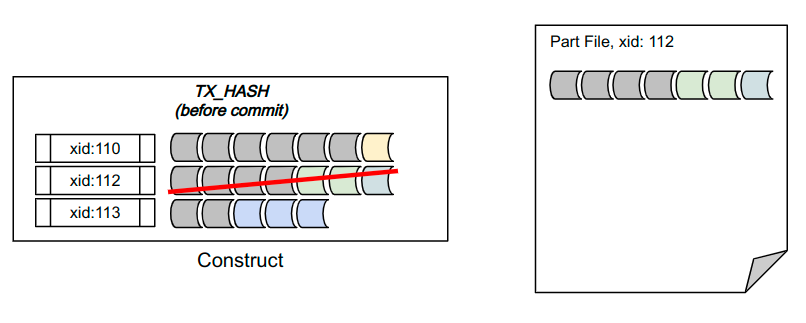
TX_HASH 에 데이터가 계속 쌓인다면 Out of Memory 를 피할 수가 없다. 따라서 특정 임계치를 넘어갈 경우 Part File이라는 이름으로 된 파일을 생성하여 이 위치로 데이터를 옮겨준다.
데이터를 옮기는 기준은 현재 TX_HASH에 있는 데이터들 중 가장 용량이 큰 트랜잭션 기준으로 파일로 내려가게 되며, 내려간 파일은 실제 반영이 되는 시점까진 계속 Disk에 남게 된다
이에 대한 기준이 되는 파라미터가 TX_HASH_SIZE 파라미터이다. TX_HASH_SIZE라는 임계치보다 더 많이 데이터가 쌓이게 될 경우 아래와 같은 동작이 수행된다고 생각하면 된다.
Part File은 반영이 완료되면 제거가 되며, 반영이 되기 전까진 Disk에 남는다. 실제 트랜잭션 반영 시점에도 Part File로 내려간 DML 데이터들이 시간 상 더 앞서기 때문에, 파일에 있는 데이터를 먼저 반영한 후 메모리에 남은 트랜잭션 데이터를 반영한다.
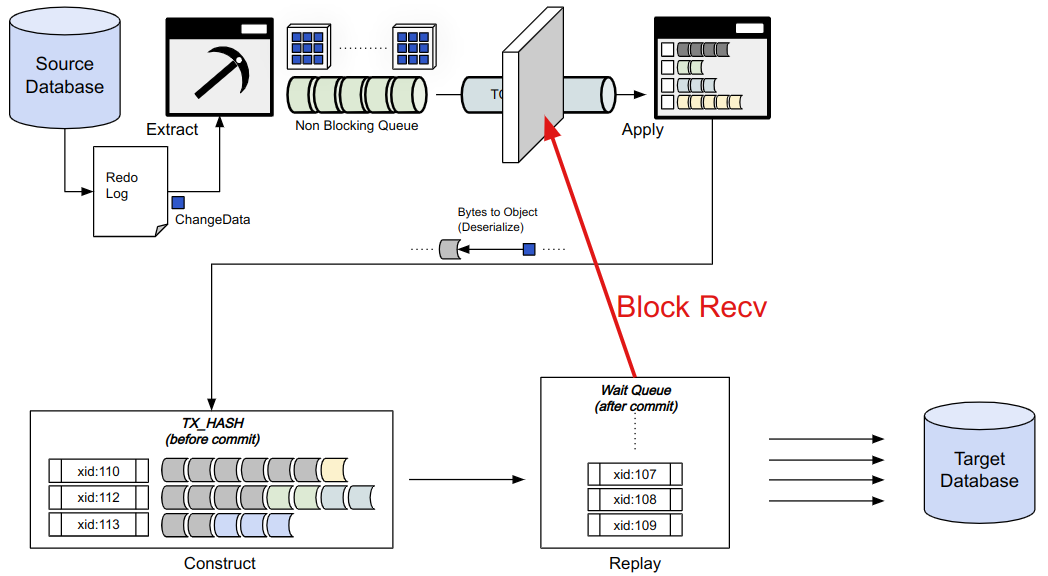
ProSync는 ACID를 지켜주기 위해 데이터를 순서에 맞게 반영해야 한다. 즉, 앞선 트랜잭션이 반영되지 않는 경우 데이터는 반영될 수 없다는 의미이다. 따라서 Target Database에 장애가 발생하여 트랜잭션 처리가 지연된다면 그만큼 Queue에는 데이터가 쌓이게 된다.
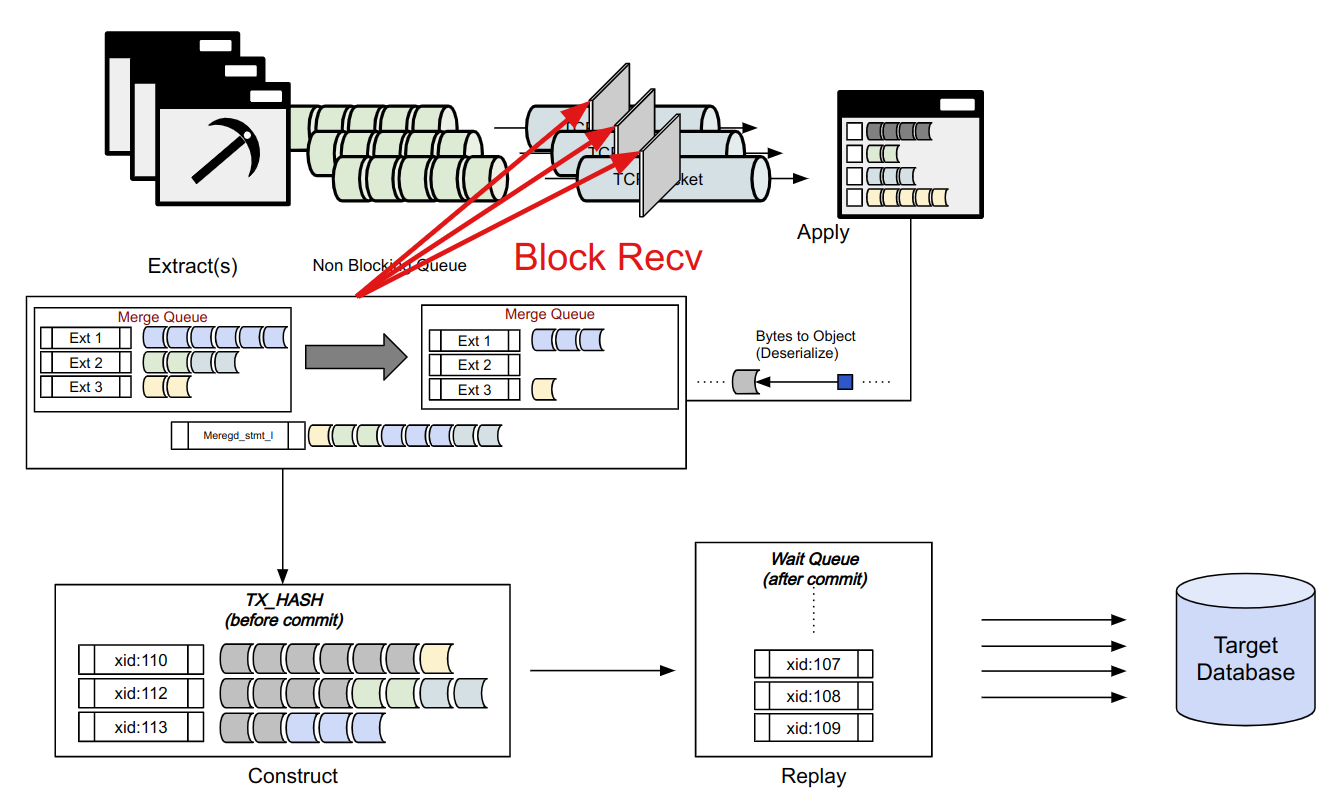
Queue에 영구적으로 데이터가 쌓이는 것을 방지하기 위해 ProSync는 Queue 내에서 대기 혹은 반영 중인 트랜잭션들의 크기를 모두 확인한다. 이 크기가 너무 크다면 Memory 할당을 멈춰야 한다.
Memory 할당을 멈추기 위해 ProSync는 데이터가 추가적으로 생산되는 것을 막는다. 즉, Extract로부터 수신되는 데이터를 일시적으로 차단함으로써, 현재 보유 중인 데이터가 일정 수준 이상 처리될 때까지 대기 상태를 유지하도록 강제하는 방식이라고 볼 수 있다.
Extract는 앞에서 설명한 내용대로 Non Blocking Queue에 데이터를 쌓다가 실제 추출을 멈춤으로써 추가적인 데이터 생산을 멈추게 된다.
임계치에 해당하는 파라미터는 아래와 같다.
MEMORY_CTRL_STOP_SIZE Wait Queue에 이 크기 이상 만큼의 데이터가 쌓이면 Socket 으로 부터 추가적으로 들어오는 데이터를 막는다.
MEMORY_CTRL_RESUME_SIZE Wait Queue에 이 크기 이하만큼 데이터가 줄어들면, Socket 으로 부터 데이터를 다시 받는다.
그림으로 나타내면 아래와 같다.
Active-Active Cluster인 RDBMS들은 Physical Disk를 공유하고 있다. 따라서 같은 공간에 서로 순서에 적합하게 데이터를 입력한다. Redo Log는 서로 다른 곳에 작성하더라도 Change Data들의 시간은 순서에 맞게 끔 작성이 된다. ProSync 입장에서 보면 서로 다른 위치에 남은 Redo Log들을 모아 직렬화를 하면 결국 DB Time 순서대로 데이터 정렬이 가능하다는 의미이다.
따라서 ProSync의 Apply 입장에선 추출이 Cluster인지 아닌지는 관심사가 아니다. 어차피 DB Time 기준으로 정렬이 가능한 데이터라면 단순히 한 줄로 세워 놓고 하나씩 쿼리로 변경해주면 된다. 다만 문제는 장애 상황이나 지연 상황에서 발생한다.
만약에 한쪽 노드에서 아무런 부하가 없거나 장애로 멈춰버리게 되면 Redo Log 작성이 멈추게 된다. 읽을 것이 없는 Extract 프로세스는 아무런 데이터를 보낼 수가 없다. 이렇게 되면 Apply 프로세스 입장에선 현재 Cluster 중 하나가 장애가 나서 못 보내고 있는 것인지, 부하가 없어서 데이터를 못 보내는 것인지 확인할 방법이 없다.
따라서 Extract 에서는 장애가 발생했다는 메시지를 TCP Socket으로 전달해주고, 부하가 없는 상황을 대비하여 ProSync용 Dummy Table에 강제로 부하를 만들어 데이터를 생산해서 전달해준다.
이 과정을 통해 Apply 프로세스는 서로 다른 Cluster Node의 데이터들을 항상 정렬할 수 있다. 하지만 정렬을 하기 위해선 정렬을 위한 공간이 필요하며, 이 위치는 아래 그림과 같다.
위와 같이 Extract가 여러 개인 상황 (Active Cluster) 에선 각 Extract 별로 데이터를 먼저 Merge Queue에 쌓아 놓는다. 쌓인 데이터가 직렬화가 되려면 모든 Extract 별 데이터가 1개라도 있어야 하기 때문에 이때까진 Merge Queue에 데이터가 쌓이게 된다.
다만 네트워크 장애나 모종의 이유로 한쪽에서 데이터가 들어오는 행위가 매우 지연될 수 있기 때문에, 마찬가지로 여기서도 추가적인 데이터가 들어오지 못하게 TCP Socket으로 부터 데이터를 막는 동작이 사용된다.
여기에 사용되는 파라미터는 아래와 같다.
MERGE_BLOCK_CNT 특정 노드로부터 데이터가 이 갯수 이상만큼 쌓이면 해당 TCP Socket을 막는다.
MERGE_RESUME_CNT 특정 노드로부터 데이터가 이 갯수 보다 작다면 해당 TCP Socket을 다시 열어준다.
그림으로 보면 아래와 같다.
Extract 별로 연결이 따로 존재하므로 이와 같이 별도로 관리하게 된다.
TX_HASH_SIZE 파라미터보다 큰 경우주의
Wait Queue 관련
Replay 쪽에선 많은 자료구조를 사용한다. 반드시 Wait Queue만 사용하는 것은 아니며, 여러 종류의 Queue나 Tree 등이 사용되는데, 여기선 설명을 위해 모두 Wait Queue로 추상화하여 설명한다.
데이터 충돌 발생 시, 처리방안에 대해 확인한다.
ProSync는 Apply 프로세스 지연 시 모든 곳에 지연이 발생하게 된다. 이 때문에 성능을 올릴 수 있는 수단들이 존재한다. 본 장에서는 Performance 측면에서 설정할 수 있는 Configuration들에 대해 알아본다.
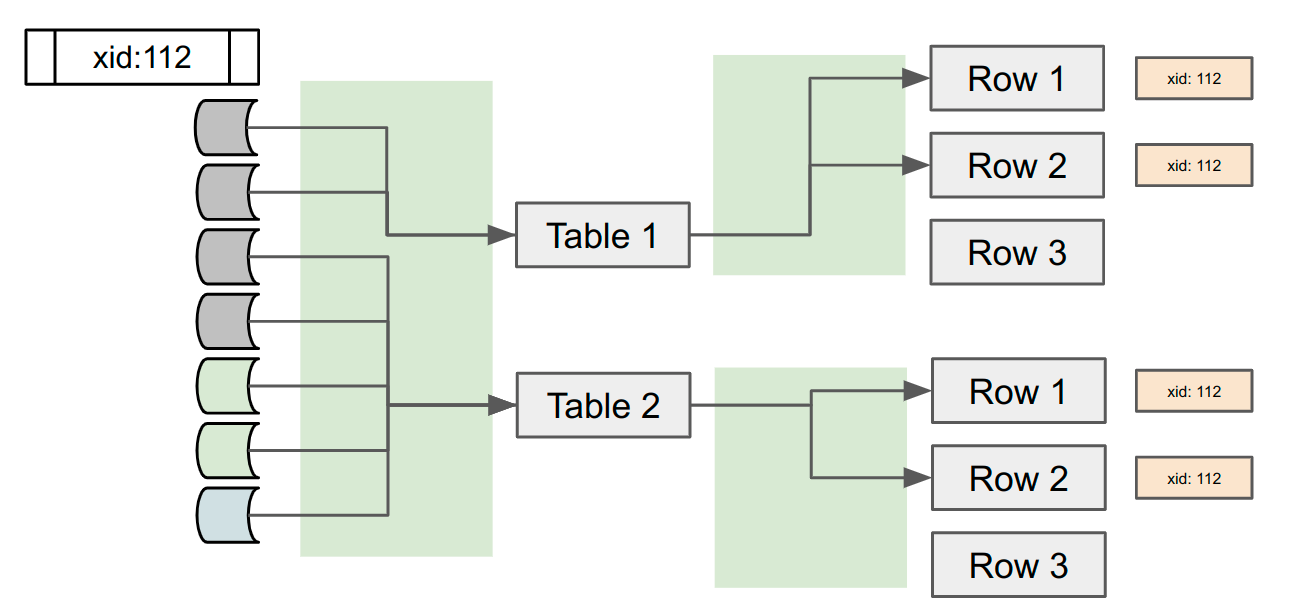
커밋이 요청된 트랜잭션은 반영을 할 수 있으면 반영을 하고, 반영을 할 수 없으면 큐에서 대기하게 된다. 반영 가능 여부는 반영하고자 하는 트랜잭션과 반영 중인 트랜잭션 간의 의존성 체크를 통해 서로 독립적일 경우 반영이 가능하다고 판단한다.
의존성 체크는 Table과 Row 단위 모두 확인을 한다. 트랜잭션은 레코드로 이루어져 있고, 레코드에는 레코드가 접근하는 Row가 정해져 있기 때문에, 해당 데이터를 기반으로 다른 트랜잭션과 의존 관계인지 여부를 판단한다.
의존성 확인 동작은 RedBlack Tree(RBT)와 Linked List로 관리가 되고 있다. Table 단위로 RBT를 확인하고, Table이 확인되면, 해당 Table 노드 내의 RBT에서 Row를 확인한다. 이 위치엔 Linked List가 존재하며, 트랜잭션은 해당 List에 의존성 객체(TX Dependency)를 달아 놓는다.
이 동작을 통해 트랜잭션이 접근하는 모든 Row에 대한 Linked List에 TX Dependency가 등록이 된다. 반영 중인 트랜잭션이나 반영 대기 중인 트랜잭션 모두 이 구조 안에서 관리된다.
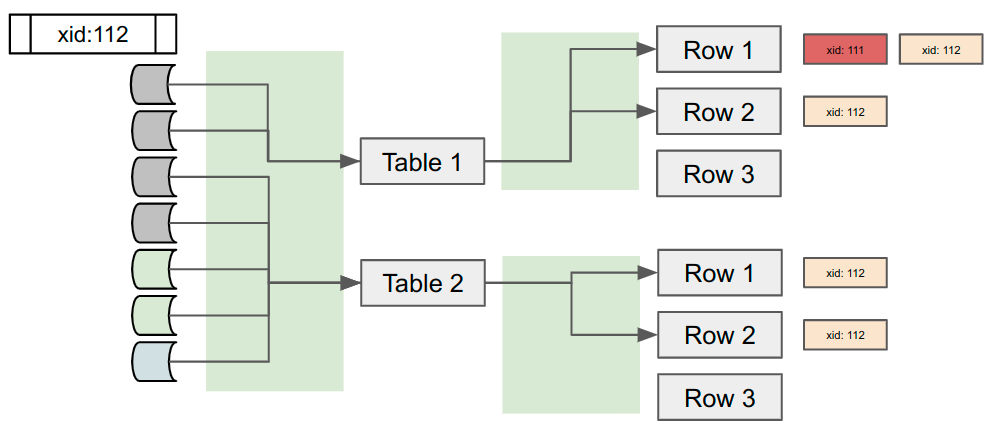
반영 가능 여부는 트랜잭션의 모든 TX Dependency가 Linked List의 front에 존재하는 지의 여부로 확인한다. 하나라도 front에 존재하지 않는다면 반영이 불가능하고, 앞서 반영 중인 트랜잭션의 완료를 대기하게 된다.
반영이 가능한 경우는 위 그림과 같이 모든 의존성 체크를 했을 때 Linked List 상에 TX Dependency 가 가장 앞선 경우이다.
만약 위 그림과 같이 xid: 111인 트랜잭션이 아직 반영이 끝나지 않았다면 대기하게 된다. 반영이 완료된 트랜잭션은 위 Linked list에서 제거가 되고, xid: 112가 반영 가능하게 되면 반영 작업을 진행한다.
관련 파라미터는 REPLAY_THREAD_CNT 로, 해당 값이 올라가면 병렬 세션의 수가 많아진다. 하지만 위 로직에서 알 수 있듯이 결국 RBT 내에서 Table, Row단위로 TX Dependency가 잘 풀려야 병렬 반영이 가능하다. 이로 인해 숫자를 올린다고 반드시 올린 숫자만큼 정비례하게 증가하지 못하는 경우도 발생한다.
Redo Log는 물리적인 위치에 대한 변경분이 남는다. RDBMS (주로 Oracle, Tibero) 에서는 row 데이터가 ROWID 라는 고유의 값을 가지게 되는데, 이 ID에는 데이터 파일의 위치, 파일 내 데이터 블록의 위치, 블록 내 row의 위치 에 대한 정보가 저장되어있다.
ProSync는 이 물리적으로 정해진 ROWID만 가지고는 Target Database에서 정확하게 어떤 row인지 판별할 수가 없다. 왜냐하면 데이터 파일도 다를 것이고, 블록 위치나 row 위치 정보도 모두 다르기 때문에 ROWID로는 서로 다른 Database의 row를 매칭 시키기가 어렵다.
따라서 SUPPLEMENTAL_LOGGING옵션 등을 통해 row 데이터의 추가적인 정보를 Redo Log상에 함께 남기게 된다. 예를 들면, 사용자가 Where Clause에 1개의 Column정보만 넣었다고 하더라도, Redo Log에는 해당 Row 내에 있는 모든 Column 정보가 다 남도록 해준다.
Target Database와 Apply 프로세스는 이 정보를 가지고 쿼리를 재구축한다. 다만 이렇게 되면, Primary key 를 가지고 있는 테이블 입장에선 불필요한 다른 컬럼 정보들을 Where Clause에 입력해주는 경우가 생긴다. Database의 플랜 별로 최적화되어 잘 처리될 수도 있지만, 불필요한 상황 자체를 방어하기 위해 ProSync에선 Primary key만 사용할지에 대한 여부를 파라미터로 관리한다.
USE_PK_FOR_WHERE
이 파라미터를 사용하면 Primary key가 있는 테이블에 대한 Update나 Delete 시에 Where Clause에는 Primary key만 입력하게된다.
MAP Rule에서 소개한 Data Conflict Rule의 시나리오들을 정리한다. 옵션을 설정하는 방법은 해당 문서를 참고한다.
Data Conflict를 확인하려면 Row를 특정할 수 있어야 한다. ProSync에서는 이에 대한 기준을 Primary key로 두고 있다. Primary key 로 인해 충돌이 발생할 경우, Source Database, Target Database, Column Min(Max) 기준으로 데이터 Conflict에 대한 처리를 결정한다.
Insert문에서 충돌이 발생한다는 것은, 이미 데이터가 존재한다는 의미이다. 따라서 존재하는 데이터를 모두 Source Database 기준으로 맞춰주어야 한다.
Insert문을 Update로 변경하여 Conflict를 해소해준다.
Update에서의 데이터 충돌은 원하는 Row가 없다는 의미이다.
Update문을 Insert로 변경하여 Conflict를 해소해준다.
Delete에서의 데이터 충돌 또한 마찬가지로 Row가 없다는 의미가 된다.
Delete에 대한 추가적인 처리가 없이 넘어가면 된다.
Insert문의 충돌은 이미 데이터가 있을 때 발생하는데, Target Database 기준으로 맞춰야 하므로, 별도의 작업 없이 해당 처리를 건너뛴다.
Row가 없는 상황이 맞다고 판단하기 때문에 별도의 작업 없이 해당 처리를 건너뛴다.
Row가 없는 상황이 맞다고 판단하기 때문에 별도의 작업 없이 해당 처리를 건너뛴다.
주의
Data Conflict Rule(DCR) 관련
Data Conflict Rule (DCR) 옵션을 사용할 경우 USE_PK_FOR_WHERE 옵션은 무시된다. 동기화의 논리 구조상 Conflict를 찾는 것이 우선이기 때문에 ProSync에선 두 옵션 간에 이와 같은 우선순위를 둔다.
주의
Data Conflict Rule(DCR) 관련
Data Conflict Rule(DCR) 옵션을 사용할 경우 USE_PK_FOR_WHERE 옵션은 무시된다. 동기화의 논리 구조상 Conflict를 찾는 것이 우선이기 때문에 ProSync에선 두 옵션 간에 이와 같은 우선순위를 둔다.
Batch Execution은 RDBMS 상에서 우리가 사용하는 Batch 관련 API라고 이해하는 것이 용이하다. DML 각각을 모두 쿼리 형태로 변환하여 전달하기보단, 같은 형태의 쿼리라면 데이터를 Batch단위로 모아서 서버에서 사용하도록 하는 기능이다.
이 기능을 사용하면 Insert 와 같은 DML이 연속해서 들어올 때, Target Database 의 성능을 향상 시킬 수 있다. 이를 통해 데이터 처리 속도를 증가 시키고 동기화 속도를 끌어 올려줄 수 있다.
하지만 제약사항도 존재하는 기능으로, 아래와 같은 두가지 관점에서 고려할 수 있다.
같은 형태의 쿼리
Batch로 모았을 때의 한계
ProSync는 한 트랜잭션에서 DML이 연속해서 들어올 때 이 순서를 임의대로 바꾸지 않는다. 입력되는 모든 쿼리를 순서대로 적용해야 정합성이 깨지지 않는다는 대전제 때문에 이와 같이 처리가 된다.
문제는 이렇게 되면 Insert * 3, Update*3, Delete* 3의 순서로 데이터가 들어올 때와 (Insert, Update, Delete) * 3의 순서로 데이터가 들어올 때 Batch Execution 입장에서 큰 차이가 발생한다.
유사한 쿼리가 연속해서 들어온다면 ProSync는 이를 Batch로 묶어서 처리를 할 수가 있지만, 쿼리들의 형태가 연속적이지 않게 들어온다면 Batch로 처리할 수가 없다. 따라서 두 트랜잭션의 결과가 동일하더라도 하나는 Batch 처리가 가능하고 다른 하나는 Batch 처리가 불가능하다.
트랜잭션 내에 같은 형태의 쿼리들이 연속해서 들어온다고 가정을 하여도 성능 향상이 미미한 경우도 존재한다. 예를 들어 Insert의 경우 Batch 동작을 통해 데이터의 개수나 크기 등을 Target Database에 미리 알려준다면 Database는 이에 맞는 플랜을 세워서 최적화 하여 처리가 가능하다. 하지만 Delete나 Update 처럼 각 row 별로 Where Clause에 의해 따로 탐색을 해야 하는 형태로 들어온다면 아무리 모아 보내도 서버 입장에선 하나씩 처리하나, 모아서 들어온걸 하나씩 처리하나 큰 차이가 없다고 볼 수 있다.
따라서 ProSync는 특별한 설정이 없다면 Insert에 대한 Batch만 처리하는 것이 기본 동작이다. 하지만 Database 별로 처리하는 방식이 달라질 수 있기 때문에 Batch 사용 여부는 파라미터로 모두 관리가 된다.
Parameter 별 제공하는 기능이다.
USE_BATCH_MODE
기본 값은 Y 로, Batch는 항상 동작하도록 되어있다.
BATCH_MEM_SIZE
기본 값은 10MB로 서버에 보낼 때 최대 10MB의 데이터까지만 쌓고 쿼리에 대한 처리를 요청한다.
USE_ONLY_INSERT_BATCH
Insert 만 Batch 로 처리할 것 인지에 대한 파라미터로 기본 값은 Y 이다.
ProSync가 동기화 과정 속에 DML을 Target DB에 반영 중 에러가 발생할 수 있다. 일반적인 경우에는 ProSync가 해당 DML에 대한 반영을 성공할 때 까지 재시도하게 된다.
해당 기능을 사용하면 특정한 에러에 대해 재시도하는 대신 해당 DML에 대한 반영을 생략하고 이후의 동기화를 진행하도록 설정할 수 있다.
또한 DISCARD 기능이 발생한 이력을 기록하는 Discard file 을 작성할 수 있다.
해당 기능을 사용하기 위해선 config 파일에 다음과 같은 Parameter를 설정해야 한다.
DISCARD_YN=[Y|N]
DISCARD_EC=2 10007 8033
DISCARD_FILE_YN=[Y|N]

DISCARD_FILE_DIR=/directory/to/save/file
DISCARD_FILE_SIZE=200M
DISCARD_BACKUP_DIR=/directory/to/save/backup/file
DISCARD_BACKUP_SIZE=10GDISCARD_YN
ProSync가 Source DB의 값을 Target DB의 데이터 타입으로 변환하지 못하면(지원하지 않는 timestamp 지역 정보 등) 해당 DML은 반영에 실패하고, 일반적인 경우에는 성공할 때까지 재시도하게 된다.
DISCARD_CAST_ERR=Y로 설정하면 변환에 실패한 DML을 재시도하지 않고 건너뛴 뒤 이후의 동기화를 진행한다. 건너뛴 DML은 Target DB에 반영되지 않는다.
DDL도 DML과 마찬가지로 Target DB에 반영 중 에러가 발생할 수 있다. 일반적인 경우에는 ProSync가 해당 DDL에 대한 반영을 성공할 때 까지 재시도하게 된다.
해당 기능을 사용하면 재시도하는 대신 해당 DDL에 대한 반영을 생략하고 이후의 동기화를 진행하도록 설정할 수 있다.
또한 DISCARD 기능이 발생한 이력을 기록하는 Discard file 을 작성할 수 있다.
해당 기능을 사용하기 위해선 config 파일에 다음과 같은 Parameter를 설정해야 한다.
DISCARD_DDL_FILE_SIZE
discard 파일의 최대 크기를 지정하는 파라미터.
유형: int32
범위: 1M - 1G
기본값: 100M
DISCARD_DDL_BACKUP_DIR
discard 파일의 크기가 설정한 최대 크기를 초과하게 되면 생성하는 백업파일의 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: $PRS_HOME/var/<인스턴스명>/ddl_err/backup
DISCARD_DDL_BACKUP_SIZE
backup 디렉토리의 최대 크기를 지정하는 파라미터.
유형: uint64
범위: 0 - 128G
기본값: 0
동기화 중 에러가 발생하는 경우에 스킵할지 여부를 설정한다. Y 상태에선 발생한 에러가 DISCARD_EC 에 작성된 에러코드에 속해있는 경우 재시도를 생략한다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_EC
재시도를 하지 않고 건너뛰고자 하는 에러코드를 입력한다.
유형: 에러코드
범위: 최대 256개
기본값:
DISCARD_FILE_YN
DISCARD 동작이 발생했을 때 해당 내용을 discard 파일에 남기는 기능을 활성화 하는 파라미터이다.
유형: Y/N, dynamic
범위: Y/N
기본값: N
DISCARD_FILE_DIR
discard file의 저장 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: (LOG_DIR과 같은 디렉토리)
DISCARD_FILE_SIZE
discard 파일의 최대 크기를 지정하는 파라미터.
유형: int32, dynamic
범위: 1M - 1G
기본값: 100M
DISCARD_BACKUP_DIR
discard 파일의 크기가 설정한 최대 크기를 초과하게 되면 생성하는 백업파일의 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: (LOG_BACKUP_DIR과 같은 디렉토리)
DISCARD_BACKUP_SIZE
backup 디렉토리의 최대 크기를 지정하는 파라미터.
유형: uint64, dynamic
범위: 0 - 128G
기본값: 0(무제한)
DISCARD_CAST_ERR
데이터 변환에 실패한 DML을 재시도하지 않고 건너뛸지 여부를 설정한다. DISCARD_YN, DISCARD_EC 설정과 무관하게 동작한다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_DDL_YN
동기화 중 에러가 발생하는 경우에 스킵할지 여부를 설정한다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_DDL_FILE_YN
DISCARD 동작이 발생했을 때 해당 내용을 discard 파일에 남기는 기능을 활성화 하는 파라미터이다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_DDL_FILE_DIR
주의
DISCARD 기능을 활성화하면 batch apply 기능이 사용 불가능하다.
DML을 반영할 때 발생하는 에러에 대해서 만 DISCARD 기능을 지원한다.
(12032)Deadlock detected. 에러는 DISCARD 기능을 지원하지 않는다.
SAM_BIND_VALUE=Y 를 사용하면, discard log에 실패한 query의 value 값이 함께 저장된다.
주의
건너뛴 DML은 Apply 로그에 skip insert stmt because of cast error.(xid: <xid>) 형태의 경고로 남는다. UPDATE, DELETE도 같은 형식으로 남는다.
DISCARD_FILE_YN=Y이면 discard 파일에 cast error discarded와 함께 해당 DML의 xid, seqno, tsn, obj_id가 기록된다. SQL 문은 기록되지 않는다.
주의
단, TABLE 관련 DDL은 해당 기능을 사용하더라도 실패하는 경우 생략할 수 없다.
discard file의 저장 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: $PRS_HOME/var/<인스턴스명>/ddl_err
DISCARD_CAST_ERR=[Y|N]
DISCARD_FILE_YN=[Y|N]DISCARD_DDL_YN=[Y|N]
DISCARD_DDL_FILE_YN=[Y|N]
DISCARD_DDL_FILE_DIR=/directory/to/save/file
DISCARD_DDL_FILE_SIZE=200M
DISCARD_DDL_BACKUP_DIR=/directory/to/save/backup/file
DISCARD_DDL_BACKUP_SIZE=10G