Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
Loading...
ProSync Admin Utility의 설치 방법 및 실행 명령어를 안내한다.
ProSync Admin Utility는 ProSync를 설치하는 과정에서 함께 설치된다.
ProSync Admin Utility를 실행하는 명령어의 문법은 다음과 같다.
prs_adm [options] [script]-h, --help
도움말 화면을 출력한다.
ProSync Admin Utility 실행 과정은 다음과 같다.
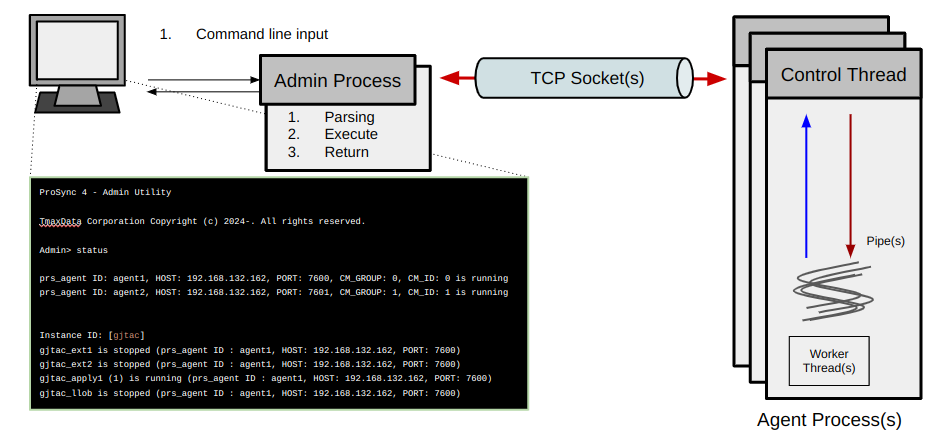
ProSync Admin Utility가 정상적으로 실행되면 위 예제처럼 Admin 프롬프트가 나타난다.
이 프롬프트에서 데이터베이스 사용자는 ProSync 관리를 위한 명령을 실행할 수 있다.
본 문서는 ProSync Extract 프로세스에 대한 대부분의 내용을 포함하고 있다. Extract 프로세스 정의부터 역할 및 세부적인 Configuration 등을 안내한다.
본 장에선 Apply 프로세스의 주요 기능들을 설명한다. Apply 프로세스 운영을 위한 핵심적인 요소들로서 원활한 운영에 도움이 될 수 있다.
ProSync는 Apply 프로세스 지연 시 모든 곳에 지연이 발생하게 된다. 이 때문에 성능을 올릴 수 있는 수단들이 존재한다. 본 장에서는 Performance 측면에서 설정할 수 있는 Configuration들에 대해 알아본다.
본 문서는 ProSync Apply 프로세스에 관한 설명과 운영 등 전반적인 내용을 포함한다. Apply 프로세스 정의 및 역할, 세부적인 Configuration 등을 안내한다.
Llob 프로세스에서 사용 가능한 기능에 대해 설명한다. 주로 사용하는 파라미터로서 Multi Thread용 파라미터 내용을 안내한다.
-v, --version
버전을 출력한다.
filename
파일명이다.
ext
파일의 확장자로, 지정하지 않을 경우 SUFFIX 시스템 변수에 지정된 확장자가 기본값이다.
ProSync Admin Utility 인터페이스에 대해 소개한다.
ProSync Admin Utility는 다음과 같은 특성을 가진 인터페이스로 실행한다.
Admin>ProSync Admin Utility가 정상적으로 실행되면 위와 같은 Admin 프롬프트가 출력된다. 프롬프트에서 ProSync Admin Utility 명령어를 입력할 수 있다.
대소문자를 구분하지 않는다.
다음은 ProSync Admin Utility 실행 화면이다.
위의 예에서는 ProSync Admin Utility를 실행한 뒤 HELP 명령어를 통해 ProSync Admin Utility가 지원하는 명령어를 확인할 수 있다. 이처럼 ProSync Admin Utility는 텍스트 모드의 화면에서 입력을 받고, 사용자의 요구에 따라 결과를 출력한다.
@filename[.ext]$ prs_adm
ProSync 4 - Admin Utility
TmaxData Corporation Copyright (c) 2024-. All rights reserved.$ prs_adm
ProSync 4 - Admin Utility
TmaxData Corporation Copyright (c) 2024-. All rights reserved.
Admin> HELP ProSync Admin Utility는 ProSync의 효율적인 사용을 위한 대화형 유틸리티이다. 이 유틸리티로 ProSync 프로세스의 기동, 정지, 일시정지와 같은 관리를 할 수 있다. 또한, ProSync 관리자는 시스템 관리를 위한 명령을 실행할 수 있다.
ProSync Admin Utility는 이러한 기본 기능 외에도 운영체제 관련 명령어의 실행, ProSync Admin Utility의 파라미터 확인, 스크립트 기능 등을 제공한다. 특히 스크립트 기능은 여러 ProSync Admin Utility 명령어를 하나의 스크립트 파일로 생성할 수 있어 편리하다.
ProSync Admin Utility는 다음과 같은 기능을 제공한다.
ProSync INSTANCE_ID별 기동, 일시정지, 재개, 정지
특정 프로세스의 기동 및 정지
스크립트를 통한 일괄 작업의 실행
ProSync 프로세스들의 상태 조회
운영체제 관련 명령어의 실행
ProSync Admin Utility의 파라미터 설정 및 조회
수행한 명령어에 대한 이력 관리
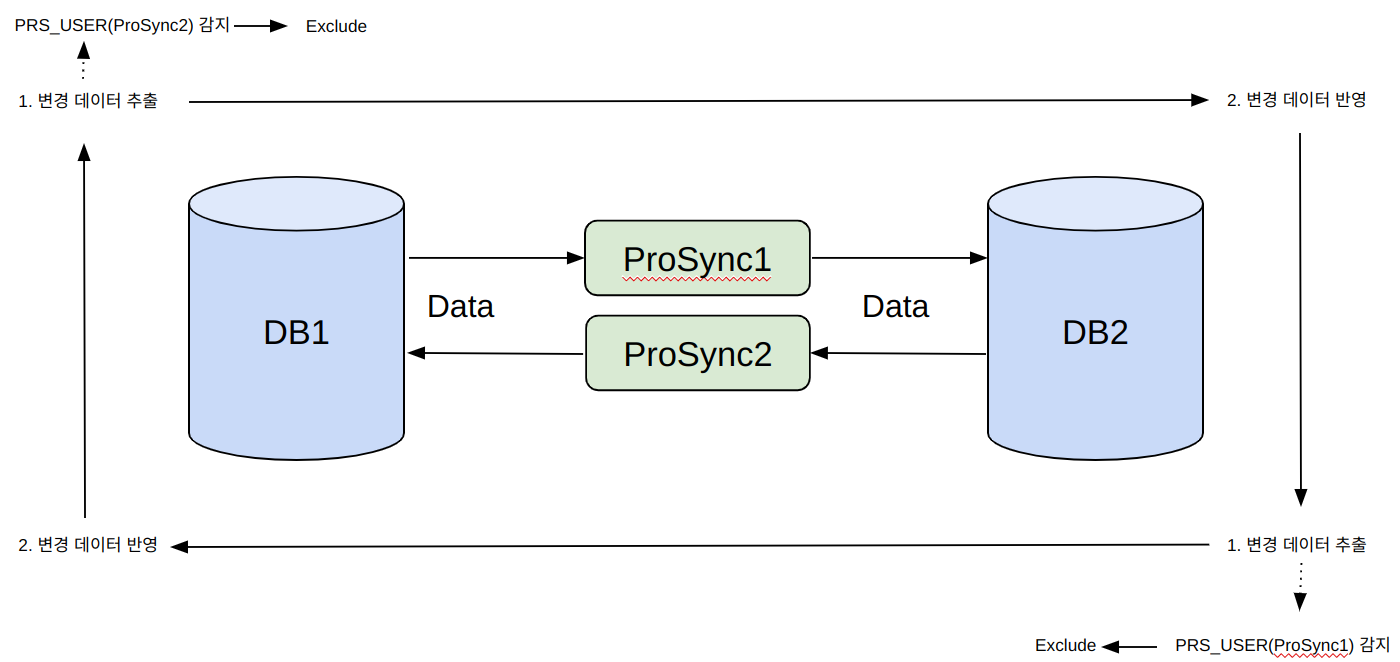
ProSync는 특정 사용자에 의해서 발생된 DML 및 DDL을 동기화에서 제외할 수 있는 기능을 제공한다.
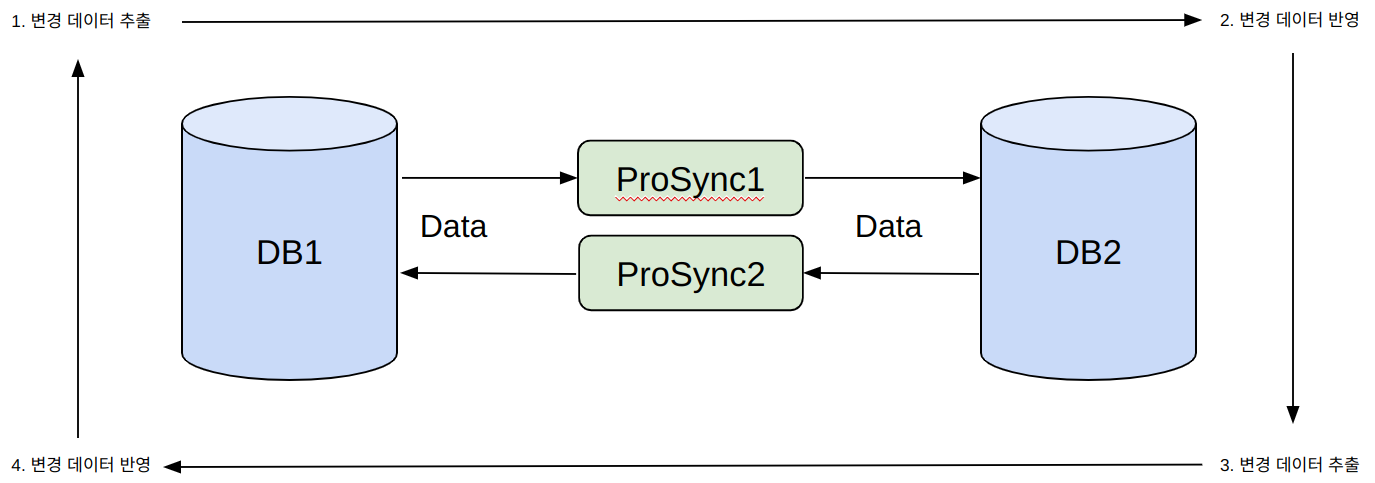
같은 테이블에 대해 Source DB에서 Target DB로, Target DB에서 Source DB로 동기화 하도록 2개의 ProSync 인스턴스를 사용하여 구성할 수 있다. 이 경우, 별 다른 설정이 없다면 상대방의 PRS_USER가 반영한 동기화 데이터가 다시 추출되어 Source DB로 전송될 수 있다.
Redo Log에는, tx에 대해 이를 수행 한 User를 알 수 있는 정보가 있으며 ProSync는 이 정보를 활용해 상대방의 PRS_USER로 EXCLUDE_USER 파라미터를 설정하여 이미 반영한 데이터를 재반영하는 현상을 막을 수 있다.
다음은 TEST 사용자와 PRS_USER 사용자를 동기화에서 제외하는 예제이다.
EXCLUDE_USER=PRS_USER,TEST
Source DB가 Tibero, Oracle인 경우, 암호화된 테이블에 대한 동기화를 지원한다. 암호화된 테이블 동기화를 위해서는 복호화를 위한 Wallet file 접근 권한이 필요하다.
TDE_FOR_EXT=[Y|N]
TDE_WALLET_FILE=file_path
TDE_WALLET_PWD=wallet_password
TDE_FOR_APPLY=[Y|N]
TDE_FOR_TABLESPACE=[Y|N]
ProSync는 Extract 프로세스에서 Apply 프로세스로 데이터를 전송할 때 네트워크 부하 감소를 위한 데이터 압축을 사용할 수 있다.
ENABLE_NETWORK_COMPRESS=[Y|N]
NETWORK_COMPRESS_LEVEL=compress_level
ProSync의 Flow Control을 위해 사용되는 기능들을 정리한 문서이다. 데이터가 동기화되는 일련의 과정이 안정적으로 운영되기 위해선 데이터 처리 속도가 관건이다.
처리가 너무 느리다면 동기화 로직 상 데이터는 계속해서 쌓이게 된다. 쌓인 데이터를 계속해서 메모리에 적재하면 당연히 문제가 발생하기 때문에 임계값을 통해 데이터를 파일로 저장하거나 일시적으로 지연시키는 동작이 수행된다.
또한 처리 속도를 올리기 위해서 사용되는 기능들도 존재한다. 처리 속도가 빠르면 그만큼 추출한 데이터가 실시간성이 높게 반영이 된다는 의미이므로, 이 부분을 고려하여 환경 설정을 하는 것이 좋다.
마지막으로 에러가 발생했을 때, 정합성을 위해 기본적으로 동기화가 멈추게 되어있는데, 이렇게 되면 데이터가 더이상 처리될 수 없어서 영구적인 지연이 발생할 수 있다. 따라서 에러가 발생했을 때, 이를 자동으로 생략하거나 Rule에 맞춰서 데이터를 처리하는 방법에 대해서도 알아본다.
Agent 프로세스에 대해 안내한다.
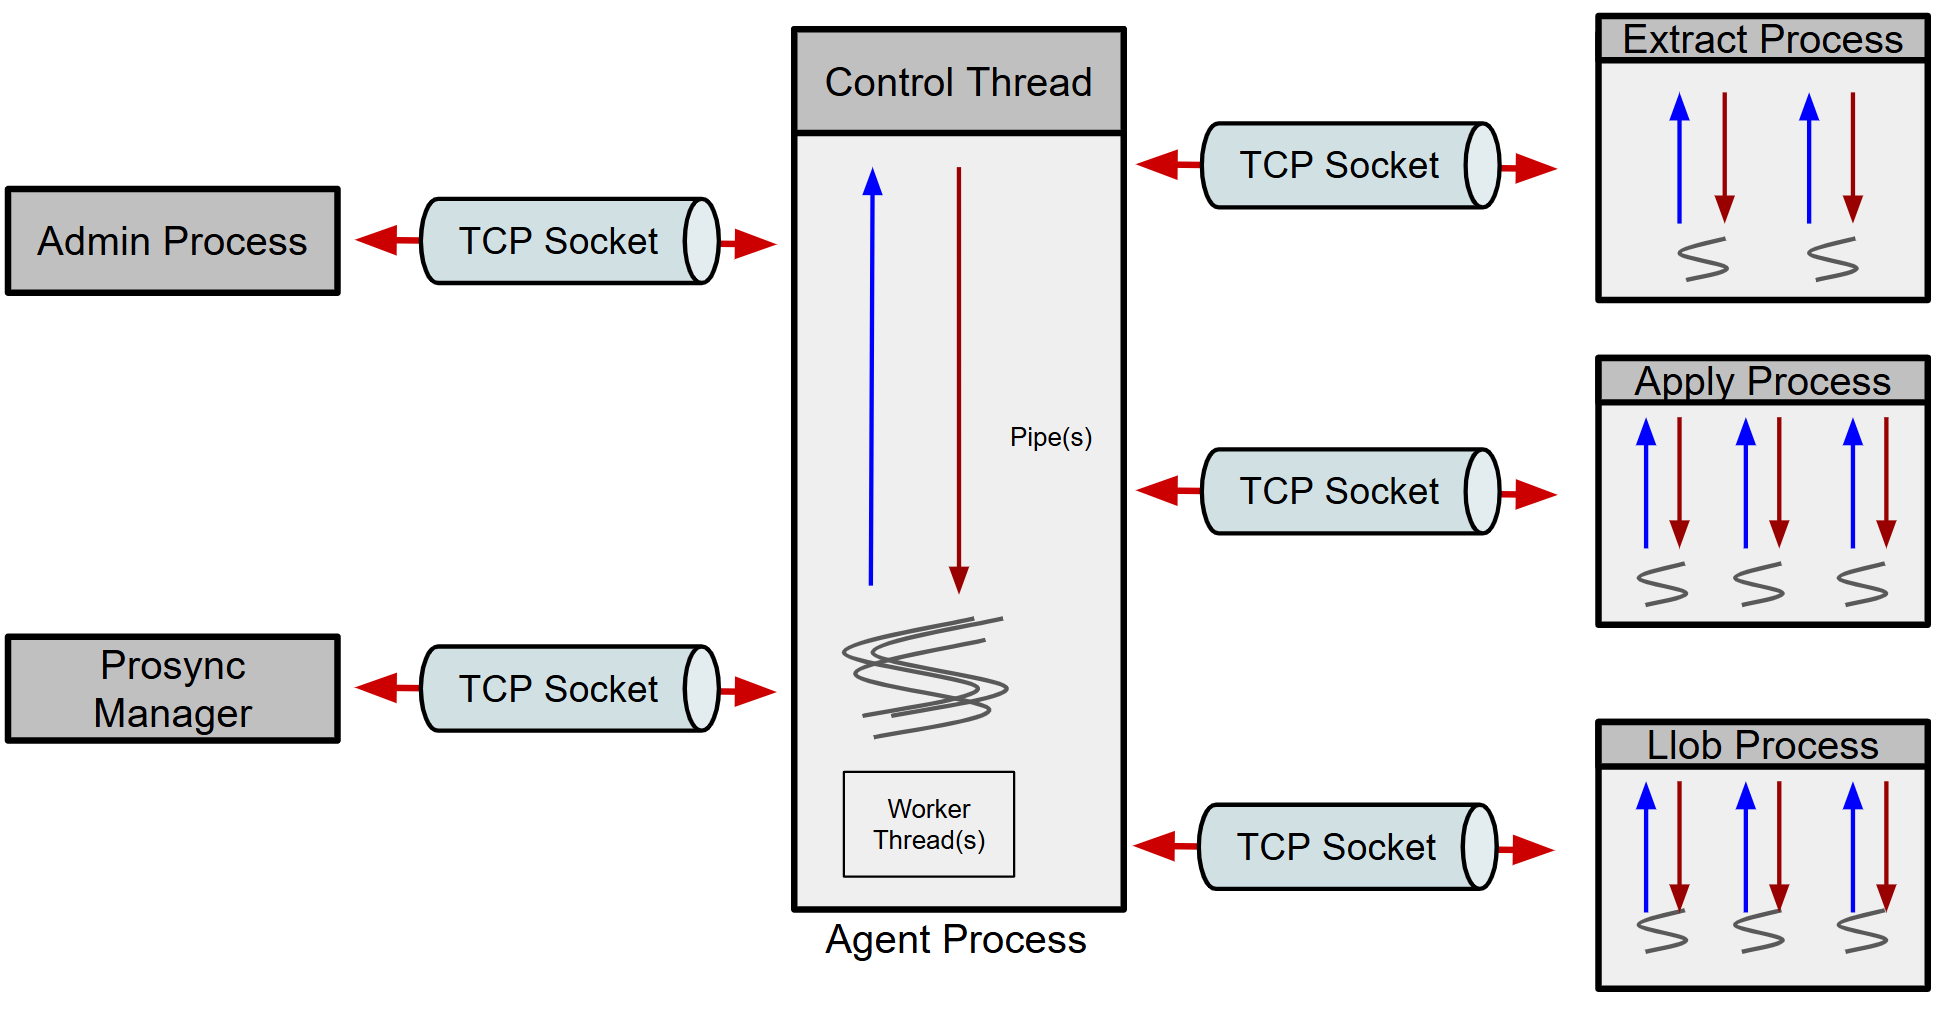
Agent 프로세스는 Admin 프로세스 또는 ProSync Manager로부터 메시지를 수신하면, 이를 ext, apply, llob 프로세스에 전달하고, 처리 결과를 다시 Admin 프로세스 및 ProSync Manager에 전달한다. 또한, ext, apply, llob 프로세스의 기동, 종료 등의 작업을 수행한다. 추가적으로 CM Failover 기능을 사용하는 경우 CM 모니터링 및 하위 프로세스 모니터링 작업도 수행한다.
기동 시 다른 Thread 시작, 메시지 수신 및 전송 등의 작업을 수행한다.
ext, apply, llob 프로세스의 기동, 종료 등의 작업을 수행한다.
CM Failover 기능을 사용하는 경우 CM을 모니터링하여 CM 상태에 따라 하위 프로세스의 기동, 종료 작업을 수행한다. CM Failover 기능에 대한 자세한 내용은 을 참고한다.
데이터 충돌 발생 시, 처리방안에 대해 확인한다.
본 장에서는 Map 파라미터를 통해 설정할 수 있는 Resolution Rule (DCR)과 Schema Mapping을 위한 DDL 설정에 대해 알아본다. Mapping은 기본적으로 테이블명, 컬럼명에 대한 Mapping을 지원한다.
성능 향상을 위해, Apply 프로세스의 요청에 따라 Source DB에서 데이터 조회를 수행할 Read Thread 의 개수를 설정할 수 있다.
LLOB_THREAD_CNT=[1-4]
LLOB_THREAD_CNT
기동 시 생성할 Read Thread 의 개수를 설정한다
ProSync에는 DML 이력을 확인할 수 있는 다양한 기능들이 있다. config파일에서 로그 레벨을 5레벨로 높이면, 반영하고 있는 SQL과 Bind할 Value들이 byte array 형태로 남게 된다. 다만 로그 레벨을 반드시 높여야 한다는 점과, bind value들이 별도로 남으므로 실제 SQL로 바로 처리할 수 없다는 단점이 있다.
본 장에서는 위와 같은 상황에서 확인할 수 있는 SAM(Sequential Access Method) 파일 기능과 DML 에러 발생 시의 report 파일, DML 이력 확인 기능 등에 대하여 기술한다.
NETWORK_COMPRESS_LEVEL
데이터 압축 기능을 사용할 때 데이터 압축률을 설정한다.
0~9까지 설정 가능하며, 0으로 설정한 경우 압축을 하지 않고 9에 가까워질수록 압축률이 커진다.
ENABLE_NETWORK_COMPRESS
전송하는 Chunk의 압축 여부를 결정한다.
EXCLUDE_USER
동기화에서 제외할 사용자 이름을 콤마(,)로 구분해 나열한다. 사용자 이름은 데이터베이스에 저장된 형태(일반적으로 대문자)로 입력한다.
TDE_FOR_EXT
데이터 복호화 기능 사용 여부를 설정한다.
설치 config 파일에 USE_TDE=Y를 설정하면 설치 과정에서 Source DB의 Wallet 비밀번호를 입력받고, TDE_FOR_EXT와 TDE_FOR_APPLY를 Y로 설정한다. 암호화된 테이블에 대하여 Sam 기능을 사용하려면 반드시 Y로 설정해야 한다. source db가 oracle 인 경우, TDE_FOR_TABLESPACE를 설정하지않아도 암호화된 Tablespace 동기화를 수행한다.
TDE_WALLET_FILE
Source DB에서 생성한 Wallet file의 경로를 설정한다. 반드시 절대 경로를 포함하여 입력해야 한다. Source DB가 Oracle인 경우 wallet 파일(ewallet.p12)을 지정한다. 설치 config 파일에 USE_TDE=Y를 설정해 설치하면 이 값에 인스턴스 디렉터리($PRS_HOME/var/<인스턴스>/)가 기록되므로, 설치 후 Extract · Apply 설정 파일에서 wallet 파일의 절대 경로로 수정해야 한다. wallet 파일이 아닌 경로가 지정되어 있으면 Extract와 Apply가 기동하지 않는다. ProSync가 Source DB와 다른 호스트에서 실행되는 경우 wallet 파일을 ProSync 호스트로 복사해 그 경로를 지정한다.
TDE_WALLET_PWD
Source DB에서 생성한 Wallet file의 Password를 입력한다. 설치 과정에서 입력했다면, 자동적으로 ProSync가 해당 정보를 암호화하여 저장하여 #encrypted 값으로 나타나며, 설치 과정에서 입력하지 않았다면 비밀번호를 직접 입력하거나 수동으로 ProSync Wallet을 생성해주어야 한다.
TDE_FOR_APPLY
데이터 복호화 기능 사용 여부를 설정한다. Apply 프로세스에서 설정하며 TDE_FOR_EXT와 동일하게 동작한다. Source DB가 Oracle인 경우 암호화된 컬럼의 값은 Apply 프로세스가 복호화하므로, 암호화된 컬럼이 있는 테이블을 동기화하려면 반드시 Y로 설정하고 Wallet을 지정해야 한다. 설정하지 않으면 해당 테이블의 메타데이터를 처리할 때 Apply 프로세스가 중단된다.
TDE_FOR_TABLESPACE
ProSync Admin Utility의 환경을 설정하는 방법과 시스템 변수에 대해 안내한다.
시스템 변수는 SET 명령어를 통해 변경할 수 있다.
명령어 히스토리의 크기를 설정한다.
SET HIS[TORY] {n}n
명령어 히스토리의 크기이다. (기본값: 50)
화면상의 한 라인의 길이를 설정한다. 라인 길이의 최소값은 1이며, 최댓값은 운영체제에 따라 다르다.
NUMBER 타입을 출력할 길이를 설정한다. LINESIZE를 넘을 수 없다.
한 화면에 출력할 라인 수를 설정한다.
화면상의 프롬프트 문자를 설정한다.
파일 확장자를 생략했을 때 사용할 파일 확장자를 설정한다.
Redo Log는 물리적인 위치에 대한 변경분이 남는다. RDBMS (주로 Oracle, Tibero) 에서는 row 데이터가 ROWID 라는 고유의 값을 가지게 되는데, 이 ID에는 데이터 파일의 위치, 파일 내 데이터 블록의 위치, 블록 내 row의 위치 에 대한 정보가 저장되어있다.
ProSync는 이 물리적으로 정해진 ROWID만 가지고는 Target Database에서 정확하게 어떤 row인지 판별할 수가 없다. 왜냐하면 데이터 파일도 다를 것이고, 블록 위치나 row 위치 정보도 모두 다르기 때문에 ROWID로는 서로 다른 Database의 row를 매칭 시키기가 어렵다.
따라서 SUPPLEMENTAL_LOGGING옵션 등을 통해 row 데이터의 추가적인 정보를 Redo Log상에 함께 남기게 된다. 예를 들면, 사용자가 Where Clause에 1개의 Column정보만 넣었다고 하더라도, Redo Log에는 해당 Row 내에 있는 모든 Column 정보가 다 남도록 해준다.
Target Database와 Apply 프로세스는 이 정보를 가지고 쿼리를 재구축한다. 다만 이렇게 되면, Primary key 를 가지고 있는 테이블 입장에선 불필요한 다른 컬럼 정보들을 Where Clause에 입력해주는 경우가 생긴다. Database의 플랜 별로 최적화되어 잘 처리될 수도 있지만, 불필요한 상황 자체를 방어하기 위해 ProSync에선 Primary key만 사용할지에 대한 여부를 파라미터로 관리한다.
USE_PK_FOR_WHERE
이 파라미터를 사용하면 Primary key가 있는 테이블에 대한 Update나 Delete 시에 Where Clause에는 Primary key만 입력하게된다.
주의
Data Conflict Rule(DCR) 관련
옵션을 사용할 경우 USE_PK_FOR_WHERE 옵션은 무시된다. 동기화의 논리 구조상 Conflict를 찾는 것이 우선이기 때문에 ProSync에선 두 옵션 간에 이와 같은 우선순위를 둔다.
Source DB가 Tibero인 경우 압축 테이블에 대한 동기화 지원을 설명한다.
Source DB가 Tibero인 경우, 압축된 테이블에 대한 동기화를 지원한다. 압축 테이블의 변경 데이터는 Redo Log에 압축 심볼 참조 형태로 기록되며, Extract 프로세스는 Supplemental Log에 포함된 심볼 매핑 정보를 이용하여 이를 원본 값으로 복원한 후 동기화한다.
압축 테이블 동기화를 위한 별도의 파라미터 설정은 필요하지 않으며, 다음 조건을 만족하면 자동으로 동작한다.
동기화 대상 테이블에 Supplemental Logging이 설정되어 있어야 한다.
Source DB(Tibero)와 ProSync 모두 압축 테이블 동기화를 지원하는 버전이어야 한다.
SQL> CREATE TABLE TEST.T_COMP (C1 VARCHAR(2000), C2 NUMBER) COMPRESS FOR OLTP;
SQL> ALTER TABLE TEST.T_COMP ADD SUPPLEMENTAL LOG DATA (ALL) COLUMNS;Extract 프로세스에서 Source DB에 생성하고 사용하는 메타 테이블에 대해 안내한다.
동기화할 object들의 Type, Owner, Name, 등록 시기를 저장한다.
tlr(olr)파일의 위치, seq 정보를 저장한다.
tlr(olr)파일은 Redo Log를 모두 읽고 다음 Log를 읽기 전 아직 commit되지 않은 tx 정보를 저장한 파일로 ProSync는 Begin이 없는 tx에 대해서는 추출하지 않기 때문에, 기동 시점에 따라 누락되는 tx가 없도록 이전 Redo Log를 읽었을 때 아직 commit되지 않은 tx정보를 저장한다.
발생한 DDL의 시점, DDL 종류, 메타 테이블 업데이트 여부, 이후 ProSync가 사용하는 DD의 Sequence 정보를 저장한다.
Source DB가 Oracle이며 Log Miner를 사용하여 동기화 하는 경우 사용한다. DD 정보를 저장한 dict파일 정보를 저장한다.
Source DB에 존재하는 USER들의 이름과 USER_ID를 저장한다. User Filtering 기능을 사용하기 위해 저장한다.
동기화 테이블의 DD sequence, object id, 테이블명 정보를 저장한다. Redo Log는 object id만 남기기 때문에, 해당 정보를 Apply 프로세스에 전달하여 적절하게 반영 쿼리를 생성한다.
특정 object_id가 어느 테이블에 속하는지 정보를 저장한다.
파티션 등에 저장되는 데이터는 테이블과는 다른 object_id를 남기기 때문에, 해당 데이터를 문제없이 추출하기 위해 파티션의 object_id와 테이블의 object_id를 매핑한다.
컬럼의 속성과 어느 테이블에 속하는지 정보를 저장한다. Redo Log는 컬럼 속성 정보를 남기지 않기 때문에, 해당 정보를 Apply 프로세스에 전달하여 적절하게 반영 쿼리를 생성한다.
컬럼의 제약 조건 정보를 저장한다. Apply 프로세스의 Parallel Replay에서 적절하게 반영 순서를 조합하기 위하여 사용된다.
테이블의 암호화 정보를 저장한다. Apply 프로세스에서 복호화하기 위해 저장한다.
변경 데이터가 없는 경우에도 추출, 반영에 문제 없는지 확인용으로서 주기적으로 부하를 발생시키기 위한 목적으로 사용된다. 부하가 없는 경우, 주기적으로 해당 테이블에 대한 부하를 발생시킨다.
Source DB가 Oracle이며 Log Miner를 사용하여 동기화 하는 경우 사용한다. 마지막으로 추출한 시점 정보를 저장한다.
시퀀스 동기화를 위한 정보를 저장한다.
ProSync의 초기적재 기능을 사용하기 위한 정보를 저장한다.
Source DB가 Oracle이며 Log Miner를 사용하여 동기화 하는 경우 사용한다. instance 이름을 저장한다.
Batch Execution은 RDBMS 상에서 우리가 사용하는 Batch 관련 API라고 이해하는 것이 용이하다. DML 각각을 모두 쿼리 형태로 변환하여 전달하기보단, 같은 형태의 쿼리라면 데이터를 Batch단위로 모아서 서버에서 사용하도록 하는 기능이다.
이 기능을 사용하면 Insert 와 같은 DML이 연속해서 들어올 때, Target Database 의 성능을 향상 시킬 수 있다. 이를 통해 데이터 처리 속도를 증가 시키고 동기화 속도를 끌어 올려줄 수 있다.
하지만 제약사항도 존재하는 기능으로, 아래와 같은 두가지 관점에서 고려할 수 있다.
같은 형태의 쿼리
Batch로 모았을 때의 한계
ProSync는 한 트랜잭션에서 DML이 연속해서 들어올 때 이 순서를 임의대로 바꾸지 않는다. 입력되는 모든 쿼리를 순서대로 적용해야 정합성이 깨지지 않는다는 대전제 때문에 이와 같이 처리가 된다.
문제는 이렇게 되면 Insert * 3, Update*3, Delete* 3의 순서로 데이터가 들어올 때와 (Insert, Update, Delete) * 3의 순서로 데이터가 들어올 때 Batch Execution 입장에서 큰 차이가 발생한다.
유사한 쿼리가 연속해서 들어온다면 ProSync는 이를 Batch로 묶어서 처리를 할 수가 있지만, 쿼리들의 형태가 연속적이지 않게 들어온다면 Batch로 처리할 수가 없다. 따라서 두 트랜잭션의 결과가 동일하더라도 하나는 Batch 처리가 가능하고 다른 하나는 Batch 처리가 불가능하다.
트랜잭션 내에 같은 형태의 쿼리들이 연속해서 들어온다고 가정을 하여도 성능 향상이 미미한 경우도 존재한다. 예를 들어 Insert의 경우 Batch 동작을 통해 데이터의 개수나 크기 등을 Target Database에 미리 알려준다면 Database는 이에 맞는 플랜을 세워서 최적화 하여 처리가 가능하다. 하지만 Delete나 Update 처럼 각 row 별로 Where Clause에 의해 따로 탐색을 해야 하는 형태로 들어온다면 아무리 모아 보내도 서버 입장에선 하나씩 처리하나, 모아서 들어온걸 하나씩 처리하나 큰 차이가 없다고 볼 수 있다.
따라서 ProSync는 특별한 설정이 없다면 Insert에 대한 Batch만 처리하는 것이 기본 동작이다. 하지만 Database 별로 처리하는 방식이 달라질 수 있기 때문에 Batch 사용 여부는 파라미터로 모두 관리가 된다.
Parameter 별 제공하는 기능이다.
USE_BATCH_MODE
기본 값은 Y 로, Batch는 항상 동작하도록 되어있다.
BATCH_MEM_SIZE
기본 값은 10MB로 서버에 보낼 때 최대 10MB의 데이터까지만 쌓고 쿼리에 대한 처리를 요청한다.
USE_ONLY_INSERT_BATCH
Insert 만 Batch 로 처리할 것 인지에 대한 파라미터로 기본 값은 Y 이다.
ProSync는 Source 데이터베이스의 Sequence 객체 값을 Target 데이터베이스로 실시간 동기화하는 기능을 제공한다. Sequence의 NEXTVAL이 호출되며 속성값이 갱신될 때 마다 Target으로 전달된다.
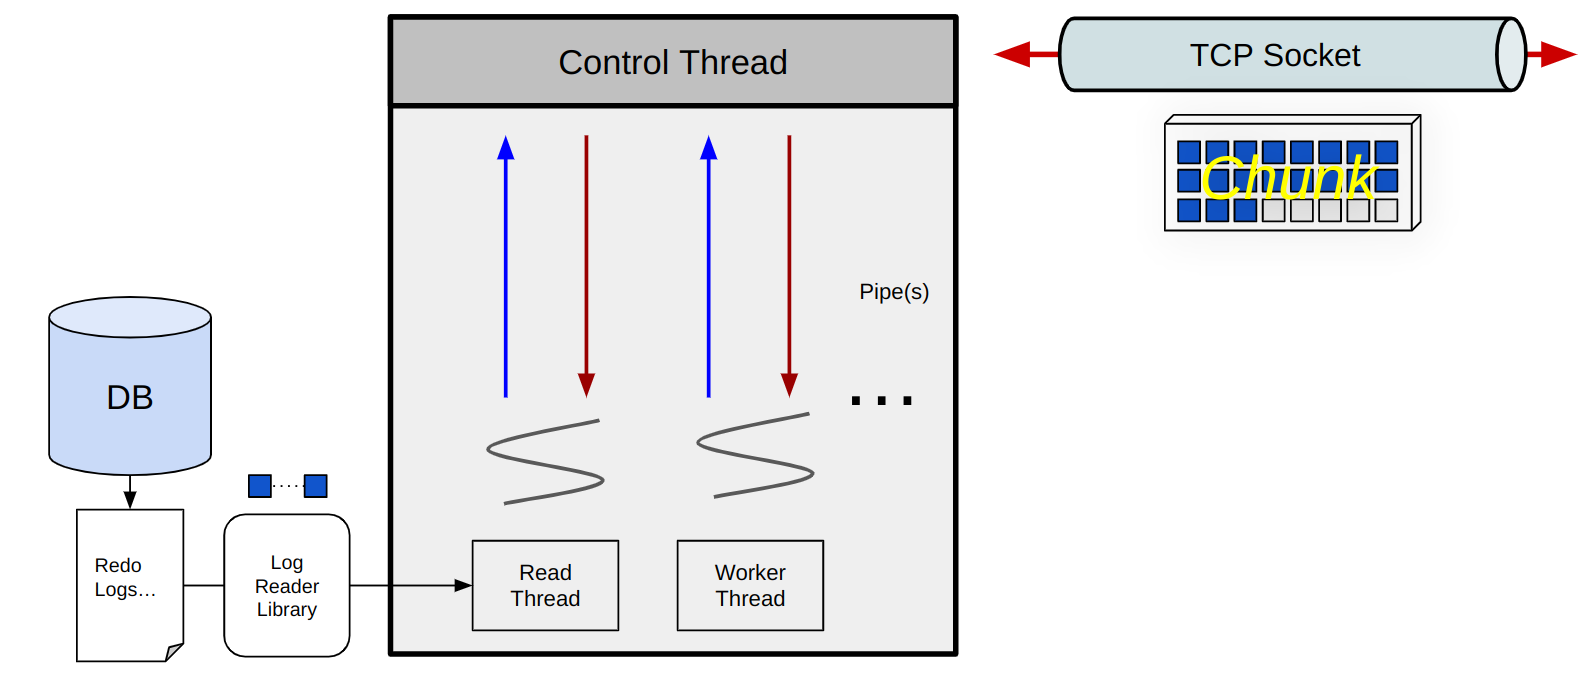
Extract 프로세스는 Source DB의 변경 로그를 추출하여 Apply 프로세스로 전달하는 동작을 수행한다.
Source DB가 Tibero 또는 Oracle인 경우, redo log를 읽어 변경 로그를 추출하므로 반드시 redo log에 접근 가능한 위치(일반적으로 Source DB가 존재하는 장비)에서 기동되어야 한다.
Source DB가 PostgreSQL인 경우에는 WAL logical replication 연결(network)을 통해 변경 로그를 추출하므로 반드시 Source DB 서버에 기동될 필요는 없으며, Source DB에 network로 접속할 수 있고 replication 권한이 있는 위치라면 기동할 수 있다.
변경의 최소 단위는 LCR로, 레코드 단위의 변경을 의미하며 네트워크 부하를 고려하여 여러 LCR을 Chunk로 만들어 Apply 프로세스에 전달한다.
기동 시 다른 Thread 시작, 메시지 수신 및 전송 등의 작업을 수행한다.
프로세스의 CPU/Memory 사용량을 수집한다. ProSync 매니저 사용 시, Agent 프로세스를 통해 수집한 값을 ProSync 매니저로 전송한다.
동기화 테이블 추가, 동기화 할 테이블 및 컬럼들의 정보인 DD image 조회, DB의 상태 파악을 위한 dummy tx 생성 등 변경 데이터 추출과는 상관없는 메타데이터 조회나 수정과 같은 작업을 수행한다.
APPLY 프로세스가 동기화 진행 중 DML 반영을 실패 또는 장애 상황이 발생했을 때 일정 횟수를 재시도 한 뒤 report 파일로 write하는 기능이다.
DML에 관해서만 기록이 가능하며, APPLY 프로세스의 config 파일인 [inst_id]_apply1.cfg 파일에 다음의 파라미터를 설정해야 한다.
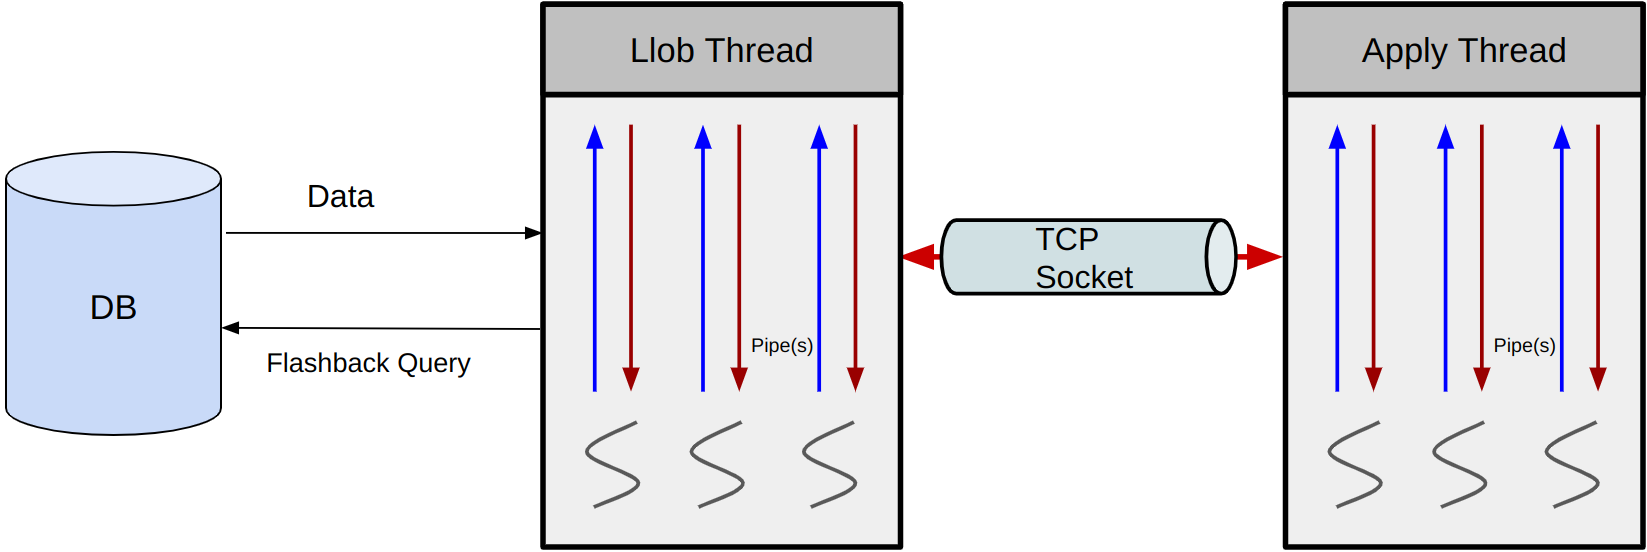
Llob 프로세스는 Apply 프로세스의 요청에 따라 Source DB의 Long, Clob, Blob 등의 대용량 데이터를 전달하는 동작을 수행한다.
기동 시 다른 Thread 시작, 메시지 수신 및 전송 등의 작업을 수행한다. Apply Thread의 요청이 오는 경우, 적절한 Read Thread 에 전달한다.
Apply Thread의 요청에 따라 Source DB에 flashback query를 통해 llob 데이터를 조회하고 이를 Control Thread를 통해 요청한 Apply 프로세스에 전달한다.
해당 시점으로 flashback query를 할 수 없는 경우의 동작은 LLOB_FLASHBACK_ERROR 파라미터 설정에 따라 다르다.
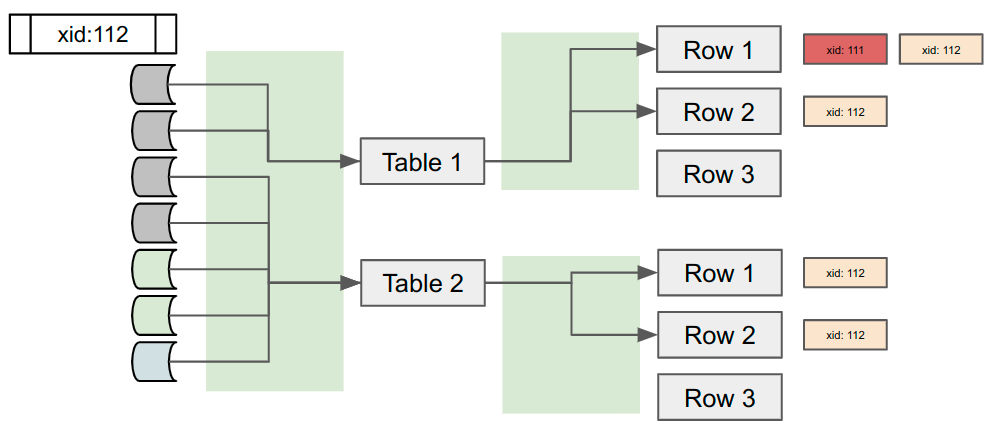
커밋이 요청된 트랜잭션은 반영을 할 수 있으면 반영을 하고, 반영을 할 수 없으면 큐에서 대기하게 된다. 반영 가능 여부는 반영하고자 하는 트랜잭션과 반영 중인 트랜잭션 간의 의존성 체크를 통해 서로 독립적일 경우 반영이 가능하다고 판단한다.
의존성 체크는 Table과 Row 단위 모두 확인을 한다. 트랜잭션은 레코드로 이루어져 있고, 레코드에는 레코드가 접근하는 Row가 정해져 있기 때문에, 해당 데이터를 기반으로 다른 트랜잭션과 의존 관계인지 여부를 판단한다.
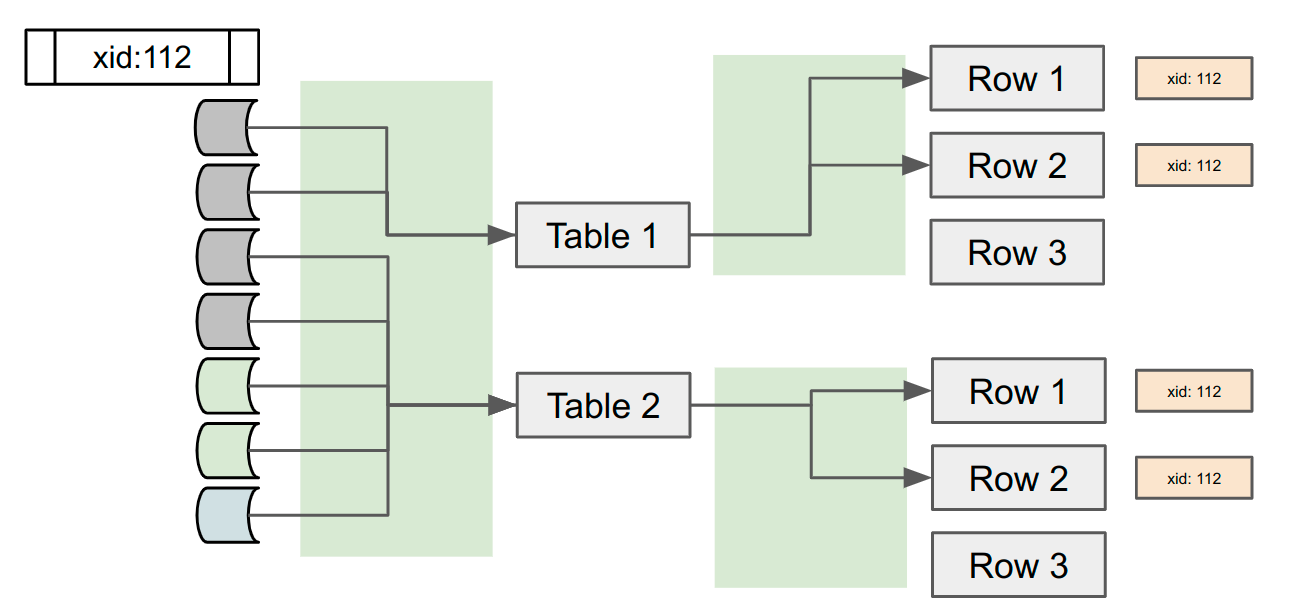
의존성 확인 동작은 RedBlack Tree(RBT)와 Linked List로 관리가 되고 있다. Table 단위로 RBT를 확인하고, Table이 확인되면, 해당 Table 노드 내의 RBT에서 Row를 확인한다. 이 위치엔 Linked List가 존재하며, 트랜잭션은 해당 List에 의존성 객체(TX Dependency)를 달아 놓는다.
이 동작을 통해 트랜잭션이 접근하는 모든 Row에 대한 Linked List에 TX Dependency가 등록이 된다. 반영 중인 트랜잭션이나 반영 대기 중인 트랜잭션 모두 이 구조 안에서 관리된다.
반영 가능 여부는 트랜잭션의 모든 TX Dependency가 Linked List의 front에 존재하는 지의 여부로 확인한다. 하나라도 front에 존재하지 않는다면 반영이 불가능하고, 앞서 반영 중인 트랜잭션의 완료를 대기하게 된다.
반영이 가능한 경우는 위 그림과 같이 모든 의존성 체크를 했을 때 Linked List 상에 TX Dependency 가 가장 앞선 경우이다.
Llob 프로세스에 관한 설명 및 운영 방법을 안내한다.
암호화된 Tablespace 동기화를 수행하려면 사용한다. 만약 동기화 대상에 암호화된 Tablespace 를 추가하고 본 파라미터를 활성화 하지 않을 시 에러가 발생한다. source db가 oracle 인 경우, 설정하지 않아도 동작한다.
COMPRESS (Basic Compression)
지원
Direct Path Insert(/*+ APPEND */ 힌트, CREATE TABLE AS SELECT 등)로 적재된 압축 데이터의 추출을 지원한다.
COMPRESS FOR OLTP (OLTP Compression)
지원 INSERT, UPDATE, DELETE 및 Multi Insert, Multi Delete를 포함한 DML 추출을 지원한다.
COMPRESS FOR QUERY, COMPRESS FOR ARCHIVE
미지원 컬럼 단위 압축(Tibero Columnar Compression)이 적용된 테이블은 동기화 대상에 포함할 수 없다.
압축 테이블 동기화를 지원하지 않는 버전의 Source DB와 함께 사용하는 경우, 압축 데이터의 원본 값 복원에 필요한 Supplemental Log 정보가 기록되지 않아 데이터 정합성이 깨질 수 있다.
Extract 프로세스 로그에 comp supp lookup miss 또는 decompress failed 메시지가 나타나면 해당 테이블의 Source DB와 Target DB 간 데이터 정합성 확인이 필요하다.
전송하는 Chunk의 암호화 여부를 결정한다
n
화면상의 한 라인의 길이이다. (기본값: 80)
n
NUMBER 타입 데이터의 기본 출력 길이이다. (기본값: 10)
n
한 페이지의 라인 개수이다. (기본값: 24)
prompt_string
프롬프트로 사용할 문자열이다. (기본값: "Admin>")
이 문자열을 중괄호({ })로 감싸면 환경변수로 인식된다.
예를 들어 '{PRS_PROMPT}'이라고 지정하면 환경변수 $PRS_PROMPT의 값이 치환되어 프롬프트로 사용된다. 이때 환경변수의 이름은 대소문자를 구분한다.
extension
기본으로 사용할 파일 확장자이다. (기본값: sql)
SET LINE[SIZE] {n}SET NUM[WIDTH] {n}SET PAGE[SIZE] {n}SET PROM[PT] {prompt_string}SET SUF[FIX] {extension}Target Oracle Object ID 조회
Target Oracle SGMT ID 조회
조회된 OBJ# 와 DATAOBJ# 를 모두 ROLLBACK_OBJECT_IDS 에 나열한다.
Target Tibero Object ID 조회
SELECT O.OBJ#
FROM SYS.OBJ$ O, SYS.USER$ U
WHERE O.OWNER# = U.USER#
AND O.TYPE# = 2
AND U.TYPE# = 1
AND U.NAME = 'Target Prosync Instance Meta User'
AND O.NAME = 'PRS_COMMITTED_TX_LIST';SELECT DATAOBJ#, OBJ#
FROM SYS.OBJ$ O, SYS.USER$ U
WHERE O.OWNER# = U.USER#
AND O.TYPE# IN (2, 19, 34)
AND U.TYPE# = 1
AND U.NAME = 'Target Prosync Instance Meta User'
AND O.NAME = 'PRS_COMMITTED_TX_LIST'
AND O.DATAOBJ# IS NOT NULL;SELECT O.OBJ_ID
FROM SYS._DD_OBJ O, SYS._DD_USER U
WHERE O.OWNER_ID = U.USER_ID
AND O.TYPE_NO = 1
AND U.TYPE_NO = 1
AND U.NAME = 'Target Prosync Instance Meta User'
AND O.NAME = 'PRS_COMMITTED_TX_LIST';Oracle
Tibero
지원
Source Tibero에서 Sequence의 NEXTVAL이 호출되면, 해당 값이 Target Tibero의 동일 Sequence에 실시간으로 반영된다.
Source와 Target에 동일한 이름의 유저 아래에 동일한 이름의 Sequence가 생성되어 있어야 한다.
ProSync 설치 스크립트가 정상적으로 수행되어 있어야 한다.
동기화 대상 리스트 파일(기본값: prs_obj_group1.list) 파일에 SYS._DD_SEQ 테이블이 기재돼 있어야 한다.
동기화 대상 리스트 파일(기본값: prs_obj_group1.list) 파일에 동기화하고자 하는 SEQUENCE가 기재돼 있어야 한다.
Source Tibero 의 데이터베이스 초기화 파라미터로 _DDL_SEQ_SUPPLOG=Y 를 설정해야 한다. ProSync 의 config 파일에 기재하는 파라미터가 아니다.
Target Tibero 의 데이터베이스 초기화 파라미터로 SEQ_GET_NEXTVAL_FROM_DD_TABLE=Y 를 설정해야 한다. ProSync 의 config 파일에 기재하는 파라미터가 아니다.
Sequence 생성 시 NOCACHE 옵션으로 생성 필요하다.
Source, Target DB 의 동기화 대상이 되는 SEQUENCE 짝의 설정값은 일치해야 한다.
프로싱크에서 Sequence ALTER 수행 시 타겟 DB에서 SYS._DD_SEQ NEXTVAL 값을 기준으로 Boundary Check를 수행하기 때문에, 타겟 NextVal 값보다 MAX/MIN 값이 더 작은/큰 경우, TBR-7134 에러가 발생한다.
Source Oracle에서 Sequence의 NEXTVAL이 호출되면, 해당 값이 Target Tibero의 동일 Sequence에 반영된다. Target의 Sequence 값이 Source 와 겹치지 않고, 동일하거나 앞서가도록 동기화가 진행된다.
Source Oracle과 Target Tibero에 동일한 이름의 Sequence가 생성되어 있어야 한다.
ProSync 설치 스크립트가 정상적으로 수행되어 있어야 한다.
동기화 대상 리스트 파일(기본값: prs_obj_group1.list) 파일에 SYS.SEQ$ 테이블이 기재돼 있어야 한다.
동기화 대상 리스트 파일(기본값: prs_obj_group1.list) 파일에 동기화하고자 하는 SEQUENCE가 기재돼 있어야 한다.
Source, Target DB 의 동기화 대상이 되는 SEQUENCE 짝의 설정값은 일치해야 한다.
SEQUENCE 값의 정합성을 위해 ORDER 옵션의 사용이 권장된다.
설치 준비
Instance 설치 과정에서 DB 의 PRS_INSTALL_USER 는 SYS.SEQ$(SYS._DD_SEQ) 테이블 및 동기화 하고자 하는 SEQUENCE 에 대한 SELECT 권한이 필요하다.
동기화 시점
NEXTVAL 호출 시에만 동기화된다. CURRVAL 조회는 동기화되지 않는다.
Sequence 존재 필수
Tibero
Tibero
지원
추출한 변경을 Text 파일로 출력하는 SAM 기능을 수행한다.
변경 데이터를 추출하고 이를 Chunk형태로 만든 뒤 Control 스레드를 통해 Apply 프로세스에 전달한다.
Source DB가 Tibero 또는 Oracle인 경우 Log Reader 라이브러리를 사용해 redo log에 접근하며, PostgreSQL인 경우 logical replication 연결을 통해 WAL을 읽는다. 비정상 종료, Apply 프로세스 재연결 등의 장애 상황 발생 시, 마지막으로 읽고 있던 redo를 처음부터 다시 읽기 시작한다.
추출 시작 지점은 Apply 프로세스에 저장되어 있기 때문에, Apply 프로세스와 연결 전까진 추출을 시작하지 않는다.
Dml Error Report 기능에 의해서 report file write가 시작되기 전 재시도 횟수를 설정하는 파라미터이다. (기본값: 20)
APPLY_REPORT_DIR
report 파일이 남겨질 디렉터리를 설정한다.
(기본값: [prosync_directory]/var/[inst_id]/dml_err)
APPLY_REPORT_FILE_SIZE
각 프로세스 별 DML error report 파일의 최대 크기를 설정한다. report 파일의 크기가 APPLY_REPORT_FILE_SIZE를 넘으면 APPLY_REPORT_BACKUP_DIR로 옮긴 후 새로운 report 파일을 생성한다. (기본값: 100MB, 범위: 1MB ~ 1GB)
APPLY_REPORT_BACKUP_DIR
DML error report 파일의 백업 파일이 저장되는 디렉터리 위치를 설정한다.
APPLY_REPORT_BACKUP_SIZE
APPLY_REPORT_BACKUP_DIR에 백업되는 report 파일들의 최대 크기를 설정한다. 각 프로세스 별로 백업된 총 report 파일의 크기가 APPLY_REPORT_BACKUP_SIZE를 넘으면 가장 오래된 파일부터 순차적으로 삭제한다. (기본값: 0, 범위: 0 ~ 128GB)
APPLY_TO_REPORT
Dml Error Report 기능의 사용 여부를 결정한다. (Y|N)
Y : report file에 row by row로 DML이 남게 된다. (기본값)
N : report file에 row by row로 DML이 남지 않는다.
APPLY_DML_ERR_REPORT_CNT
CURRENT (기본값)
flashback query의 AS OF 절을 제거하고 현재 시점의 데이터로 다시 조회한다.
SKIP
해당 데이터의 조회를 건너뛴다.
주의
SKIP으로 설정하면 flashback query에 실패한 데이터가 동기화되지 않으므로 데이터 정합성에 영향을 줄 수 있다.
관련 파라미터는 REPLAY_THREAD_CNT 로, 해당 값이 올라가면 병렬 세션의 수가 많아진다. 하지만 위 로직에서 알 수 있듯이 결국 RBT 내에서 Table, Row단위로 TX Dependency가 잘 풀려야 병렬 반영이 가능하다. 이로 인해 숫자를 올린다고 반드시 올린 숫자만큼 정비례하게 증가하지 못하는 경우도 발생한다.
APPLY 프로세스에서 DML 반영 시 MAP 파라미터로 지정한 History 테이블에 반영된 history 를 남기는 기능이다.
해당 기능을 사용하기 위해서는 기존 ProSync 동기화를 진행하는 인스턴스 이외에 DML History 기능 작동을 위한 인스턴스가 추가로 하나 더 필요하다.
APPLY 프로세스의 config 파일인 [inst_id]_apply1.cfg 파일에 다음의 파라미터를 설정해야 한다.
RECORD_HISTORY
해당 인스턴스에서 DML history 기능을 사용 할 지에 대한 여부를 결정한다. (Y|N)
Y : MAP RULE 로 지정된 history 테이블에 row by row로 DML이 남게 된다.
N : MAP RULE 로 지정된 history 테이블에 row by row로 DML이 남지 않는다. (기본값)
해당 파라미터를 Y 로 설정할 경우, MAP 파라미터를 history 를 남길 테이블로 설정해 주어야 하며, DDL 파라미터의 경우 exclude all 로 설정해 주어야 한다.
추가적으로 동기화 대상 테이블에 추가적인 column들이 필요하다.
MAP Rule에서 소개한 Data Conflict Rule의 시나리오들을 정리한다. 옵션을 설정하는 방법은 해당 문서를 참고한다.
Data Conflict를 확인하려면 Row를 특정할 수 있어야 한다. ProSync에서는 이에 대한 기준을 Primary key로 두고 있다. Primary key 로 인해 충돌이 발생할 경우, Source Database, Target Database, Column Min(Max) 기준으로 데이터 Conflict에 대한 처리를 결정한다.
Insert문에서 충돌이 발생한다는 것은, 이미 데이터가 존재한다는 의미이다. 따라서 존재하는 데이터를 모두 Source Database 기준으로 맞춰주어야 한다.
Insert문을 Update로 변경하여 Conflict를 해소해준다.
Update에서의 데이터 충돌은 원하는 Row가 없다는 의미이다.
Update문을 Insert로 변경하여 Conflict를 해소해준다.
Delete에서의 데이터 충돌 또한 마찬가지로 Row가 없다는 의미가 된다.
Delete에 대한 추가적인 처리가 없이 넘어가면 된다.
Insert문의 충돌은 이미 데이터가 있을 때 발생하는데, Target Database 기준으로 맞춰야 하므로, 별도의 작업 없이 해당 처리를 건너뛴다.
Row가 없는 상황이 맞다고 판단하기 때문에 별도의 작업 없이 해당 처리를 건너뛴다.
Row가 없는 상황이 맞다고 판단하기 때문에 별도의 작업 없이 해당 처리를 건너뛴다.
위 두 경우에 대한 조합으로 볼 수 있다. 상황에 따라 Source 기준 또는 Target 기준에 맞춰 수행하는 시나리오다. 기준이 되는 것이 Database 단위가 아닌 Column 내 데이터의 대소 비교로 이루어진다는 점이 다르고, 이에 따라 충돌 처리 동작은 위의 Source / Target과 동일하게 작동한다.
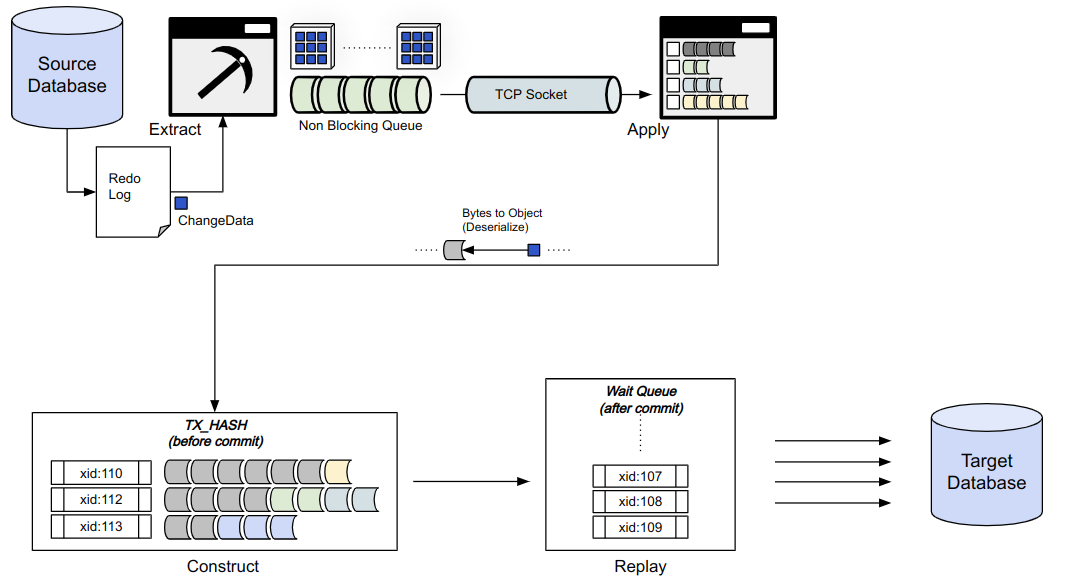
ProSync의 데이터 흐름도를 상세히 이해하고, 이를 통해 Memory 사용량 조절방식을 안내한다.
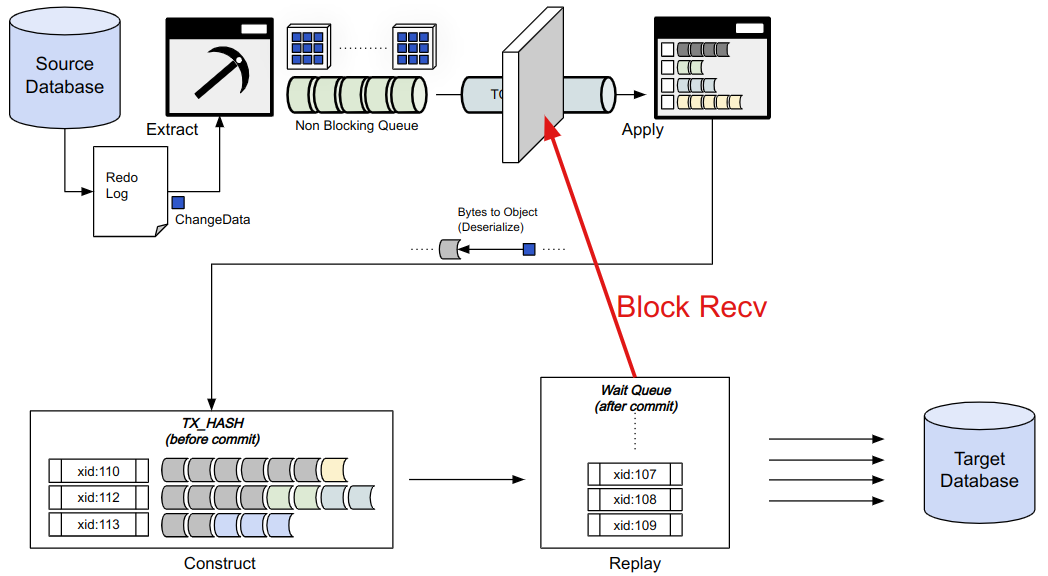
데이터가 처음 생성되는 위치는 Source DB의 Redo Log이다. Redo Log에서 발생된 데이터를 Extract 가 추출하여 Chunk 단위로 데이터를 적재한다.
적재된 데이터는 TCP Socket을 통해 전송이 된다. Non Blocking 통신이기 때문에 전체 데이터에 대한 전송이 실패하면, 이후의 데이터들은 Non Blocking Queue에 쌓이게 된다. 이 Queue에 쌓인 데이터는 커널로부터 반대쪽 TCP Recv Buffer가 비어있다는 신호가 올 때, 순서대로 다시 데이터를 보내게 된다.
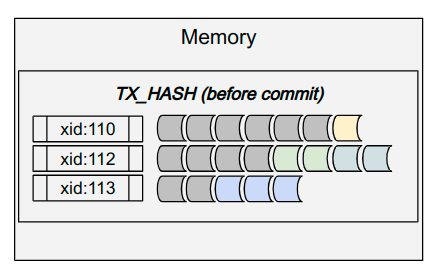
Apply는 받은 데이터를 모두 객체화 (역직렬화) 하여 TX_HASH에 쌓이게 된다. xid 는 트랜잭션 고유의 id 를 의미하며, ACID를 지켜주기 위해 트랜잭션의 커밋까진 이 위치에서 데이터를 계속 보관한다. 트랜잭션의 커밋이 들어오면 해당 트랜잭션은 Target Database에 반영이 가능한 상태로 판단하고 Replay Queue로 데이터를 넘겨준다.
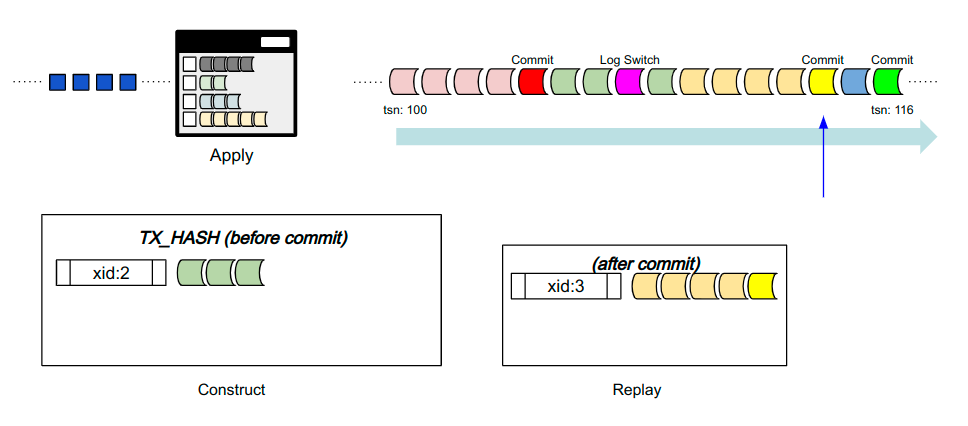
Wait Queue에 쌓인 데이터는 트랜잭션들이 커밋된 순서에 맞게 Target Database로 반영이 된다. 이 때 반영 중인 트랜잭션과 반영 대기 중인 트랜잭션이 있을 텐데, 이들간의 의존성 검사를 통하여 시간 순서에 맞고, 의존성이 없는 트랜잭션들은 병렬 처리하여 성능을 높인다.
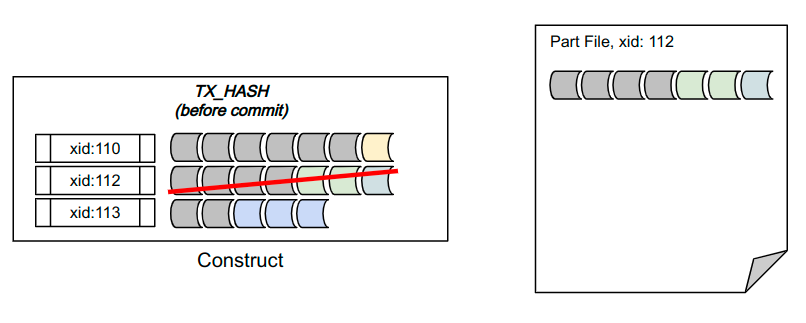
TX_HASH 에 데이터가 계속 쌓인다면 Out of Memory 를 피할 수가 없다. 따라서 특정 임계치를 넘어갈 경우 Part File이라는 이름으로 된 파일을 생성하여 이 위치로 데이터를 옮겨준다.
데이터를 옮기는 기준은 현재 TX_HASH에 있는 데이터들 중 가장 용량이 큰 트랜잭션 기준으로 파일로 내려가게 되며, 내려간 파일은 실제 반영이 되는 시점까진 계속 Disk에 남게 된다
LONG
BLOB
CLOB
Target에 동일한 이름의 Sequence가 미리 생성되어 있어야 한다.
ALTER SEQUENCE
Sequence 속성 변경(INCREMENT BY, MAXVALUE 등)은 DDL 동기화를 통해 처리된다.
대량 호출 시
빈번한 NEXTVAL 호출은 동기화 부하로 이어질 수 있으며, CACHE 옵션의 취급은 적용 환경에 따라 다르다. [Oracle to Tibero] CACHE 를 사용하면 동기화 호출 빈도를 낮출 수 있다. Target 의 CACHE 도 지원되며, 동기화 시점에만 내부적으로 조정된 뒤 원래 설정으로 복원된다. [Tibero to Tibero] CACHE 를 사용하면 호출 단위 동기화가 성립하지 않으므로 NOCACHE 로 운용한다.
Active-Active 환경 지양
Target DB 에서 SEQUENCE 의 사용을 지양한다. NEXTVAL을 통해 Target DB 에서 SEQUENCE 를 사용하게 되면 동기화 중인 SEQUENCE 의 정합성, 특히 고유성에 문제가 생길 가능성이 높다.
주의
Data Conflict Rule(DCR) 관련
Data Conflict Rule(DCR) 옵션을 사용할 경우 USE_PK_FOR_WHERE 옵션은 무시된다. 동기화의 논리 구조상 Conflict를 찾는 것이 우선이기 때문에 ProSync에선 두 옵션 간에 이와 같은 우선순위를 둔다.
IUD_TIME
TIMESTAMP 이며, DML 이 수행 되어 history 가 남은 시간을 뜻한다.
CLOB
LEADING_PRS_USER
DML history 기능에 의해서 history를 기록할 선행되는 PRS_USER를 설정하는 파라미터이다.
선행되는 인스턴스에 동기화가 이루어져야 DML history가 남게 된다. 3초씩 10번 총 30초 동안 바라보며, 그 안에 동기화가 이루어지지 않을 경우 history는 남지 않는다.
OLD_{컬럼 명}
해당 column의 경우 UPDATE, DELETE 같은 column의 값이 변경 될 때의 값이 남게 된다. 따라서 기존 컬럼과 똑같은 타입으로 설정해 주어야 한다.
HIST_NO
NUMBER 이며, 순차 채번을 위한 column이다. Target DB SYS User 에 SQ_{HISTORY_TABLE} 의 이름을 가진 sequence의 생성이 필요하다. 이 때 Sequence table 은 MIN 1 MAX 99999999 을 가지며, cycle 로 순환되어야 한다.
IUD_FLAG
VARCHAR(6) 이며, History 가 남을 DML 의 유형을 뜻하는 column이다. INSERT / UPDATE / DELETE가 남는다.
TX_HASH_SIZE 파라미터이다. TX_HASH_SIZE라는 임계치보다 더 많이 데이터가 쌓이게 될 경우 아래와 같은 동작이 수행된다고 생각하면 된다.TX_HASH_SIZE 파라미터보다 큰 경우Part File은 반영이 완료되면 제거가 되며, 반영이 되기 전까진 Disk에 남는다. 실제 트랜잭션 반영 시점에도 Part File로 내려간 DML 데이터들이 시간 상 더 앞서기 때문에, 파일에 있는 데이터를 먼저 반영한 후 메모리에 남은 트랜잭션 데이터를 반영한다.
ProSync는 ACID를 지켜주기 위해 데이터를 순서에 맞게 반영해야 한다. 즉, 앞선 트랜잭션이 반영되지 않는 경우 데이터는 반영될 수 없다는 의미이다. 따라서 Target Database에 장애가 발생하여 트랜잭션 처리가 지연된다면 그만큼 Queue에는 데이터가 쌓이게 된다.
Queue에 영구적으로 데이터가 쌓이는 것을 방지하기 위해 ProSync는 Queue 내에서 대기 혹은 반영 중인 트랜잭션들의 크기를 모두 확인한다. 이 크기가 너무 크다면 Memory 할당을 멈춰야 한다.
Memory 할당을 멈추기 위해 ProSync는 데이터가 추가적으로 생산되는 것을 막는다. 즉, Extract로부터 수신되는 데이터를 일시적으로 차단함으로써, 현재 보유 중인 데이터가 일정 수준 이상 처리될 때까지 대기 상태를 유지하도록 강제하는 방식이라고 볼 수 있다.
Extract는 앞에서 설명한 내용대로 Non Blocking Queue에 데이터를 쌓다가 실제 추출을 멈춤으로써 추가적인 데이터 생산을 멈추게 된다.
임계치에 해당하는 파라미터는 아래와 같다.
MEMORY_CTRL_STOP_SIZE Wait Queue에 이 크기 이상 만큼의 데이터가 쌓이면 Socket 으로 부터 추가적으로 들어오는 데이터를 막는다.
MEMORY_CTRL_RESUME_SIZE Wait Queue에 이 크기 이하만큼 데이터가 줄어들면, Socket 으로 부터 데이터를 다시 받는다.
그림으로 나타내면 아래와 같다.
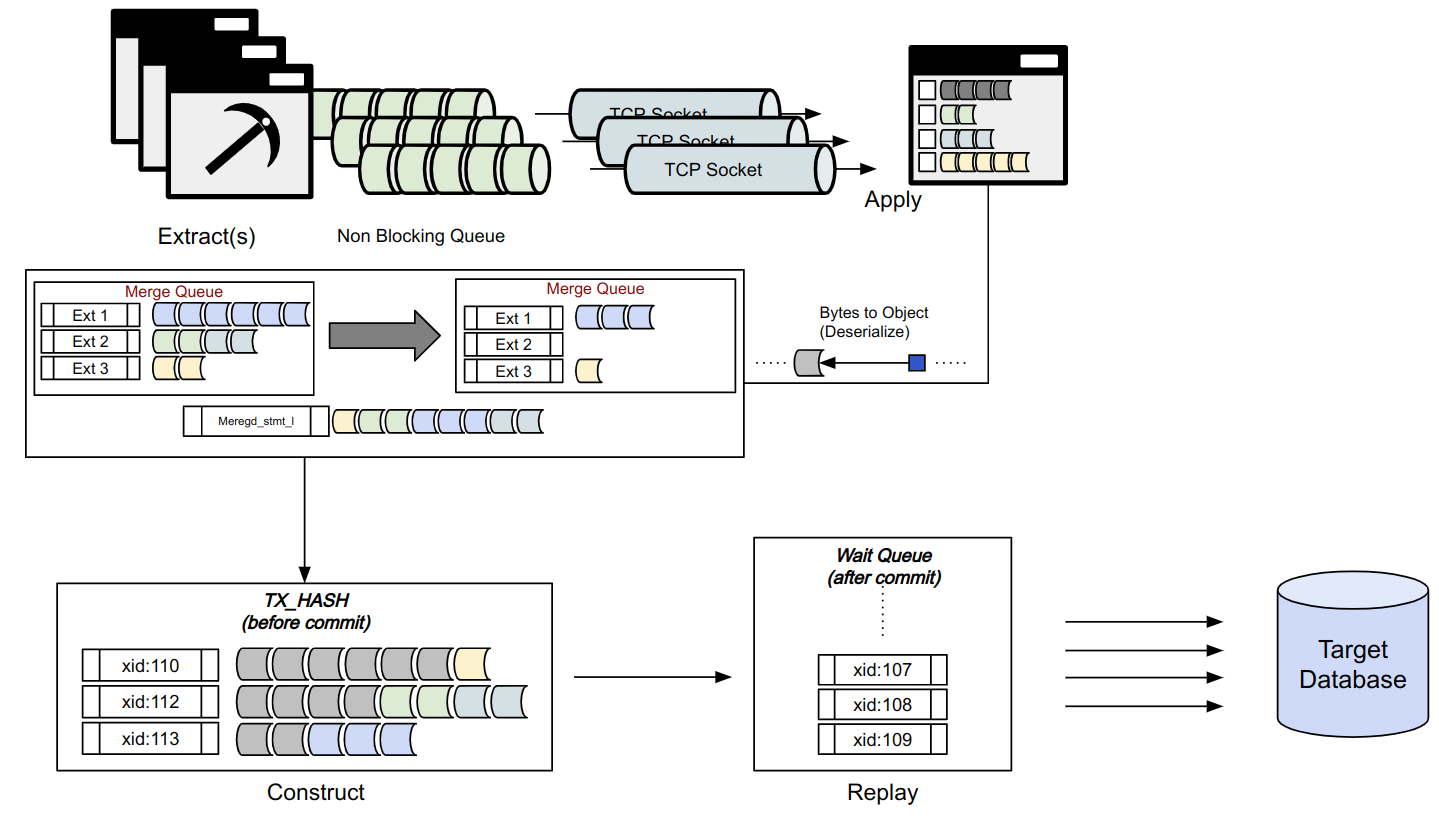
Active-Active Cluster인 RDBMS들은 Physical Disk를 공유하고 있다. 따라서 같은 공간에 서로 순서에 적합하게 데이터를 입력한다. Redo Log는 서로 다른 곳에 작성하더라도 Change Data들의 시간은 순서에 맞게 끔 작성이 된다. ProSync 입장에서 보면 서로 다른 위치에 남은 Redo Log들을 모아 직렬화를 하면 결국 DB Time 순서대로 데이터 정렬이 가능하다는 의미이다.
따라서 ProSync의 Apply 입장에선 추출이 Cluster인지 아닌지는 관심사가 아니다. 어차피 DB Time 기준으로 정렬이 가능한 데이터라면 단순히 한 줄로 세워 놓고 하나씩 쿼리로 변경해주면 된다. 다만 문제는 장애 상황이나 지연 상황에서 발생한다.
만약에 한쪽 노드에서 아무런 부하가 없거나 장애로 멈춰버리게 되면 Redo Log 작성이 멈추게 된다. 읽을 것이 없는 Extract 프로세스는 아무런 데이터를 보낼 수가 없다. 이렇게 되면 Apply 프로세스 입장에선 현재 Cluster 중 하나가 장애가 나서 못 보내고 있는 것인지, 부하가 없어서 데이터를 못 보내는 것인지 확인할 방법이 없다.
따라서 Extract 에서는 장애가 발생했다는 메시지를 TCP Socket으로 전달해주고, 부하가 없는 상황을 대비하여 ProSync용 Dummy Table에 강제로 부하를 만들어 데이터를 생산해서 전달해준다.
이 과정을 통해 Apply 프로세스는 서로 다른 Cluster Node의 데이터들을 항상 정렬할 수 있다. 하지만 정렬을 하기 위해선 정렬을 위한 공간이 필요하며, 이 위치는 아래 그림과 같다.
위와 같이 Extract가 여러 개인 상황 (Active Cluster) 에선 각 Extract 별로 데이터를 먼저 Merge Queue에 쌓아 놓는다. 쌓인 데이터가 직렬화가 되려면 모든 Extract 별 데이터가 1개라도 있어야 하기 때문에 이때까진 Merge Queue에 데이터가 쌓이게 된다.
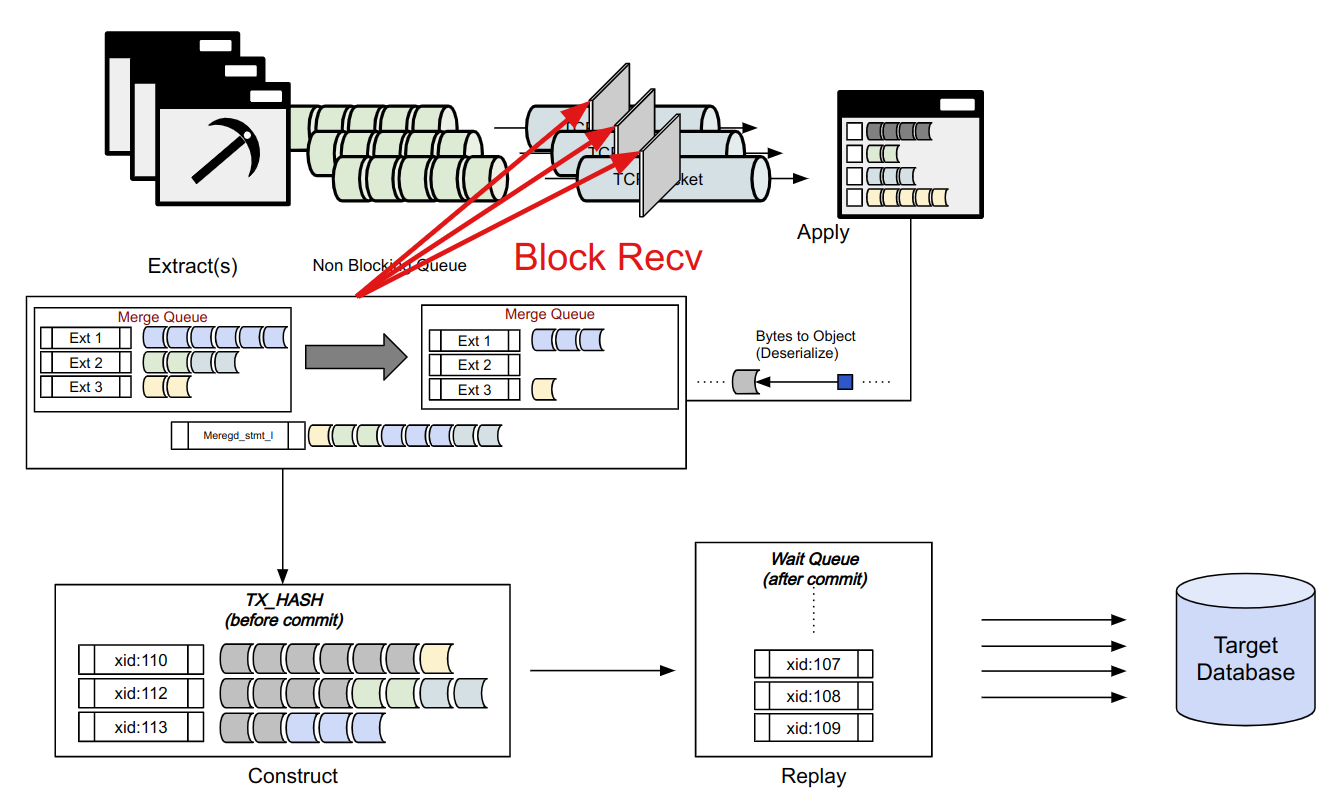
다만 네트워크 장애나 모종의 이유로 한쪽에서 데이터가 들어오는 행위가 매우 지연될 수 있기 때문에, 마찬가지로 여기서도 추가적인 데이터가 들어오지 못하게 TCP Socket으로 부터 데이터를 막는 동작이 사용된다.
여기에 사용되는 파라미터는 아래와 같다.
MERGE_BLOCK_CNT 특정 노드로부터 데이터가 이 갯수 이상만큼 쌓이면 해당 TCP Socket을 막는다.
MERGE_RESUME_CNT 특정 노드로부터 데이터가 이 갯수 보다 작다면 해당 TCP Socket을 다시 열어준다.
그림으로 보면 아래와 같다.
Extract 별로 연결이 따로 존재하므로 이와 같이 별도로 관리하게 된다.
주의
Wait Queue 관련
Replay 쪽에선 많은 자료구조를 사용한다. 반드시 Wait Queue만 사용하는 것은 아니며, 여러 종류의 Queue나 Tree 등이 사용되는데, 여기선 설명을 위해 모두 Wait Queue로 추상화하여 설명한다.
Apply 프로세스에 대하여 설명한다.
Apply 프로세스는 architecture에서도 언급했듯이 Chunk 단위로 레코드를 전달받고 해당 레코드를 트랜잭션별로 모아준다. 트랜잭션에 Commit이 오면 해당 트랜잭션은 실제 반영 단계에 들어가 대상이 되는 데이터베이스로 반영된다.
본 장에서는, 실제 apply 프로세스의 구조를 상세히 설명한다.
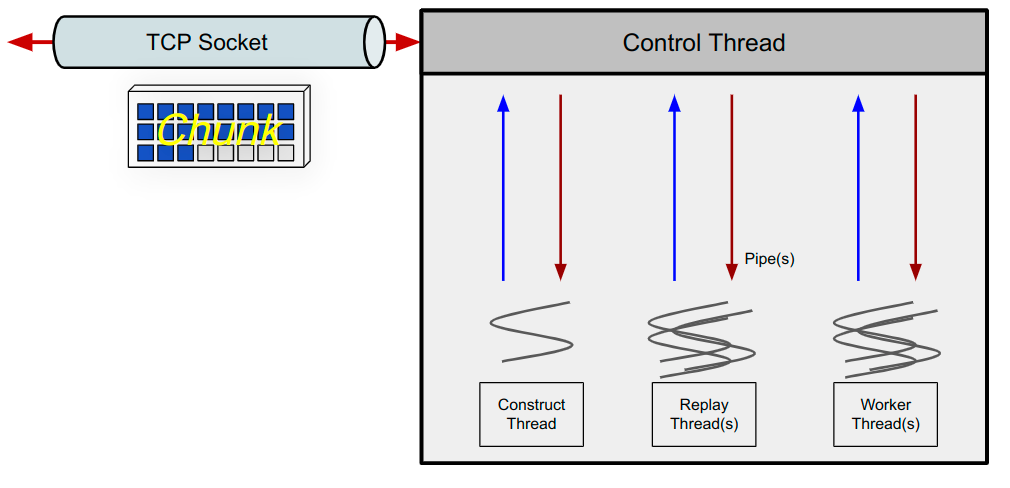
Apply 프로세스는 위와 같은 구조를 가지고 있다. 앞서 Inter Processes/Threads Communication에서 ProSync의 기본 Thread 구조를 언급한 바 있는데, Apply도 마찬가지로 Main이 되는 Control Thread가 있고 이외에 Worker Thread들이 Control Thread 하위 계층에 구성되어 있다.
동기화에 필요한 Thread는 Construct Thread와 Replay Thread로 크게 두 가지이며, 나머지는 모두 Worker Thread로 구분된다.
Control Thread는 다른 프로세스와 마찬가지로 모든 통신과 관련된 Multiplexing I/O를 담당한다. 리눅스에선 epoll을 사용하며, 플랫폼별로 k-queue나 pollset 등 각 운영체제에 알맞은 Mux I/O 기능을 사용하도록 설계되어 있다.
Construct Thread는 Chunk 로 들어오는 레코드 데이터들에 대해 트랜잭션으로 재조립한다. Construct라는 말의 의미는 트랜잭션을 다시 조립(Construct)하기 때문에 사용된다고 생각하면 된다.
각 레코드에는 본인이 속한 트랜잭션을 구분할 수 있는 일종의 key 값이 존재하는데, 이게 트랜잭션의 ID 일명 (xid)라고 불린다.
Construct는 레코드의 xid 값을 보고 트랜잭션별로 재조립한다.
Replay Thread는 Commit 레코드가 도달하여 Construct로부터 조립이 완료된 트랜잭션을 전달받는다. 전달받은 트랜잭션은 Commit 레코드의 DB Time(Oracle의 SCN / Tibero의 TSN / ..)에 맞게 직렬화되어 반영되거나, 트랜잭션 내 레코드들의 의존성을 모두 체크하여 병렬로 처리된다.
병렬로 처리하게 될 경우 Replay Thread의 개수가 많아지게 되며, 각 스레드가 DB의 한 세션을 담당하게 된다. 병렬 처리 가능 여부는 Control Thread에서 실시간으로 판단하며, 병렬 처리가 가능할 때 여러 Replay Thread에 일감을 부여하게 된다.
프로세스의 CPU / Memory 사용량을 실시간으로 수집한다. 수집된 내용은 로그상에 계속해서 남게 되며, ProSync 매니저와 연동 중일 경우, Agent 프로세스를 통해 수집한 값을 ProSync 매니저로 전송한다.
프로세스에서 발생하는 트랜잭션의 시간당 처리량, 일종의 Throughput을 계산한다. ProSync 매니저와 연동 중일 경우, Agent 프로세스를 통해 수집한 값을 ProSync 매니저로 전송한다.
Apply는 재기동이나 재연결 이후에도 중복 반영 없이 이어서 동기화할 수 있도록 복구 상태를 여러 저장소에 나누어 관리한다.
재연결 시 Apply는 저장된 이력 정보를 Ext에 전달하여(handshake) 재추출 시작점을 결정한다. Ext는 그 지점부터 다시 추출하므로 일부 레코드가 재전송될 수 있으며, Apply는 PRS_COMMITTED_TX_LIST를 통해 이미 반영이 완료된 트랜잭션을 건너뛴다.
재기동 유형별 복구 절차와 장애 시나리오는 를 참고한다.
ProSync Admin Utility가 제공하는 명령어의 사용법과 실행 방법을 안내한다.
다음은 ProSync Admin Utility 명령어를 표현하는 사용법의 예이다.
위의 예를 기준으로 ProSync Admin Utility에서 사용하는 명령어의 문법을 해석하는 방법은 다음과 같다.
Extract 프로세스에서 사용 가능한 기능에 대해 안내한다.
txh_*, txl_* 파일
$PRS_HOME/var/<instance>/tx
아직 commit이 도달하지 않은 미완료 트랜잭션의 export/import에 사용된다.
PRS_LCT
Target DB
반영 스레드가 마지막으로 반영한 TX의 정보. replay/checkpoint의 기준이 된다.
PRS_COMMITTED_TX_LIST (PRS_CTL)
Target DB
주의
Target DB를 재설치하거나 PRS_LCT 등 메타 테이블이 삭제되면 복구 기준점이 사라져 이어서 반영할 수 없다.
$PRS_HOME/var/<instance>/tx 디렉터리를 삭제하거나 유실하면 미완료 트랜잭션 정보를 복구할 수 없다.
commit이 완료된 트랜잭션 목록. 재전송된 트랜잭션의 중복 반영 여부 판정에 사용된다.
중괄호({ })에 포함된 내용은 반드시 입력해야 명령어를 실행할 수 있다.
위의 예에서 choice1과 choice2는 중괄호({ }) 내에 있고 버티컬 바(|)로 분리되어 있으므로 둘 중 하나는 명령 프롬프트에 포함되어야 한다.
버티컬 바(|)
버티컬 바(|)로 분리된 내용은 그 중 하나를 선택한다.
애스터리스크(*)
애스터리스크(*)로 표시된 내용은 포함되지 않을 수도 있고, 여러 번 포함될 수도 있다. 위의 예에서 arg는 대괄호([ ]) 바로 뒤에 애스터리스크(*)가 있으므로 포함되지 않을 수도 있고, 한 번 이상 포함될 수도 있다.
대소문자
명령어는 대소문자를 구분하지 않는다.
ProSync Admin Utility에서 사용할 수 있는 명령어는 다음과 같다.
운영체제의 명령어를 실행한다.
스크립트를 실행한다.
COM[MAND] param {choice1|choice2} [option] [arg]*대괄호([ ])
대괄호([ ])에 포함된 내용은 입력하지 않아도 명령어를 실행할 수 있다.
위의 예에서 COMMAND 명령어의 뒷부분(MAND)과 option, arg는 명령 프롬프트에 포함되지 않을 수 있다.
중괄호({ })
Source Oracle이 ASM(Automatic Storage Management)을 사용하는 환경에서 Redo Log와 Archive Log를 추출하는 구성과 운영 방법을 안내한다.
ProSync는 Source Oracle이 ASM(Automatic Storage Management)을 사용하는 환경에서 ASM Diskgroup에 저장된 Redo Log와 Archive Log를 추출할 수 있다.
ASM Diskgroup의 파일은 운영체제 파일 시스템에 그대로 노출되지 않으므로 일반적인 파일 읽기로는 접근할 수 없다. Extract 프로세스는 ASM 인스턴스에 직접 접속하여 Diskgroup 경로(+로 시작하는 경로)의 로그 파일을 읽는다.
Source DB
Extract 프로세스는 읽으려는 로그 파일의 경로를 보고 읽기 경로를 결정한다.
경로에 따라 읽기 경로가 결정되므로 Redo Log와 Archive Log 중 일부만 ASM Diskgroup에 저장된 혼합 구성에서도 사용할 수 있다. ASM 사용 여부를 지정하는 별도의 파라미터는 없으며, ASM 접속 정보를 설정하면 ASM 경로의 파일에 대해 ASM 읽기가 사용된다.
ASM 경로의 로그를 읽을 때 Extract 프로세스는 ASM 인스턴스에 ASM_IO_WORKERS 개수만큼 병렬 I/O Worker 세션을 만든다. 각 Worker는 로그 파일 읽기만 수행하고, 읽어온 Redo의 분석은 로그 리더가 별도로 수행한다.
ASM_IO_WORKERS는 Extract 프로세스 기동 시에만 반영되므로, 값을 변경한 경우 Extract 프로세스를 재기동해야 한다.
Extract 프로세스가 ASM 인스턴스에 접속할 별칭을 tnsnames.ora에 등록한다. 이 별칭을 ASM_DB_NAME에 설정한다.
ASM 접속 계정은 ASM 인스턴스에 접속하여 Diskgroup의 파일을 읽을 수 있어야 하므로 SYSASM 권한을 가진 계정을 사용한다.
등록한 별칭으로 접속이 되는지 확인한다.
Redo Log와 Archive Log가 ASM Diskgroup에 저장되어 있는지 확인한다. 경로가 +로 시작하면 ASM 로그 추출 설정이 필요하다.
ASM_PWD=#encrypted는 암호화된 문자열 자체가 아니라, 실제 비밀번호를 wallet 파일에서 읽으라는 표시(sentinel)이다. 따라서 config 파일만 다른 노드로 복사해서는 프로세스를 기동할 수 없으며 wallet 파일(var/<instance>/.wallet_asm)을 함께 이관해야 한다.
설치 config 파일에 ASM 접속 정보를 설정하면 설치 과정에서 ASM 구성이 반영된다.
ASM 접속 정보를 설정하고 설치하면 다음이 수행된다.
ASM_PWD 암호화 및 wallet 파일 저장
생성되는 Extract config에 ASM 파라미터 자동 기입
설치 후 생성된 Extract config에 다음 값이 기입되어 있는지 확인한다.
Extract 프로세스는 활성 Online Redo Log의 경로가 ASM Diskgroup 경로인 경우 ASM 인스턴스 접속을 통해 해당 파일을 읽는다. 읽기는 I/O Worker 세션이 병렬로 수행하고, 로그 리더는 읽어온 블록의 Redo를 분석하여 LCR을 생성한다.
Archive Log는 다음 순서로 위치를 결정한다.
ARCHIVE_LOG_DIR이 설정된 경우 해당 디렉터리에서 Archive Log 파일을 먼저 찾는다.
해당 디렉터리에서 찾지 못하거나 ARCHIVE_LOG_DIR이 설정되지 않은 경우 V$ARCHIVED_LOG 조회 결과의 ASM 경로(+DISKGROUP/...)로 접근한다.
ARCHIVE_LOG_DIR은 절대 경로의 디렉터리만 유효한 값이다. 따라서 log_archive_dest가 FRA(USE_DB_RECOVERY_FILE_DEST)이거나 ASM Diskgroup(+...)인 표준 ASM 구성에서는 설치 과정에서 ARCHIVE_LOG_DIR에 값이 기입되지 않으며, Archive Log 위치는 위의 순서에 따라 운영 중에 결정된다.
ASM_PWD는 암호화되어 인스턴스의 wallet 파일(var/<instance>/.wallet_asm)에 저장된다. wallet 파일은 백업 대상에 포함해야 하며, ASM 접속 계정의 비밀번호를 변경한 경우 wallet을 다시 생성해야 한다.
ASM 로그 추출은 Source Oracle 전용이다.
ASM_IO_WORKERS는 Extract 프로세스 기동 시에만 적용된다. 운영 중 변경하려면 프로세스를 재기동해야 한다.
ASM_IO_WORKERS는 최대 8까지 설정할 수 있다.
ProSync가 동기화 과정 속에 DML을 Target DB에 반영 중 에러가 발생할 수 있다. 일반적인 경우에는 ProSync가 해당 DML에 대한 반영을 성공할 때 까지 재시도하게 된다.
해당 기능을 사용하면 특정한 에러에 대해 재시도하는 대신 해당 DML에 대한 반영을 생략하고 이후의 동기화를 진행하도록 설정할 수 있다.
또한 DISCARD 기능이 발생한 이력을 기록하는 Discard file 을 작성할 수 있다.
해당 기능을 사용하기 위해선 config 파일에 다음과 같은 Parameter를 설정해야 한다.
현재 버퍼 내의 명령문을 실행한다.
ProSync의 동기화 대상 테이블을 추가/제거 하거나 파라미터 값을 변경한다.
ProSync Admin Utility를 정지한다.
도움말을 출력한다.
사용자가 입력한 INST_ID에 속한 Extract 프로세스의 작업을 멈춘다.
사용자가 입력한 INST_ID에 속한 Extract 프로세스의 작업을 재개한다.
ProSync Admin Utility의 시스템 변수를 설정한다.
ProSync Admin Utility의 시스템 변수 및 각 프로세스의 파라미터를 출력한다.
사용자가 입력한 INST_ID의 프로세스 혹은 매니저 프로세스를 정지한다.
사용자가 입력한 INST_ID의 프로세스 혹은 매니저 프로세스를 실행한다.
전체 프로세스, 사용자가 입력한 INST_ID의 프로세스 혹은 매니저 프로세스의 상태를 확인하는 명령어이다.
Instance의 apply 프로세스가 Target DB에 반영 중인 Query의 정보를 출력한다.
프로세스의 메모리 할당 현황을 파일로 출력한다.
Apply 프로세스의 내부 상태(DD/MERGE/DEPENDENCY/QUEUE)를 파일로 출력한다.
프로세스 상태 스냅샷 dump를 생성하거나 비교 분석한다.
ASM_IO_WORKERS
ASM Redo를 읽을 때 사용할 병렬 I/O Worker 세션 수를 설정한다. 기본값은 4이며 1 ~ 8 범위로 설정할 수 있다. Extract 프로세스 기동 시에만 적용된다. (적용: Extract)
Oracle (ASM 구성)
대상 프로세스
Extract
추출 대상 로그
Online Redo Log, Archive Log
+로 시작하는 ASM Diskgroup 경로
ASM 인스턴스 접속(ASM_DB_NAME)을 통해 읽는다.
절대 경로의 파일 시스템 경로
파일 시스템에서 직접 읽는다.
ASM_DB_NAME
로그 리더가 사용할 Oracle ASM 인스턴스의 별칭(Alias)을 설정한다. ASM 경로(+...)의 Redo Log 및 Archive Log 접근에 필요하다. (적용: Extract)
ASM_USER
로그 리더가 사용할 Oracle ASM 접속 계정을 설정한다. (적용: Extract)
ASM_PWD
주의
ASM 구성에서 ARCHIVE_LOG_DIR에 ASM Diskgroup 경로나 USE_DB_RECOVERY_FILE_DEST와 같은 값을 직접 기입하면 Extract 프로세스 기동이 실패하거나 Archive Log 추출이 진행되지 않을 수 있다. 파일 시스템 경로에 별도의 Archive Log가 있는 구성이 아니라면 ARCHIVE_LOG_DIR을 비워 둔다.
ASM_USER의 비밀번호를 설정한다. 암호화되어 wallet에 저장되며, config 파일에는 #encrypted로 표시된다. (적용: Extract)
+ASM =
  (DESCRIPTION =
    (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.0.10)(PORT = 1521))
    (CONNECT_DATA =
      (SERVICE_NAME = +ASM)
      (INSTANCE_NAME = +ASM1)
      (UR = A)
    )
)$ sqlplus asm_user/asm_password@+ASM as sysasm
SQL> SELECT INSTANCE_NAME, STATUS FROM V$INSTANCE;
SQL> SELECT NAME, STATE FROM V$ASM_DISKGROUP;SELECT MEMBER FROM V$LOGFILE;
SHOW PARAMETER log_archive_dest
SHOW PARAMETER db_recovery_file_destSRC_DB_TYPE=ORACLE
SRC_DB_NAME=src_oracle
ASM_DB_NAME=+ASM
ASM_USER=sys
ASM_PWD=#encrypted
ASM_IO_WORKERS=4SRC_DB_TYPE=ORACLE
SRC_DB_NAME=src_oracle
SRC_INSTALL_USER=sys
SRC_INSTALL_PWD=oracle
# (for Oracle ASM only)
ASM_DB_NAME=+ASM
ASM_USER=sys
ASM_PWD=asm_passwordASM_DB_NAME=+ASM
ASM_USER=sys
ASM_PWD=#encryptedDISCARD_EC
재시도를 하지 않고 건너뛰고자 하는 에러코드를 입력한다.
유형: 에러코드
범위: 최대 256개
기본값:
DISCARD_FILE_YN
DISCARD 동작이 발생했을 때 해당 내용을 discard 파일에 남기는 기능을 활성화 하는 파라미터이다.
유형: Y/N, dynamic
범위: Y/N
기본값: N
DISCARD_FILE_DIR
discard file의 저장 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: (LOG_DIR과 같은 디렉토리)
DISCARD_FILE_SIZE
discard 파일의 최대 크기를 지정하는 파라미터.
유형: int32, dynamic
범위: 1M - 1G
기본값: 100M
DISCARD_BACKUP_DIR
discard 파일의 크기가 설정한 최대 크기를 초과하게 되면 생성하는 백업파일의 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: (LOG_BACKUP_DIR과 같은 디렉토리)
DISCARD_BACKUP_SIZE
backup 디렉토리의 최대 크기를 지정하는 파라미터.
유형: uint64, dynamic
범위: 0 - 128G
기본값: 0(무제한)
ProSync가 Source DB의 값을 Target DB의 데이터 타입으로 변환하지 못하면(지원하지 않는 timestamp 지역 정보 등) 해당 DML은 반영에 실패하고, 일반적인 경우에는 성공할 때까지 재시도하게 된다.
DISCARD_CAST_ERR=Y로 설정하면 변환에 실패한 DML을 재시도하지 않고 건너뛴 뒤 이후의 동기화를 진행한다. 건너뛴 DML은 Target DB에 반영되지 않는다.
DISCARD_CAST_ERR
데이터 변환에 실패한 DML을 재시도하지 않고 건너뛸지 여부를 설정한다. DISCARD_YN, DISCARD_EC 설정과 무관하게 동작한다.
유형: Y/N
범위: Y/N
기본값: N
DDL도 DML과 마찬가지로 Target DB에 반영 중 에러가 발생할 수 있다. 일반적인 경우에는 ProSync가 해당 DDL에 대한 반영을 성공할 때 까지 재시도하게 된다.
해당 기능을 사용하면 재시도하는 대신 해당 DDL에 대한 반영을 생략하고 이후의 동기화를 진행하도록 설정할 수 있다.
또한 DISCARD 기능이 발생한 이력을 기록하는 Discard file 을 작성할 수 있다.
해당 기능을 사용하기 위해선 config 파일에 다음과 같은 Parameter를 설정해야 한다.
DISCARD_DDL_YN
동기화 중 에러가 발생하는 경우에 스킵할지 여부를 설정한다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_DDL_FILE_YN
DISCARD 동작이 발생했을 때 해당 내용을 discard 파일에 남기는 기능을 활성화 하는 파라미터이다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_DDL_FILE_DIR
DISCARD_YN=[Y|N]
DISCARD_EC=2 10007 8033
DISCARD_FILE_YN=[Y|N]

DISCARD_FILE_DIR=/directory/to/save/file
DISCARD_FILE_SIZE=200M
DISCARD_BACKUP_DIR=/directory/to/save/backup/file
DISCARD_BACKUP_SIZE=10G
DISCARD_YN
동기화 중 에러가 발생하는 경우에 스킵할지 여부를 설정한다. Y 상태에선 발생한 에러가 DISCARD_EC 에 작성된 에러코드에 속해있는 경우 재시도를 생략한다.
유형: Y/N
범위: Y/N
기본값: N
DISCARD_CAST_ERR=[Y|N]
DISCARD_FILE_YN=[Y|N]DISCARD_DDL_YN=[Y|N]
DISCARD_DDL_FILE_YN=[Y|N]
DISCARD_DDL_FILE_DIR=/directory/to/save/file
DISCARD_DDL_FILE_SIZE=200M
DISCARD_DDL_BACKUP_DIR=/directory/to/save/backup/file
DISCARD_DDL_BACKUP_SIZE=10G주의
DISCARD 기능을 활성화하면 batch apply 기능이 사용 불가능하다.
DML을 반영할 때 발생하는 에러에 대해서 만 DISCARD 기능을 지원한다.
주의
건너뛴 DML은 Apply 로그에 skip insert stmt because of cast error.(xid: <xid>) 형태의 경고로 남는다. UPDATE, DELETE도 같은 형식으로 남는다.
DISCARD_FILE_YN=Y
주의
단, TABLE 관련 DDL은 해당 기능을 사용하더라도 실패하는 경우 생략할 수 없다.
(12032)Deadlock detected. 에러는 DISCARD 기능을 지원하지 않는다.
SAM_BIND_VALUE=Y 를 사용하면, discard log에 실패한 query의 value 값이 함께 저장된다.
cast error discardeddiscard file의 저장 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: $PRS_HOME/var/<인스턴스명>/ddl_err
DISCARD_DDL_FILE_SIZE
discard 파일의 최대 크기를 지정하는 파라미터.
유형: int32
범위: 1M - 1G
기본값: 100M
DISCARD_DDL_BACKUP_DIR
discard 파일의 크기가 설정한 최대 크기를 초과하게 되면 생성하는 백업파일의 위치를 지정하는 파라미터.
유형: 디렉토리
범위: -
기본값: $PRS_HOME/var/<인스턴스명>/ddl_err/backup
DISCARD_DDL_BACKUP_SIZE
backup 디렉토리의 최대 크기를 지정하는 파라미터.
유형: uint64
범위: 0 - 128G
기본값: 0
테이블, 컬럼 매핑 기능을 사용하기 위한 MAP 파라미터 설정 방법을 설명한다.
테이블, 컬럼 매핑 기능을 사용하기 위해서는 $PRS_HOME/config 디렉터리의 Apply config file인 '[INST_ID]_apply1.cfg'를 설정한다.
다음은 설정해야 할 파라미터에 대한 설명이다.
기본 MAP 파라미터에 Source DB의 특정 테이블을 Target DB의 특정 테이블로 동기화하기 위한 규칙을 설정한다.
MAP=([SYNC OPTION] SOURCE_USER.SOURCE_TABLE [SOURCE_COLUMNS]
     [COLUMN FILTERING OPTION],
     [TARGET_DATABASE.]TARGET_USER.TARGET_TABLE [TARGET_COLUMNS]
[RESOLVE OPTION] [SKIP OPTION])SYNC OPTION
다음은 MAP 파라미터를 이용해서 동기화 대상 반영 기능을 사용하는 방법에 대한 예제이다.
다음은 Source DB의 PROSYNC1 사용자의 T1 테이블을 Target DB의 PROSYNC2 사용자의 T2 테이블로 동기화하는 예제이다.
다음은 Source DB의 PROSYNC1 사용자의 T1 테이블에 컬럼 C1, C2, C3가 있고, 이중 C1와 C2 컬럼만 Target DB의 PROSYNC2 사용자의 T2 테이블의 C1, C2 컬럼과 동기화하는 예제이다.
다음은 Source DB의 PROSYNC1 사용자의 T1 테이블에 컬럼 C1, C2, C3가 있고, 이중 C1와 C2 컬럼만 Target DB의 PROSYNC2 사용자의 T2 테이블의 D1, D2 컬럼과 동기화하는 예제이다.
동기화 테이블 사용여부를 설정한다.
동기화 테이블을 지정하는 경우 SYNC OPTION에 TABLE을 설정한다.
동기화 대상이 아닌 오브젝트의 DDL 매핑을 지정하는 경우 SYNC OPTION에 OBJECT를 설정한다.
동기화 대상 테이블에 대해서는 앞서 설명한 TABLE 규칙을 따라 DDL 매핑이 지원되며, TABLE 규칙이 명시되지 않은 경우 매핑 없이 동기화된다. 동기화 대상으로 설정할 수 없는 INDEX 등의 OBJECT나 동기화 대상이 아닌 테이블에 대해서만 해당 규칙으로 설정할 수 있다. OBJECT 규칙에 대해서는 반드시 위의 형태로만 사용 가능하다. OBJECT_NAME에 와일드 카드로 '%'를 입력할 수 있다. 이 경우 [SOURCE_USER]의 임의의 OBJECT [SOURCE_USER].[OBJECT_NAME]을 [TARGET_USER].[OBJECT_NAME]에 DDL 매핑하여 DDL을 동기화한다.
동기화를 제외할 테이블을 지정하는 경우 SYNC OPTION에 EXCLUDE를 설정한다.
Source DB의 PROSYNC 사용자의 TMP_TBL 테이블을 제외하고 동기화 할 때 다음과 같이 '[INST_ID]_apply1.cfg'의 MAP 파라미터를 설정한다.
COLUMN FILTERING OPTION을 사용하여 일부 컬럼에 대한 동기화를 제거할 수 있다. 다만 Constraint가 걸려있는 컬럼에 대해서는 해당 옵션을 사용할 수 없다.
다음과 같이 COLUMN FILTERING OPTION을 사용할 수 있다.
Source DB의 PROSYNC1 사용자의 T1 테이블에 컬럼 C1, C2, C3가 있고, 이중 C1 컬럼만 제외하고 Target DB의 PROSYNC2 사용자의 T2 테이블의 C2, C3 컬럼과 동기화할 경우 다음과 같이 '[INST_ID]_apply1.cfg'의 MAP 파라미터를 설정한다.
동기화 시 충돌 상황에서 Source DB에 정합성 기준을 맞출 지, Target DB에 정합성 기준을 맞출 지, 아니면 특정 컬럼의 Min 혹은 Max 값 기준으로 데이터 정합성을 맞출 지를 결정하는 옵션이다. 필수 옵션은 아니며 주로 양방향 동기화에 사용된다.
정해진 Rule에 따라 DML 들이 변경되거나 생략 된다.
다음은 RESOLVE OPTION에 설정할 수 있는 RESOLVE_RULE의 종류이다.
MAX와 MIN RESOLVE_RULE의 경우에는 반드시 DEFAULT OPTION을 설정해야 한다. 컬럼 값이 null인 경우에 설정한 DEFAULT 값으로 비교한다. 단, 동기화는 설정한 DEFAULT 값이 아니라 실제 컬럼 값으로 수행한다.
UPDATE을 동기화하는 경우 MIN, MAX Rule을 사용한다면 비교 대상 컬럼의 변경 유무에 따라 다르게 비교를 수행한다. 비교 대상 컬럼이 변경되었다면 변경된 값, 변경되지 않았다면 기존 값으로 Target DB의 row와 비교를 진행한다. 비교 대상 컬럼이 NULL인 상태에서 UPDATE가 발생하는 경우 비교가 불가능하기 때문에 비교 없이 Source DB 값을 우선으로 DML을 수행한다.
예를 들어 DB1과 DB2간의 양방향 동기화하는 경우 DB1의 PROSYNC 사용자의 T1 테이블을 DB2의 PROSYNC 사용자의 T1 테이블로 동기화하고, column c3의 값이 더 큰 값을 우선하고자 하는 경우 마지막으로 INSERT할 때 DCR 컬럼인 c3에 null이 들어가는 경우 10으로 비교할 경우 다음과 같이 설정한다.
SKIP OPTION에는 동기화하지 않길 원하는 row들을 특정하기 위한 조건을 설정한다.
SKIP OPTION은 다음과 같이 설정한다. SKIP_CONDITION이 True인 Row들은 동기화하지 않는다.
Source DB의 PROSYNC 사용자의 T1 테이블을 Target DB의 PROSYNC 사용자의 T1 테이블로 동기화하고, column c1의 값이 'example'이 아니면 DML을 skip할 경우 다음과 같이 MAP 파라미터를 설정한다.
위의 조건에 추가로 Source DB의 PROSYNC 사용자의 T2 테이블을 Target DB의 PROSYNC 사용자의 T2 테이블로 동기화하고, column c2의 값이 'example2'이면 DML을 skip할 경우 다음과 같이 MAP 파라미터를 설정한다.
MIN(COLUMN_NAME)
해당 컬럼의 값이 더 작은 Row를 우선으로 한다.
반드시 DEFAULT OPTION을 설정해야 한다.
TABLE : 동기화 할 테이블을 지정하는 경우 설정한다. OBJECT : 동기화 대상이 아닌 오브젝트의 DDL 매핑을 지정하는 경우 설정한다. EXCLUDE : 동기화를 제외할 테이블을 지정하는 경우 설정한다.
SOURCE_USER
동기화 할 Source DB 테이블의 사용자 이름을 설정한다.
SOURCE_TABLE
동기화 할 Source DB 테이블의 테이블 이름을 설정한다.
SOURCE_COLUMNS
동기화 할 Source DB 테이블의 컬럼들을 설정한다. (Column1, Column2, Column3)과 같은 방식으로 설정한다.
COLUMN FILTERING OPTION
동기화하지 않을 Source DB 테이블의 컬럼들을 설정한다.
TARGET_DATABASE
동기화시킬 Target DB의 데이터베이스 이름을 설정한다.
TARGET_USER
동기화시킬 Target DB 테이블의 사용자 이름을 설정한다.
TARGET_TABLE
동기화시킬 Target DB 테이블의 테이블 이름을 설정한다. 인자에 대한 자세한 내용은 각 절의 설명을 참고한다.
RESOLVE OPTION
충돌(Conflict) 발생 시 적용할 RESOLVE 동작(DCR Rule)을 설정한다. RESOLVE BY 구문으로 SOURCE, TARGET, MAX(컬럼), MIN(컬럼) 중 하나를 지정한다. 인자에 대한 자세한 내용은 각 절의 설명을 참고한다.
SKIP OPTION
동기화 할 때 동기화를 하지 않을 row의 조건을 설정한다.
TARGET_COLUMNS
동기화시킬 Target DB 테이블의 컬럼들을 설정한다. SOURCE_COLUMNS와 순서대로 매핑되고 컬럼 개수는 일치해야 한다. (Column1, Column2, Column3)과 같은 방식으로 설정한다.
MAP=(TABLE PROSYNC1.T1, PROSYNC2.T2)MAP=(TABLE PROSYNC1.T1(C1, C2), PROSYNC2.T2)MAP=(TABLE PROSYNC1.T1(C1, C2), PROSYNC2.T2(D1, D2))MAP=(TABLE [SOURCE_USER].[SOURCE_TABLE]... )MAP=(OBJECT [SOURCE_USER].[OBJECT_NAME], [TARGET_USER].[OBJECT_NAME])MAP=(EXCLUDE [SOURCE_USER].[SOURCE_TABLE]...)MAP=(TABLE DEFAULT EXCLUDE PROSYNC.TMP_TBL)MAP=(... EXCEPT FOR ([COLUMN_NAME], ..., [COLUMN_NAME])...)MAP=(TABLE PROSYNC1.T1 EXCEPT FOR (C1), PROSYNC2.T2)MAP=(... RESOLVE BY [RESOLVE_RULE] ...)SOURCE
Source 테이블의 Row를 우선으로 한다.
TARGET
Target 테이블의 Row를 우선으로 한다.
MAX(COLUMN_NAME)
MAP=(... RESOLVE BY MAX(COLUMN_NAME) DEFAULT (COLUMN_VALUE) ...)MAP=(TABLE PROSYNC.T1, PROSYNC.T1 RESOLVE BY MAX(c3) DEFAULT (10))TIBERO
CHAR, VARCHAR, NUMBER, TIME, DATE, TIMESTAMP
ORACLE
CHAR, VARCHAR, NUMBER
POSTGRESQL
CHAR, VARCHAR
EQUAL (=), NOT_EQUAL (!=)
NUMBER, TIME, DATE, TIMESTAMP
EQUAL (=), NOT_EQUAL (!=), INEQUALITY (<, <=, >, >=)
MAP=(... SKIP=(SKIP_CONDITION))MAP=(TABLE PROSYNC.T1, PROSYNC.T1 SKIP=(c1!="example"))MAP=(TABLE PROSYNC.T1, PROSYNC.T1 SKIP=(c1!="example")
TABLE PROSYNC.T2, PROSYNC.T2 SKIP=(c2="example2"))주의
다음 키워드는 MAP Rule 의 예약어이므로 table 등 대상을 명시하는 용도로 사용 불가하다.
"ALL" "BY" "DEFAULT" "EXCEPT FOR" "EXCLUDE" "FILTER" "INCLUDE" "MAX" "MIN" "RESOLVE" "SOURCE" "SKIP" "SYNC" "TABLE" "TARGET" "TYPE" "OBJECT" "INSERT" "DELETE" "UPDATE"
주의
DB 버전, 비표준 쿼리 등으로 인해 DDL의 OBJECT의 인식이 불가능할 수 있다. 따라서 MAP 파라미터를 사용해서 DDL 매핑을 할 때 TABLE과 OBJECT에 schema를 명시하는 것을 권장한다.
또한, 동기화 테이블 T1에 대해 DROP TABLE T1 실행 후 CREATE TABLE T1를 실행할 때 T1은 OBJECT로써 매핑될 것이고, 생성될 컬럼은 동기화 테이블 컬럼 MAP 파라미터에 영향을 받지 않는다.
해당 컬럼의 값이 더 큰 Row를 우선으로 한다.
반드시 DEFAULT OPTION을 설정해야 한다.
CHAR, VARCHAR, NUMBER
Tibero Standby Cluster(TSC) 환경에서 Standby DB를 Source로 하는 동기화 구성과 운영 방법을 안내한다.
ProSync는 Tibero Standby Cluster(이하 TSC) 환경에서 Standby DB를 Source로 하는 동기화를 지원한다.
TSC 환경에서 Extract 프로세스와 Llob 프로세스는 Redo Log 읽기와 Flashback 조회를 Standby DB에서 수행하고, Source DB에 쓰기가 필요한 메타데이터 작업은 쓰기 가능한 Primary DB로 라우팅한다. Failover로 Standby DB가 Primary로 승격되면 쓰기 라우팅을 승격된 DB로 자동 전환한다.
Standby DB에서 추출을 수행하므로 운영 중인 Primary DB의 부하를 줄일 수 있고, Source DB의 장애 전환 이후에도 재설치 없이 동기화를 이어갈 수 있다.
ProSync는 동기화 과정 중에 전달하는 세그먼트를 파일에 순차적으로 기록할 수 있다. APPLY 프로세스에서 Target DB에 반영하는 STATEMENT 를 파일에 저장할 수 있는데, 이를 SAM 기능이라고 한다.
다음은 SAM 기능을 지원하는 데이터 타입이다.
MAP=(
  TABLE TIBERO.TEST_DUMMY, TIBERO.TEST_DUMMY SKIP=(C3 = "ch", C3 = "ch1")
)
대상 프로세스
Extract, Llob
TSC Standby 동기화에서 각 접속 별칭(Alias)의 역할은 다음과 같다.
SRC_DB_NAME
Standby 별칭. Redo Log 읽기, Llob Flashback 조회, 복구 상태 조회에 사용한다.
SRC_LOCAL_SID
Standby 인스턴스 직결 별칭. Archive Log 정보 조회와 TAC-TSC의 인스턴스 판별에 사용한다.
SRC_PRIMARY_DB_NAME
정상 TSC 상태와 Failover 이후의 작업별 라우팅은 다음과 같다.
Redo Log 읽기
SRC_DB_NAME
SRC_DB_NAME
Llob Flashback 조회
SRC_DB_NAME
TAC-TSC 환경에서는 Primary TAC의 Redo Thread 수만큼 Extract 프로세스를 기동한다. 이때 별칭은 다음과 같이 배치한다.
모든 Extract 프로세스와 Llob 프로세스의 SRC_DB_NAME은 같은 Standby 별칭을 사용한다.
Extract 프로세스별 SRC_LOCAL_SID는 해당 Redo Thread의 로그를 기록하는 Standby 인스턴스로 직접 접속하는 별칭으로 설정한다. Extract 프로세스는 이 접속에서 인스턴스 번호를 조회하여 활성 Standby Log를 읽을 접속 지점을 결정하므로, 이 별칭이 다른 인스턴스를 가리키면 활성 Standby Log의 변경분을 읽지 못한다.
Extract 프로세스별 SRC_PRIMARY_LOCAL_SID는 해당 Redo Thread를 소유한 Primary 인스턴스로 직접 접속하는 별칭으로 설정한다.
TSC 환경을 Source로 사용하는 경우 ProSync용 TIP 파일 설정은 Primary DB와 Standby DB 모두(TAC-TSC는 모든 노드)에 적용되어 있어야 한다. Failover 이후에는 승격된 Standby DB가 Redo를 생성하는 추출 소스가 되기 때문이다. 설정 항목은 데이터베이스 설정 페이지를 참고한다.
Standby DB는 read-only 모드로 open되어 있어야 한다. read-only 모드가 아니면 접속이 거부된다.
RECOVERY 모드로 운영 중인 Standby DB는 다음 명령으로 복구를 중단하지 않고 read-only 세션을 허용하도록 전환할 수 있다.
Standby 별칭으로 접속하여 역할을 확인한다. 정상 TSC 상태의 기대값은 STANDBY이다.
Primary 별칭으로 접속하여 역할이 PRIMARY인지 함께 확인한다.
ProSync Source 계정은 TSC 역할과 Standby 복구 상태를 조회할 수 있어야 한다.
TAC-TSC 환경에서는 GV$INSTANCE, GV$PARAMETERS 조회 권한도 필요하다. 두 뷰는 활성 Standby Log를 읽을 인스턴스별 접속 지점을 결정하는 데 사용한다. 권한이 없으면 기동 시 역할 검증, Failover 감지, 복구 상태 대기 등이 실패하거나 재시도 상태에 머무를 수 있다.
PRS_OBJ_LIST, PRS_TXINFO 등 ProSync가 Source DB에 생성하는 메타데이터 객체는 쓰기 가능한 Primary DB에 생성되어 있어야 한다. 설치 구성에서 USE_TSC=Y를 설정하면 설치 과정의 Source DB 측 객체 생성 작업이 Primary에서 수행된다.
ENABLE_TSC_STANDBY=[Y|N]
ENABLE_TSC_STANDBY
TSC Standby 동기화 사용 여부를 설정한다. Y로 설정하면 읽기 별칭과 쓰기 별칭을 분리하여 동작한다. 기본값은 N이며, SRC_DB_TYPE=TIBERO에서만 사용할 수 있다. (적용: Extract, Llob)
SRC_PRIMARY_DB_NAME
정상 TSC 상태에서 Source DB 측 메타데이터 작업을 수행할 Primary 별칭을 설정한다. ENABLE_TSC_STANDBY=Y인 경우 반드시 설정해야 한다. (적용: Extract, Llob)
SRC_PRIMARY_LOCAL_SID
Single TSC 구성의 예시는 다음과 같다.
TAC-TSC(2 Thread) 구성에서는 Extract 프로세스별로 인스턴스 직결 별칭을 다르게 설정한다.
SRC_PRIMARY_LOCAL_SID는 Extract 전용 파라미터이므로 Llob 설정에는 넣지 않는다.
설치 config 파일에 USE_TSC=Y를 설정하면 설치 과정에서 TSC 구성이 자동으로 반영된다.
USE_TSC=Y로 설치하면 다음이 수행된다.
Primary 별칭 접속 확인 및 별칭 중복 검증
Source DB 측 설치 DDL/DML의 Primary 수행 (Archive Log 정보 조회는 Standby에서 수행)
생성되는 Extract/Llob config에 TSC 파라미터 자동 기입
설치 후 생성된 process config에 다음 값이 기입되어 있는지 확인한다.
Standby DB에서 추출할 때 Extract 프로세스는 전체 Redo Thread의 MIN(RECOVERED_TSN)(안전 추출 TSN)까지만 LCR을 전송한다. Failover 승격 시 복구로 재적용되지 않을 수 있는 Redo가 Target DB에 먼저 반영되는 것을 막기 위한 경계이다.
LCR의 TSN이 안전 추출 TSN을 넘으면 Standby 복구가 따라올 때까지 대기한 뒤 전송하며, 대기는 _TCP_CONNECT_INTERVAL 주기로 재시도한다.
PRS_TXINFO의 조회/저장, 동기화 테이블 추가/삭제 시의 Source DB 측 작업(PRS_OBJ_LIST 등록, Supplemental Log 변경 등), Dummy Transaction, Logfile Switch는 쓰기 가능한 라우팅 경로에서 수행된다. 정상 TSC 상태에서는 Primary 별칭에서 수행되고, Failover 이후에는 승격된 Standby 별칭에서 수행된다.
조회와 저장은 항상 같은 DB 접속(쓰기 라우팅이 가리키는 DB)을 사용한다. 정상 TSC 상태에서는 조회도 Primary 별칭에서 수행하며 Standby에서 조회하지 않는다. 이는 Standby 복구 지연으로 인해 Primary에 저장한 메타데이터를 Standby에서 조회하지 못하는 불일치를 막기 위한 동작이다.
Llob 프로세스는 Standby DB에서 Flashback 조회를 수행한다. Standby 복구가 Flashback 조회 시점(AS OF SCN)보다 늦으면 잘못된 값을 읽을 수 있으므로, 조회 전에 전체 Redo Thread의 MIN(RECOVERED_TSN)이 조회 시점 이상이 될 때까지 대기한다.
Failover 이후 Source 별칭이 이미 PRIMARY인 경우에는 대기를 생략한다.
SRC_DB_NAME의 역할이 STANDBY, SRC_PRIMARY_DB_NAME의 역할이 PRIMARY인 상태이다. 쓰기 라우팅은 Primary 별칭을 가리킨다.
SRC_DB_NAME이 여전히 STANDBY인데 Primary 역할 조회가 실패하면 ProSync는 Standby에 쓰기 작업을 보내지 않는다. 쓰기 라우팅은 Primary 방향을 유지한 채 재접속을 재시도한다. 이는 Standby에 메타데이터 쓰기를 보내지 않기 위한 안전 동작이다.
쓰기 작업 직전, 로그 대기 중, 안전 추출 TSN 대기 중에 SRC_DB_NAME의 역할이 PRIMARY로 확인되면 Failover 승격으로 판단한다. 이후 쓰기 라우팅과 읽기 라우팅이 모두 승격된 SRC_DB_NAME으로 통합되고, 기존 DB 접속은 새 라우팅 기준으로 재연결된다.
Extract 프로세스는 승격을 감지하면 읽고 있던 로그를 마지막 안전 지점부터 다시 열고 트랜잭션 추적 상태를 초기화하여, 승격 이전 로그 기준의 상태가 이월되어 변경분이 유실되는 것을 방지한다.
한 번 승격 상태로 전환되면 이전 Primary가 다시 PRIMARY로 돌아와도 ProSync는 실행 중 자동으로 라우팅을 되돌리지 않는다(자동 Switchback 미지원). 이전 Primary로 복귀하려면 TSC 구성 상태와 ProSync 설정을 확인한 뒤 명시적으로 재기동해야 한다.
TSC Standby 동기화는 Tibero Source 전용이다.
TAC-TSC는 Primary와 Standby의 노드 수가 동일해야 한다.
Standby DB는 read-only 모드로 open되어 있어야 한다.
Failover 이후 이전 Primary로의 자동 Switchback은 지원하지 않는다.
복구 상태 대기(안전 추출, Llob Flashback)는 별도 timeout 없이 _TCP_CONNECT_INTERVAL 주기로 계속 재시도한다.
운영 중 다음 로그 키워드로 TSC 동작 상태를 확인할 수 있다.
SRC_DB_TYPE=TIBERO인지 확인한다.
ENABLE_TSC_STANDBY=Y일 때 SRC_PRIMARY_DB_NAME이 설정되어 있는지 확인한다.
Standby DB가 read-only 모드로 open되어 있는지 확인한다.
SRC_DB_NAME과 SRC_PRIMARY_DB_NAME 별칭이 서로 바뀌지 않았는지 확인한다.
waiting for TSC safe extraction TSN 또는 waiting for TSC standby recovery 로그가 지속되면 Standby 복구가 지연되고 있는 것이다.
Standby에서 SELECT MIN(RECOVERED_TSN) FROM V$STANDBY 값이 전진하는지 확인한다.
특정 Redo Thread의 복구만 지연되고 있는지 확인한다. 전체 Thread의 최솟값 기준으로 대기하므로 한 Thread만 늦어도 대기한다.
Redo 전송 또는 Standby 복구 지연 여부를 확인한다.
SRC_DB_NAME의 역할이 아직 STANDBY인지 확인한다. Standby가 승격되지 않았다면 쓰기 작업을 보내지 않는 것이 정상 동작이다.
Failover가 완료되어 SRC_DB_NAME의 역할이 PRIMARY가 되었는지 확인한다.
특정 Extract 프로세스의 변경분만 Target DB에 반영되지 않으면 활성 Standby Log를 잘못된 접속 지점으로 읽고 있을 수 있다.
해당 Extract 프로세스의 SRC_LOCAL_SID가 그 Redo Thread의 로그를 기록하는 Standby 인스턴스 직결 별칭인지 확인한다.
Source DB
Tibero (Single TSC, TAC-TSC — Primary와 Standby의 노드 수가 동일한 구성)
ALTER DATABASE OPEN READ ONLY CONTINUE RECOVERY;SELECT DATABASE_ROLE FROM V$DATABASE;SELECT DATABASE_ROLE FROM V$DATABASE;
SELECT MIN(RECOVERED_TSN) FROM V$STANDBY;
SELECT INSTANCE_NUMBER FROM V$INSTANCE;SRC_DB_TYPE=TIBERO
SRC_DB_NAME=tibero_s
SRC_LOCAL_SID=tibero_s
ENABLE_TSC_STANDBY=Y
SRC_PRIMARY_DB_NAME=tibero_p
SRC_PRIMARY_LOCAL_SID=tibero_p# ext1
SRC_DB_NAME=tibero_s
SRC_LOCAL_SID=tibero_s1
ENABLE_TSC_STANDBY=Y
SRC_PRIMARY_DB_NAME=tibero_p
SRC_PRIMARY_LOCAL_SID=tibero_p1
# ext2
SRC_DB_NAME=tibero_s
SRC_LOCAL_SID=tibero_s2
ENABLE_TSC_STANDBY=Y
SRC_PRIMARY_DB_NAME=tibero_p
SRC_PRIMARY_LOCAL_SID=tibero_p2SRC_DB_TYPE=TIBERO
SRC_DB_NAME=tibero_s
ENABLE_TSC_STANDBY=Y
SRC_PRIMARY_DB_NAME=tibero_pSRC_DB_TYPE=TIBERO
SRC_DB_NAME=tibero_s # Standby 별칭
USE_TSC=Y
SRC_PRIMARY_DB_NAME=tibero_p # Primary 별칭
# (TAC-TSC) SRC_DB_ALIAS_N과 병렬인 Primary 인스턴스별 별칭 (선택)
SRC_PRIMARY_DB_ALIAS_0=tibero_p1
SRC_PRIMARY_DB_ALIAS_1=tibero_p2
# (Cluster) Thread별 Standby 인스턴스 직결 별칭
SRC_DB_CNT=2
SRC_DB_ALIAS_0=tibero_s1
SRC_DB_ALIAS_1=tibero_s2SRC_DB_TYPE=TIBERO
SRC_DB_NAME=tibero_s
ENABLE_TSC_STANDBY=Y
SRC_PRIMARY_DB_NAME=tibero_pTSC standby source enabled
TSC source DB role transition detected
waiting for TSC safe extraction TSN
TSC promotion detected while waiting for safe TSN; reopen current log
TSC promotion detected while waiting for log; reopen current log
waiting for TSC standby recovery before LLOB flashback read
TSC source DB is primary; skip recovered TSN wait
TSC has no writable source DB route
TSC primary source DB role validation failed
TSC writable source DB connection failed
TSC source DB role validation failed; ensure the TSC standby DB is open in read-only mode주의
TSC Standby 동기화는 Tibero Source에서만 사용할 수 있다. Oracle, PostgreSQL Source에서는 ENABLE_TSC_STANDBY=Y를 사용할 수 없다.
또한 ProSync가 연동하는 Standby DB는 Primary DB에 직접 연결된 1개여야 하며, TAC-TSC는 Primary와 Standby의 노드 수가 동일한 구성만 지원한다. 1:N(Broadcasting) Standby 구성과 Cascading Standby 구성의 제약은 아래 '제약사항'을 참고한다.
주의
1:N(Broadcasting) Standby 구성과 Cascading Standby 구성의 하위 Standby 연동은 지원하지 않는다.
ProSync는 SRC_DB_NAME과 SRC_PRIMARY_DB_NAME 두 별칭의 1:1 역할 전환만 추적하므로, 연동하지 않은 다른 DB로 역할 전환이 일어나면 이를 감지하지 못하고 Primary Routing(쓰기 라우팅 전환)이 불가능하다.
NUMBER, CHAR, VARCHAR, DATE, TIME, TIMESTAMP, INTERVAL YEAR TO MONTH, INTERVAL DAY TO SECOND, CLOB
PostgreSQL
SMALLINT, INTEGER, BIGINT, NUMERIC, DECIMAL, REAL, DOUBLE PRECISION, CHARACTER, CHARACTER VARYING, DATE, TIMESTAMP WITHOUT TIMEZONE
[INST_ID]_apply1.cfg 파일에 다음의 파라미터를 설정해야 한다.
APPLY_TO_SAM
APPLY 프로세스에서 DB로 반영하는 STATEMENT를 SAM 파일로 남길지 여부를 설정한다. (Y/N)
SAM_BIND_VALUE
SAM 파일에 남겨지는 Query 의 Value 값 저장 여부를 설정한다. (Y/N)
Y : Value 값을 저장한다. (기본값)
N : Value 값을 '?' 로 치환한다.
SAM_LOG_PREFIX
본 절에서는 TX_SAM_TEMPLATE, STMT_SAM_TEMPLATE, COL_SAM_TEMPLATE 파라미터에서 사용할 템플릿을 설정하는 방법에 대해 서술한다.
템플릿 구성요소는 '% + 알파벳 하나(대소문자 구분)'으로 구성하며, 이렇게 구성된 표현값을 치환하여 Sam File에 출력한다.
xid
%X
트랜잭션의 xid
statement count
%C
op(string)
%O
dml : INSERT, UPDATE, DELETE, ddl : DDL
op code
%o
column name
%N
column 이름
column value
%V
Tibero
NUMBER, CHAR, VARCHAR, DATE, TIME, TIMESTAMP, INTERVAL YEAR TO MONTH, INTERVAL DAY TO SECOND, CLOB, TIMESTAMP WITH TIMEZONE, TIMESTAMP WITH LOCAL TIMEZONE, BINARY_FLOAT, BINARY_DOUBLE
Oracle
APPLY_TO_SAM=[Y|N]
SAM_BIND_VALUE=[Y|N]
SAM_LOG_PREFIX=[Y|N]

SAM_DIR=sam_dir_path
SAM_FILE_SIZE=file_size(1M-16G)
SAM_BACKUP_DIR=sam_backup_dir_path
SAM_BACKUP_SIZE=file_size(0-128G)

SQL_REDO_MODE=[Y|N]
TX_SAM_TEMPLATE=tx_template_file_path
STMT_SAM_TEMPLATE=stmt_template_file_path
COL_SAM_TEMPLATE=col_template_file_path*transaction template file 설정*
tx {
xid: %X
stmt count: %C
commit tsn: %T
}
*EXT SAM FILE 출력 예제*
tx {
xid: 655403
stmt count:
commit tsn: 26362351
}
*APPLY SAM FILE 출력 예제*
tx {
xid: 655403
stmt count: 100
commit tsn: 26362351
}*statement template file 설정*
stmt {
op: %O
op code: %o
owner: %W
table name: %N
sgmt id: %I
tsn: %T
wrap no: %R
log seq: %L
set: %s
where: %w
values: %v
ddl/dml string: %D
}
*column template file 설정*
col {
name: %N
values: %V
column count: %n
}
*INSERT STATEMENT 결과 예제*
INSERT)
stmt {
op:INSERT
op code:0
owner:PRS_TEST
table name:VARCHAR_T
sgmt id:26424
tsn:26362394
wrap no:43
log seq:2102
set:
where:
values:
col {
name:C1
values:1
column count:0
}
col {
name:VCHAR_COL
values:VARCHAR
column count:1
}
ddl/dml string:INSERT INTO "PRS_TEST"."VARCHAR_T" ("C1", "VCHAR_COL") VALUES
(1, VARCHAR)
}
*UPDATE STATEMENT 결과 예제*
UPDATE)
stmt {
op:UPDATE
op code:2
owner:PRS_TEST
table name:NVARCHAR_T
sgmt id:26436
tsn:26362421
wrap no:87
log seq:2103
set:
col {
name:NVCHAR_COL
values:NVARCHAR2
column count:1
}
where:
col {
name:C1
values:10
column count:0
}
col {
name:NVCHAR_COL
values:NVCHAR
column count:1
}
values:
ddl/dml string:UPDATE "PRS_TEST"."NVARCHAR_T" SET NVCHAR_COL = NVARCHAR2
WHERE C1 = 10 AND NVCHAR_COL = NVCHAR
}
*DELETE STATEMENT 결과 예제*
DELETE)
stmt {
op:DELETE
op code:1
owner:PRS_TEST
table name:NVARCHAR_T
sgmt id:26436
tsn:26362437
wrap no:175
log seq:2103
set:
where:
col {
name:C1
values:10
column count:0
}
col {
name:NVCHAR_COL
values:NVARCHAR2
column count:1
}
values:
ddl/dml string:DELETE FROM "PRS_TEST"."NVARCHAR_T" WHERE C1 = 10 AND
NVCHAR_COL = NVARCHAR2
}
*DDL STATEMENT 결과 예제*
DDL)
stmt {
op:DDL
op code:9
owner:PRS_TEST
table name:NVARCHAR_T
sgmt id:
tsn:26362654
wrap no:332
log seq:2103
set:
where:
values:
ddl/dml string:truncate table nvarchar_t
} 주의
SAM_BIND_VALUE 를 사용하여 SAM 파일에 Query의 value 값을 저장할 시, 동기화를 진행중인 table의 column 유형에 따라 SAM 파일의 과도한 용량 증가를 주의해야 한다.
ProSync 사용자는 적용 프로세스의 설정 파일에서 DDL 파라미터를 설정할 수 있다. DDL 파라미터는 동기화 할 DDL에 대한 설정이다.
DDL 파라미터는 하나 이상의 DDL Rule 문장으로 구성된다. DDL Rule에는 DDL 동기화를 포함/배제할 대상과 DDL 종류를 명시할 수 있다.
DDL=([SET] [RANGE], TYPE=('[DDL OPERATION] [DDL OBJECT]', ...))[SET]
INCLUDE 또는 EXCLUDE를 명시할 수 있다.
INCLUDE: 기술된 규칙에 대해 동기화한다.
EXCLUDE: 기술된 규칙에 대해 동기화하지 않는다. 어떠한 INCLUDE보다 EXCLUDE를 우선시한다.
다음은 설정 가능한 [DDL OPERATION]과 [DDL OBJECT]의 조합이다. Source DB가 Tibero인 경우와 Oracle인 경우 동일하게 지원한다.
O : 지원
△ : 특정 조건에서만 지원 (비고 참조)
X : 미지원
위 조합 외에 COMMENT ON과 TRUNCATE TABLE을 지원한다.
다음 DDL은 동기화를 지원하지 않으며, 추출 단계에서 skip 처리된다.
GRANT, REVOKE
RENAME (ALTER ... RENAME 구문은 ALTER로 동기화 설정하여 사용할 수 있다.)
ALTER DATABASE LINK,
다음은 모든 스키마에 대해서 모든 종류의 DDL 동기화를 하지만, 스키마 EXCLUDED_USR의 모든 테이블에 대한 DDL 동기화는 배제하는 예제이다.
다음은 동기화 대상 테이블에 대해 TABLE을 대상으로 하는 DDL을 동기화하고, INCLUDED_USR의 모든 오브젝트 이름에 대해 INDEX를 대상으로 하는 DDL을 동기화한다. 반면, 오브젝트 이름이 EXCLUDED_USR.IDX1일 경우 INDEX를 대상으로 하는 DDL을 동기화하지 않는다.
다음은 SRCUSR의 모든 테이블에 대해 TYPE에 해당되는 DDL을 동기화하지만, SRCUSR.T1에 대해서는 DROP TABLE과 CREATE TABLE에 해당되는 DDL을 동기화하지 않는다.
DDL 문장 크기 동기화 할 DDL 문장의 각 요소는 128글자를 넘을 수 없다.
설정 전 확인 DDL 파라미터의 대상과, 동기화 할 DDL 종류가 정확한지 Wildcard를 고려하여 확인하고 설정한다. 다른 DB나 대상에게 먼저 적용해보고 설정하는 것을 권장한다.
CREATE TABLE 이후 동기화
CREATE TABLE에 대한 DDL 동기화 후 생성된 테이블을 DML 동기화 하려면 동기화 대상에 추가해야 한다. Admin 명령으로 수동 등록하거나 AUTO_SYNC_ON_CREATE=Y로 자동 등록할 수 있다. 반면 DDL은 Rule에 의해 생성된 직후부터 동기화 될 수 있으므로 주의한다.
해당 Query가 수행된 시간과 스레드 데이터 정보를 SAM 파일 row의 시작 부분에 붙이는 기능이다. (Y|N)
Y : 해당 정보를 row의 시작 부분에 첨부한다. (기본값)
N : 해당 정보를 남기지 않는다.
SAM_DIR
프로세스의 SAM 파일이 저장되는 디렉터리 위치를 나타낸다.
SAM_FILE_SIZE
프로세스별 SAM 파일의 최대 크기를 설정한다.
SAM 파일의 크기가 SAM_FILE_SIZE를 넘으면 SAM_BACKUP_DIR로 옮긴 후 새로운 SAM 파일을 생성한다. (기본값: 16GB, 범위: 1MB ~ 16GB)
SAM_BACKUP_DIR
SAM 파일의 백업 파일이 저장되는 디렉터리 위치를 설정한다.
SAM_BACKUP_SIZE
SAM_BACKUP_SIZE는 SAM_BACKUP_DIR에 백업되는 SAM 파일들의 최대 크기를 설정한다. (기본값: 0 (제한없음), 범위: 0 ~ 128GB)
SQL_REDO_MODE
SQL_REDO_MODE 파라미터는 Sam File에 적히는 내용을 full dml/ddl로 적어주는 기능이다. (Y|N)
Y : sam file에 row by row로 DML이 남게 된다. (기본값)
N : sam file에 row by row로 DML이 남지 않는다.
TX_SAM_TEMPLATE
TX_SAM_TEMPLATE 파라미터는 트랜잭션을 Sam File에 출력할 때 사용할 user_defined_template 파일의 경로를 설정하는 파라미터이다. SQL_REDO_MODE가 N인 경우에 동작한다.
ProSync는 트랜잭션이 commit을 만날 때마다 본 파라미터 경로에 있는 템플릿을 읽어 해당 템플릿 형식대로 sam file에 트랜잭션 내용을 남긴다.
STMT_SAM_TEMPLATE
STMT_SAM_TEMPLATE 파라미터는 statement(dml/ddl) 내용을 Sam File에 남겨줄 때 사용할 user_defined_template 파일의 경로를 설정하는 파라미터이다. SQL_REDO_MODE가 N인 경우에 동작한다.
ProSync는 DDL과 DML 내용을 Sam File에 남겨줄 때 본 파라미터 경로에 있는 템플릿을 읽어 해당 템플릿 형식대로 sam file에 DDL, DML 내용을 남긴다.
COL_SAM_TEMPLATE
COL_SAM_TEMPLATE 파라미터는 DML을 출력할 때 컬럼 내용을 남길 때 사용할 user_defined_template 파일의 경로를 설정하는 파라미터이다. SQL_REDO_MODE가 N인 경우에 동작한다.
ProSync는 DML을 파일에 남겨줄 때 COL_SAM_TEMPLATE에 컬럼에 대한 정의가 되어 있다면 해당 템플릿 형식대로 sam file에 컬럼 정보를 남긴다.
트랜잭션의 statement(dml) 개수, ext sam에서는 출력하지 않는다.
commit tsn
%T
트랜잭션의 commit tsn
insert, update, delete, ddl에 대한 opcode
owner
%W
statement의 user name
name
%N
statement의 table name
sgmt id
%I
해당 object의 segment id
tsn
%T
statement가 실행된 tsn
wrap no
%R
statement의 wrap number
log seq
%L
statement가 기록된 log sequence number
set
%s
update 구문의 set 절에 대한 내용 (insert와 delete의 경우 empty string으로 치환)
where
%w
update, delete 구문의 where 절에 대한 내용 (insert의 경우 empty string으로 치환)
values
%v
insert 구문의 values 절에 대한 내용 (update, delete의 경우 empty string으로 치환)
ddl/dml string
%D
statement의 full dml/ddl string
column 값
column count
%n
column count
LOG_REPLICATION_DEST_N으로 Standby를 여러 개 연결하는 구성이다. Failover 시 TSN이 가장 높은 Standby가 Primary로 승격되어 승격 대상을 예측할 수 없으므로 New Primary를 감지할 수 없다. 또한 각 Standby가 동일한 Redo Log를 보유하므로 여러 Standby에 Extract 프로세스를 각각 기동하면 Target DB에 DML이 중복 반영될 수 있다. 이 구성은 지원하지 않는다.Cascading Standby: STANDBY_ENABLE_CASCADING=Y로 Standby가 다른 Standby에 Redo Log를 중계하는 구성이다. Primary DB에 직접 연결된 최상단 Standby에 연동하는 것은 지원한다. 다만 하위 Standby(다른 Standby로부터 Redo Log를 중계받는 Standby)에 연동하는 것은 cascade 단계에 따른 지연이 있고 상위 Standby의 역할 전환을 감지할 수 없으므로 지원하지 않는다.
Primary 별칭. Source DB 측 메타데이터 조회/변경 작업에 사용한다.
SRC_PRIMARY_LOCAL_SID
Primary 인스턴스 직결 별칭(Extract 전용). Dummy Transaction, Logfile Switch에 사용한다.
SRC_DB_NAME
PRS_TXINFO 조회/저장
SRC_PRIMARY_DB_NAME
SRC_DB_NAME
동기화 테이블 추가/삭제
SRC_PRIMARY_DB_NAME
SRC_DB_NAME
Supplemental Log 변경
SRC_PRIMARY_DB_NAME
SRC_DB_NAME
Dummy Transaction
SRC_PRIMARY_LOCAL_SID
SRC_LOCAL_SID
Logfile Switch
SRC_PRIMARY_LOCAL_SID
SRC_LOCAL_SID
Dummy Transaction, Logfile Switch와 같이 특정 인스턴스에서 수행해야 하는 작업에 사용할 Primary 인스턴스 직결 별칭을 설정한다. 설정하지 않으면 SRC_PRIMARY_DB_NAME을 사용한다. TAC-TSC 환경에서는 Extract 프로세스별로 해당 Redo Thread를 소유한 Primary 인스턴스의 별칭을 설정한다. (적용: Extract)
TRUNCATE TABLE도 지원한다.
INDEX
O
O
O
VIEW
O
O
O
MATERIALIZED VIEW
O
△
O
ALTER MATERIALIZED VIEW는 추출·전달되며, Target DB가 Tibero인 경우에만 반영(apply) 단계에서 skip된다.
MATERIALIZED VIEW LOG
O
O
O
SEQUENCE
O
O
O
SYNONYM
O
X
O
PUBLIC SYNONYM도 SYNONYM과 동일한 종류로 처리된다.
PROCEDURE
O
O
O
FUNCTION
O
O
O
PACKAGE
O
O
O
PACKAGE BODY
O
O
O
TRIGGER
O
O
O
TYPE
O
O
O
TYPE BODY
O
O
O
USER
O
O
O
ROLE
△
△
△
스키마 비종속 객체로 INCLUDE ALL에서만 동기화된다. CREATE / ALTER는 비밀번호를 명시하지 않은 경우에만 지원한다.
TABLESPACE
△
△
△
스키마 비종속 객체로 INCLUDE ALL에서만 동기화된다. Target DB가 Oracle CDB-PDB 구성인 경우 아래 유의사항의 제약을 함께 확인한다.
DATABASE LINK
△
X
△
스키마 비종속 객체로 INCLUDE ALL에서만 동기화된다. PUBLIC DATABASE LINK도 DATABASE LINK와 동일한 종류로 처리된다.
DIRECTORY
△
X
△
스키마 비종속 객체로 INCLUDE ALL에서만 동기화된다.
LIBRARY
△
X
△
스키마 비종속 객체로 INCLUDE ALL에서만 동기화된다.
ALTER PUBLIC DATABASE LINKRENAME 지원 DDL 중 RENAME은 지원하지 않는다. ALTER ... RENAME을 이용한 DDL 구문은 ALTER를 동기화 설정하여 사용할 수 있다.
ORACLE LOGMNR Source DB가 Oracle, logmnr 를 사용할 때 동기화 대상에 대한 DDL 동기화만 지원한다.
INDEX / CONSTRAINTS 관련 주의사항 INDEX / CONSTRAINTS의 경우 SRC/TAR DB에서 이름이 다를 경우 동기화가 불가능하다.
DDL 설정 조합 복수 개의 DDL 룰에 대한 설정 시 아래와 같은 형태로 명시한다.
OBJECT 동기화 DDL 동기화의 경우 INCLUDE DEFAULT 사용 시 오브젝트에 대한 DDL 동기화는 수행되지 않으며, 오브젝트에 대한 DDL 동기화 수행을 원하는 경우 직접 명시해야한다
스키마 미명시 DDL 구문의 동기화 제한 DDL 구문에서 대상 객체의 스키마(Schema) 가 명시되지 않은 경우, 해당 구문은 동기화가 수행되지 않는다. 따라서 스키마를 명시한 형태의 DDL 구문으로 작성해야만 동기화가 가능하다.
예시
SYS 스키마 DDL 동기화 제약사항 스키마가 SYS인 경우, 해당 스키마를 대상으로 수행되는 모든 DDL은 동기화 시 Skip 처리된다.
스키마 비종속 객체(Non-Schema Object) 동기화 제약사항
TABLESPACE, DIRECTORY, DATABASE LINK, ROLE, LIBRARY 객체는 특정 스키마에 종속되지 않는 객체로, DDL 동기화 시 INCLUDE ALL 옵션이 설정된 경우에만 동기화를 지원한다. INCLUDE DEFAULT인 경우 동기화를 지원하지 않는다.
Password 포함 DDL 동기화 제약사항
CREATE ROLE, ALTER ROLE, CREATE [PUBLIC] DATABASE LINK 등 비밀번호 정보가 포함될 수 있는 DDL 문장은 비밀번호를 명시하지 않는 경우에만 DDL 동기화를 지원한다.
Target Oracle CDB-PDB 환경의 TABLESPACE 동기화 제약사항
ProSync는 DDL 문장을 Target DB 세션에서 그대로 수행하며, DATAFILE 경로를 Target DB 기준으로 변환하지 않는다. Target DB가 Oracle CDB-PDB 구성인 경우 TABLESPACE 관련 DDL은 다음 제약을 갖는다.
TABLESPACE는 Target 접속 정보(TAR_DB_NAME)가 가리키는 컨테이너에 생성된다. 접속 서비스가 PDB가 아닌 CDB(CDB$ROOT)를 가리키면 TABLESPACE도 CDB에 생성되므로, 동기화 대상 PDB의 서비스로 접속하도록 설정해야 한다.
DATAFILE을 파일명만(상대 경로) 명시한 DDL은 PDB 전용 디렉터리가 아니라 CDB와 모든 PDB가 공유하는 디렉터리($ORACLE_HOME/dbs)에 데이터 파일을 생성한다. Target에 DB_CREATE_FILE_DEST가 설정되어 있는 경우에만 해당 위치에 PDB별로 생성된다. 공유 디렉터리에 생성되므로 다른 컨테이너가 같은 이름의 데이터 파일을 이미 사용 중이면 ORA-01537, 이전에 생성된 파일이 남아 있으면 ORA-01119 / ORA-27038로 CREATE TABLESPACE가 실패한다. Source DB 기준의 절대 경로가 명시된 경우에도 Target에 동일한 경로가 없으면 실패한다.
CREATE TABLESPACE가 실패한 뒤 해당 TABLESPACE를 참조하는 CREATE TABLE이 동기화되면 ORA-00959: tablespace ... does not exist로 실패한다. 반영에 실패한 DDL은 기본 설정(DISCARD_DDL_YN=N)에서 계속 재시도되므로 이후 동기화가 진행되지 않는다. DISCARD_DDL_YN=Y로 설정하면 실패한 TABLESPACE DDL은 discard되지만, CREATE TABLE은 discard 대상이 아니므로 동일하게 재시도된다.
따라서 Target이 CDB-PDB 구성인 환경에서는 Target PDB에 TABLESPACE를 미리 생성해 두고 DDL Rule에서 TABLESPACE 관련 DDL을 동기화 대상에서 제외하거나, Target에 DB_CREATE_FILE_DEST를 설정하여 데이터 파일이 PDB별 경로에 생성되도록 구성할 것을 권장한다.
[RANGE]
ALL 또는 DEFAULT 중 하나를 명시하거나, DB의 오브젝트 이름을 직접 명시할 수 있다.
ALL: 모든 스키마, 테이블에 대해 적용된다.
DEFAULT: 모든 동기화 대상 테이블에 대해 적용된다.
오브젝트 이름을 직접 명시: 대상에 대해 적용된다.
TYPE
TYPE은 하나 이상의 DDL OPERATION과 DDL OBJECT 쌍으로 구성된다. 지정되어 있지 않는 경우, Wildcard로 처리한다.
[DDL OPERATION]
Rule에 적용할 DDL 종류를 명시한다.
[DDL OBJECT]
Rule에 적용할 DDL 종류에 대한 대상을 명시한다.
TABLE
O
O
주의 DDL=(INCLUDE ALL, TYPE=('%')) 설정 시, Source DB의 모든 스키마에서 수행되는 모든 타입의 DDL이 동기화된다. 동기화 대상 여부와 관계없이 모든 DDL이 적용되므로 사용 시 주의가 필요하다. 추가적으로 INCLUDE ALL로 설정하는 경우 설치될 Instance 는 단일 Instance 로 구성되어야 한다.
O
DDL=([SET] [RANGE], TYPE=('[DDL OPERATION] [DDL OBJECT]', ...)
[SET] [RANGE], TYPE=('[DDL OPERATION] [DDL OBJECT]', ...) ....)CREATE TABLE TEST_TABLE2 (
c1 NUMBER,
CONSTRAINT fk_test FOREIGN KEY (c1) REFERENCES [스키마명].TEST_TABLE1 (c1)
);DDL=(
INCLUDE ALL, TYPE=('%')
EXCLUDE EXCLUDED_USR.%, TYPE=('%')
)DDL=(
INCLUDE DEFAULT, TYPE=('% TABLE')
INCLUDE INCLUDED_USR.%, TYPE=('% INDEX')
EXCLUDE EXCLUDED_USR.IDX1, TYPE=('% INDEX')
)DDL=(
INCLUDE SRCUSR.%, TYPE=('DROP TABLE', 'ALTER TABLE', 'TRUNCATE TABLE')
EXCLUDE SRCUSR.T1, TYPE=('DROP TABLE', 'CREATE TABLE')
)ProSync Admin Utility 내에서 운영체제의 명령어를 실행한다.
! [command]
HO[ST] [command]command
운영체제의 명령어이다.
운영체제의 명령어 없이 ! 명령어만 입력하면 운영체제의 명령 프롬프트로 나가서 운영체제의 명령어를 여러 번 입력할 수 있다.
이때 다시 ProSync Admin Utility로 돌아오려면 EXIT 명령어를 입력한다.
다음은 현재 디렉터리 내에 확장자가 ext인 모든 디렉터리와 파일 목록을 출력하는 예제이다.
특정 스크립트 파일을 실행한다. 파일의 확장자가 SUFFIX 시스템 변수에 등록되어 있으면, 확장자를 생략하고 파일명을 지정할 수 있다.
스크립트 실행 전에 SET 명령어로 설정된 시스템 변수는 실행 도중에도 유효하다. 스크립트 내에서 EXIT 또는 QUIT 명령어를 실행하면 ProSync Admin Utility가 정지한다.
다음은 현재 디렉터리 내의 스크립트 파일을 실행하는 예제이다.
ProSync Admin Utility 내에서 히스토리 버퍼에 저장된 명령어를 재수행한다.
다음은 히스토리 버퍼에 저장된 'HELP' 명령어를 재수행하는 예제이다:
ProSync 운영 중에 동기화 대상 테이블을 추가/제거 하거나, 기동 중인 ProSync 프로세스의 Parameter를 변경할 수 있다.
동기화 테이블 추가/제거의 경우, 기동 전에 prs_obj_group1.list에 추가하지 못했던 테이블을 ProSync 운영 중에 동적으로 추가할 수 있다. Source DB를 오라클을 사용하고, 로그마이너를 통한 추출을 하는 경우 다음과 같은 동작을 수행해야 동적 동기화 테이블 추가가 가능하다.
소스 오라클, 타겟 티베로 동기화 대상 테이블 생성(CREATE 수행)
Admin Utility에서 ALTER <inst_id> ADD TABLE 수행 (해당 테이블에 supplemental log가 함께 추가된다)
소스 오라클 ALTER SYSTEM SWITCH LOGFILE 수행
DML/DDL 동기화 확인
Parameter 변경의 경우, 수정을 원하는 Parameter의 유형이 Dynamic 인 경우에만 변경할 수 있다.
ProSync Admin Utility를 정지한다. 현재 진행 중이던 프로세스에 영향을 전혀 주지 않고 Utility만 정지된다.
Admin 명령어 사용에 대한 도움말을 화면에 출력한다.
옵션을 지정하지 않으면 ProSync Admin Utility에서 사용할 수 있는 전체 명령어를 출력한다.
다음은 SET 파라미터에 대한 도움말을 화면에 출력하는 예제이다.
사용자가 입력한 INST_ID의 작업을 멈추는 명령어이다.
모든 프로세스가 정지하는 것이 아닌, 추출이 더 이상 데이터를 추출하지 않도록 하는 기능이다. 즉 현재 반영중인 내용이나 이미 소켓을 타고 넘어간 데이터들에 대한 반영은 이루어진다.
다음은 'prosync4'의 작업을 일시정지하는 예제이다.
사용자가 입력한 INST_ID의 작업을 재개하는 명령어이다.
PAUSE 의 동작을 되돌리는 것으로, 추출이 다시 시작되는 기능으로 볼 수 있다.
예제
ProSync Admin Utility의 시스템 변수를 설정한다.
SET 명령어로 설정된 시스템 변수는 SHOW 명령어를 사용하여 출력한다. 단, 변경된 시스템 변수는 현재 세션 내에서만 유효하다. 각각의 시스템 변수에 대해서는 를 참고한다.
예제
ProSync Admin Utility의 시스템 변수 및 각 프로세스의 파라미터를 출력한다.
다음은 시스템 변수를 출력하는 예제이다.
다음은 'prosync4' 에 속한 프로세스들의 파라미터를 출력하는 예제이다.
다음은 'agent1' 에 속한 모든 파라미터를 출력하는 예제이다.
사용자가 입력한 INST_ID의 프로세스 혹은 매니저 프로세스를 정지한다.
다음은 'pro'의 프로세스를 정지하는 예제이다.
다음은 'agent1'의 매니저 프로세스를 정지하는 예제이다.
사용자가 입력한 INST_ID의 프로세스를 실행한다.
다음은 'agent1'의 매니저 프로세스를 실행하는 예제이다.
다음은 'pro' instance를 실행하는 예제이다.
전체 프로세스, 사용자가 입력한 INST_ID의 프로세스 혹은 매니저 프로세스의 상태를 확인하는 명령어이다.
전체 프로세스의 상태를 조회하는 경우 STATUS 명령어만 사용한다.
다음은 모든 Instance(inst_id) 프로세스를 조회하는 예제이다.
다음은 Instance(inst_id)가 'prosync4'인 모든 프로세스 및 스레드의 상태를 조회하는 예제이다.
Instance의 apply 프로세스가 Target DB에 반영 중인 Query의 정보를 출력한다.
다음은 MONITOR 명령어를 통해 현재 적용 중인 쿼리를 조회하는 예제이다.
프로세스의 메모리 할당 현황을 파일로 출력하는 진단 명령어이다. 메모리 사용량 분석이나 장애 진단 시 기술 지원의 요청에 따라 사용한다.
결과 파일은 $PRS_HOME/var/<instance>/alloc/ 경로에 생성된다.
Apply 프로세스의 내부 상태를 파일로 출력하는 진단 명령어이다. Apply 프로세스 전용이다.
결과 파일은 $PRS_HOME/var/<instance>/dump/ 경로에 생성된다.
프로세스 내부 상태의 스냅샷 dump를 생성하거나, 생성된 dump 파일을 분석하는 진단 명령어이다.
결과 파일은 $PRS_HOME/var/<instance>/jcdump/ 경로에 생성된다.
ProSync Admin Utility에서 주로 사용하는 기능은 명령어를 직접 입력하여 프로세스를 실행하고 정지하고 일시정지하는 것이다. ProSync Admin Utility 명령어는 실행을 위한 명령어가 따로 없으며, 입력된 명령어는 버퍼에 저장된다. ProSync Admin Utility 명령어는 입력을 마침과 동시에 실행된다.
위의 예는 INST_ID가 prosync4인 모든 프로세스를 실행하는 명령어의 입력 및 실행 결과를 보이고 있다. INST_ID의 추출, 적용, LONG/LOB 프로세스가 각각 기동된다. 예제의 명령어를 입력하기 이전에 해당 INST_ID에 연결되어 있는 매니저 프로세스를 실행시켜야 한다.
INST_ID를 정지하면, 매니저 프로세스를 제외한 추출, 적용, LONG/LOB 프로세스가 중단된다.
Admin> ! dir *.ext
Admin> !

Admin> HOST dir *.ext
Admin> HOST@ {filename}filename
스크립트 파일의 이름이다. ProSync Admin Utility는 파일을 현재 디렉터리에서 찾는다.
Admin> @ run
Admin> @ run.sql/Admin> HELP
Admin> /#동기화 테이블 추가/제거
ALTER inst_id {ADD|DEL[ETE]} TABLE table_owner.table_name GROUP=group_num
#Parameter 변경
ALTER inst_id {EXT|APP[LY]|LLOB} SET parameter='values'EXIT | Q[UIT]H[ELP] [topic]topic
도움말을 출력할 단어를 지정한다.
Admin> HELP SETPAUSE {inst_id|ALL}inst_id
일시 정지할 inst_id이다.
ALL
등록된 모든 instance의 작업을 일시 정지한다.
Admin> PAUSE prosync4
prosync4 paused.RESUME {inst_id|ALL}inst_id
재시작할 inst_id이다.
ALL
등록된 모든 instance의 작업을 재개한다.
Admin> RESUME prosync4
prosync4 resumed.SET {parameter} {value}parameter
ProSync Admin Utility 시스템 변수의 이름이다.
value
ProSync Admin Utility 시스템 변수의 값이다.
Admin> SET HISTORY 100SHO[W] ALL
SHO[W] PARAM[ETER] instance_id {EXT[RACT] num | APP[LY] num | LLOB} [parameter_name]
SHO[W] PARAM[ETER] AGE[NT] agent_id [parameter_name]ALL
모든 ProSync Admin Utility 시스템 변수를 출력한다.
PARAM[ETER]
파라미터의 값을 출력할 때 사용한다.
instance_id
Admin> SHOW ALLAdmin> SHOW PARAM prosync4 EXT 1 LOG_LEVEL
Admin> SHOW PARAM prosync4 APPLY 1 MAP
Admin> SHOW PARAM prosync4 LLOB LLOB_FLASHBACK_ERRORAdmin> SHOW PARAM AGENT agent1SHUTD[OWN] ALL
SHUTD[OWN] AGE[NT] [agent_id] [ABORT]
SHUTD[OWN] inst_id [EXT[RACT] [num] | APP[LY] [num] | LLOB] [ABORT]ALL
등록된 모든 instance를 정지한다.
AGE[NT]
Agent 프로세스를 정지할 때 사용한다.
agent_id
Admin> SHUTDOWN pro
*** Shutdown Process... [pro_ext1]
	Process 'pro_ext1' aborted.
*** Shutdown Process... [pro_apply1]
	Process 'pro_apply1' aborted.
*** Shutdown Process... [pro_llob]
Process 'pro_llob' aborted.Admin> SHUTDOWN AGENT agent1
*** Shutdown Agent Process... [agent1]
Process 'prs_agent' aborted.START[UP] ALL
START[UP] AGE[NT] agent_id
START[UP] inst_id [EXT[RACT] [num] | APP[LY] [num] | LLOB]ALL
등록된 모든 instance를 기동한다.
AGE[NT]
Agent 프로세스를 실행할 때 사용한다.
agent_id
Admin> STARTUP AGENT agent1
*** Startup Agent Process... [agent1]
Process 'prs_agent' started.Admin> STARTUP pro
*** Startup Process... [pro_ext1]
Process 'pro_ext1' started.
*** Startup Process... [pro_apply1]
Process 'pro_apply1' started.
*** Startup Process... [pro_llob]
Process 'pro_llob' started.STATUS
STATUS inst_idinst_id
특정 inst_id의 Ext, Apply, LONG/LOB 프로세스의 상태를 조회할 때 사용한다.
Admin> STATUS
prs_agent ID: agent1, HOST: 192.168.51.45, PORT: 7600 is running
prs_agent ID: agent2, HOST: 192.168.51.54, PORT: 7601 is running
prs_agent ID: agent3, HOST: 192.168.51.55, PORT: 7602 is stopped

Instance ID: [prosync4]
prosync4_ext1 (1) is running (prs_mgr ID : agent1, HOST: 192.168.51.45, PORT: 7600)
prosync4_ext2 (2) is running (prs_mgr ID : agent1, HOST: 192.168.51.45, PORT: 7600)
prosync4_apply1 (1) is running (prs_mgr ID : agent2, HOST: 192.168.51.54, PORT: 7601)
prosync4_llob (1) is stopped (prs_mgr ID : agent1, HOST: 192.168.51.45, PORT: 7600)

Instance ID: [prosync3]
Agent Process for proc[Extract], num[1] is not running.
Agent Process for proc[Extract], num[2] is not running.
Agent Process for proc[Apply], num[1] is not running.
Agent Process for proc[LONG/LOB], num[1] is not running.
Agent Process for proc[Verify], num[1] is not running.Admin> STATUS prosync4
prosync4_ext1 (20133) has 8 cores, started at 2020/09/09 15:44:19
+ control thread, running
+ worker thread, running
+ sam thread, recv waiting
+ read thread, recv waiting
prosync4_apply1 (20154) has 8 cores, started at 2020/09/09 15:44:19
+ control thread, running
+ replay thread, recv waiting
+ construct thread, recv waiting
prosync4_llob (20168) has 8 cores, started at 2020/09/09 15:44:19
+ control thread, running
+ long/lob thread, recv waiting
prosync4_vf, stoppedMON[ITOR] {inst_id}Thread #0
sql_text:
DELETE FROM "TEST"."T33" WHERE "C1" = :"C1" AND "C2" = :"C2" AND
"C3" = :"C3" AND "C4" = :"C4" AND "C5" = :"C5" AND "C6" = :"C6"
AND "C7" = :"C7" AND "C8" = :"C8" AND "C9" = :"C9" AND "C10" =
:"C10" AND "C11" = :"C11" AND "TIME" = :"TIME" AND ROWNUM = 1
sql_et: 0 (ms)
Thread #1
sql_text:
DELETE FROM "TEST"."T33" WHERE "C1" = :"C1" AND "C2" = :"C2" AND
"C3" = :"C3" AND "C4" = :"C4" AND "C5" = :"C5" AND "C6" = :"C6"
AND "C7" = :"C7" AND "C8" = :"C8" AND "C9" = :"C9" AND "C10" =
:"C10" AND "C11" = :"C11" AND "TIME" = :"TIME" AND ROWNUM = 1
sql_et: 0 (ms)
Thread #2
sql_text:
UPDATE "TEST"."T31" SET "C2" = :"C2", "C3" = :"C3", "C9" = :"C9"
, "C10" = :"C10", "C11" = :"C11" WHERE "C1" = :"C1" AND "C2" = :
"C2" AND "C3" = :"C3" AND "C4" = :"C4" AND "C5" = :"C5" AND "C6"
= :"C6" AND "C7" = :"C7" AND "C8" = :"C8" AND "C9" = :"C9" AND
"C10" = :"C10" AND "C11" = :"C11" AND "TIME" = :"TIME" AND ROWNUM
= 1
sql_et: 0 (ms)
Thread #3
sql_text:
UPDATE "TEST"."T33" SET "C2" = :"C2", "C3" = :"C3", "C9" = :"C9"
, "C10" = :"C10", "C11" = :"C11" WHERE "C1" = :"C1" AND "C2" = :
"C2" AND "C3" = :"C3" AND "C4" = :"C4" AND "C5" = :"C5" AND "C6"
= :"C6" AND "C7" = :"C7" AND "C8" = :"C8" AND "C9" = :"C9" AND "
C10" = :"C10" AND "C11" = :"C11" AND "TIME" = :"TIME" AND ROWNUM
= 1
sql_et: 0 (ms)SQL_TEXT
Replay 스레드가 현재 적용 중인 Query
SQL_ET
해당 Query문을 수행 시작하고 경과된 시간
ALLOCDUMP {inst_id} [EXT|APPLY|LLOB]inst_id
dump를 수행할 instance의 inst_id이다.
EXT|APPLY|LLOB
dump를 수행할 프로세스를 지정한다.
TRACEDUMP {inst_id} [DD|MERGE|DEPENDENCY|QUEUE]inst_id
dump를 수행할 instance의 inst_id이다.
DD
Apply가 보유한 Data Dictionary 상태를 dump한다.
MERGE
JCDUMP {inst_id} [EXT|APPLY|LLOB] [label]
JCDUMP COMPARE {inst_id} {file1} [file2]
inst_id
dump를 수행할 instance의 inst_id이다.
EXT|APPLY|LLOB
dump를 수행할 프로세스를 지정한다.
label
Admin> START AGENT agent1
*** Startup Agent Process... [agent1]
        Process 'prs_agent' started.

Admin> STARTUP prosync4
*** Startup Process... [prosync4_ext1]
        Process 'prosync4_ext1' started.
*** Startup Process... [prosync4_apply1]
        Process 'prosync4_apply1' started.
*** Startup Process... [prosync4_llob]
Process 'prosync4_llob' started.Admin> SHUTDOWN prosync4
*** Shutdown Process... [prosync4_ext1]
Process 'prosync4_ext1' aborted.
*** Shutdown Process... [prosync4_apply1]
Process 'prosync4_apply1' aborted.
*** Shutdown Process... [prosync4_llob]
Process 'prosync4_llob' aborted.주의
Parameter 변경은 각 프로세스가 실제로 ALTER 처리를 지원하는 파라미터에 대해서만 적용된다. 문서상 Dynamic으로 표기된 파라미터라도 해당 프로세스가 변경을 지원하지 않으면 not supported로 실패할 수 있다.
ALTER로 변경한 값은 프로세스 메모리에만 적용되고 cfg 파일에는 기록되지 않는다. 프로세스를 재기동하면 cfg 파일의 값으로 원복되므로, 영구적으로 반영하려면 cfg 파일도 함께 수정해야 한다.
주의
현재 버전에서는 ABORT 옵션 지정 여부와 관계없이 SHUTDOWN이 강제 종료(abort) 방식으로 동작한다. 즉, 처리 중이던 작업을 마무리하는 정상 종료(graceful shutdown)로 동작하지 않는다. 재기동 시에는 checkpoint 기반으로 복구되며, 관련 내용은 를 참고한다.
파라미터를 확인하고자 하는 instance 의 instance_id.
EXT[RACT] {num}
{num} 번째 노드의 추출 프로세스에 속한 파라미터를 출력한다.
APP[LY] {num}
{num} 번째 노드의 적용 프로세스에 속한 파라미터를 출력한다.
LLOB
LONG/LOB 프로세스에 속한 파라미터를 출력한다.
AGE[NT]
agent 프로세스의 파라미터를 출력할 때 사용한다.
agent_id
파라미터를 확인하고자 하는 agent 의 agent_id.
parameter_name
확인하고자 하는 parameter의 이름을 입력한다. 파라미터 이름을 입력하지 않으면 해당 프로세스에 속한 모든 파라미터의 값이 출력된다.
특정 agent_id 의 프로세스를 정지할 때 사용한다.
inst_id
특정 inst_id의 프로세스를 정지할 때 사용한다.
EXT[RACT] [num]
[num]번째 노드의 추출 프로세스를 정지할 때 사용한다.
APP[LY] [num]
[num]번째 노드의 적용 프로세스를 정지할 때 사용한다.
LLOB
LONG/LOB 프로세스를 정지할 때 사용한다.
ABORT
강제로 정지할 때 사용한다.
특정 agent_id 의 프로세스를 실행할 때 사용한다.
inst_id
특정 inst_id의 프로세스를 실행할 때 사용한다.
EXT[RACT] [num]
[num]번째 노드의 추출 프로세스를 실행할 때 사용한다.
APP[LY] [num]
[num]번째 노드의 적용 프로세스를 실행할 때 사용한다.
LLOB
LONG/LOB 프로세스를 실행할 때 사용한다.
merge 처리 상태를 dump한다.
DEPENDENCY
트랜잭션 의존성 처리 상태를 dump한다.
QUEUE
내부 queue 상태를 dump한다.
dump 파일을 구분하기 위한 이름표이다. 시점별 dump를 비교할 때 사용한다.
COMPARE
이미 생성된 dump 파일을 분석할 때 사용한다. file1, file2는 jcdump 디렉토리 내 파일 이름의 일부로 지정할 수 있으며, 여러 파일이 일치하면 번호로 선택한다. 두 파일을 지정하면 두 dump를 비교하고, file2를 생략하면 file1 하나에 대한 분석 결과를 출력한다.