For the complete documentation index, see llms.txt. This page is also available as Markdown.

제품 구성도

제품 소개와 제품 설계를 기반으로 ProSync가 어떤 구성으로 설치되고 운영되는지에 대한 구성도를 설명한다.

앞서 설명한 프로세스 개요 및 설계 구조가 실제 운영 환경 내 구성에 적용되는 사항을 이해하면 설치 절차 및 파라미터 변경 사항을 정확히 파악할 수 있다.

참고

Single 과 Cluster DB

ProSync에서 Single이란 Cluster가 아닌 DB를 의미한다. ProSync 관점에서의 Cluster DB란 Active-Active Cluster가 가능한 RDBMS를 의미하며, 단 두 가지 제품군만이 이 기능을 제공한다.

Tibero Active Cluster (TAC)와 Oracle의 Real Application Clusters(RAC) 를 의미한다고 이해할 수 있다.

참고

Process의 기동 위치

Extract 프로세스를 제외한 모든 프로세스는 기동 위치에 관계없다. Extract 프로세스의 기동 위치 요구사항은 Source DB 종류에 따라 다르다.

  • Tibero, Oracle: 데이터 변경분(Redo/Archive Log)을 해당 서버의 disk에서 직접 읽기 때문에 추출하고자 하는 서버에 기동되어야 한다.

  • PostgreSQL: WAL logical replication 연결(network)을 통해 추출하기 때문에 반드시 Source DB 서버에 기동될 필요는 없다. Source DB에 network로 접속할 수 있고 replication 권한이 있는 위치라면 기동할 수 있다.

또한 ProSync는 현재 DBMS에 대한 반영만을 지원하고 있는데, 이 때문에 SQL로 데이터를 가져오거나 반영할 수 있는 Llob 프로세스나 Apply 프로세스 입장에서는 기동 위치에 큰 제약이 없다.

다만 변경분의 데이터에서 SQL로 데이터를 생성하고 TCP 소켓을 통해 반영 측에 전달하면 네트워크 쓰루풋 관점에서 크게 손해를 보기 때문에 가능하면 Apply는 반영하고자 하는 위치에, Llob 프로세스 또한 추출하고자 하는 위치에 기동시키는 것이 일반적이다.

Cluster의 경우 Llob 프로세스는 두 위치 중 아무 곳에나 기동되어도 된다.

Single to Single 구성 예시

아래와 같은 구성을 권장한다.
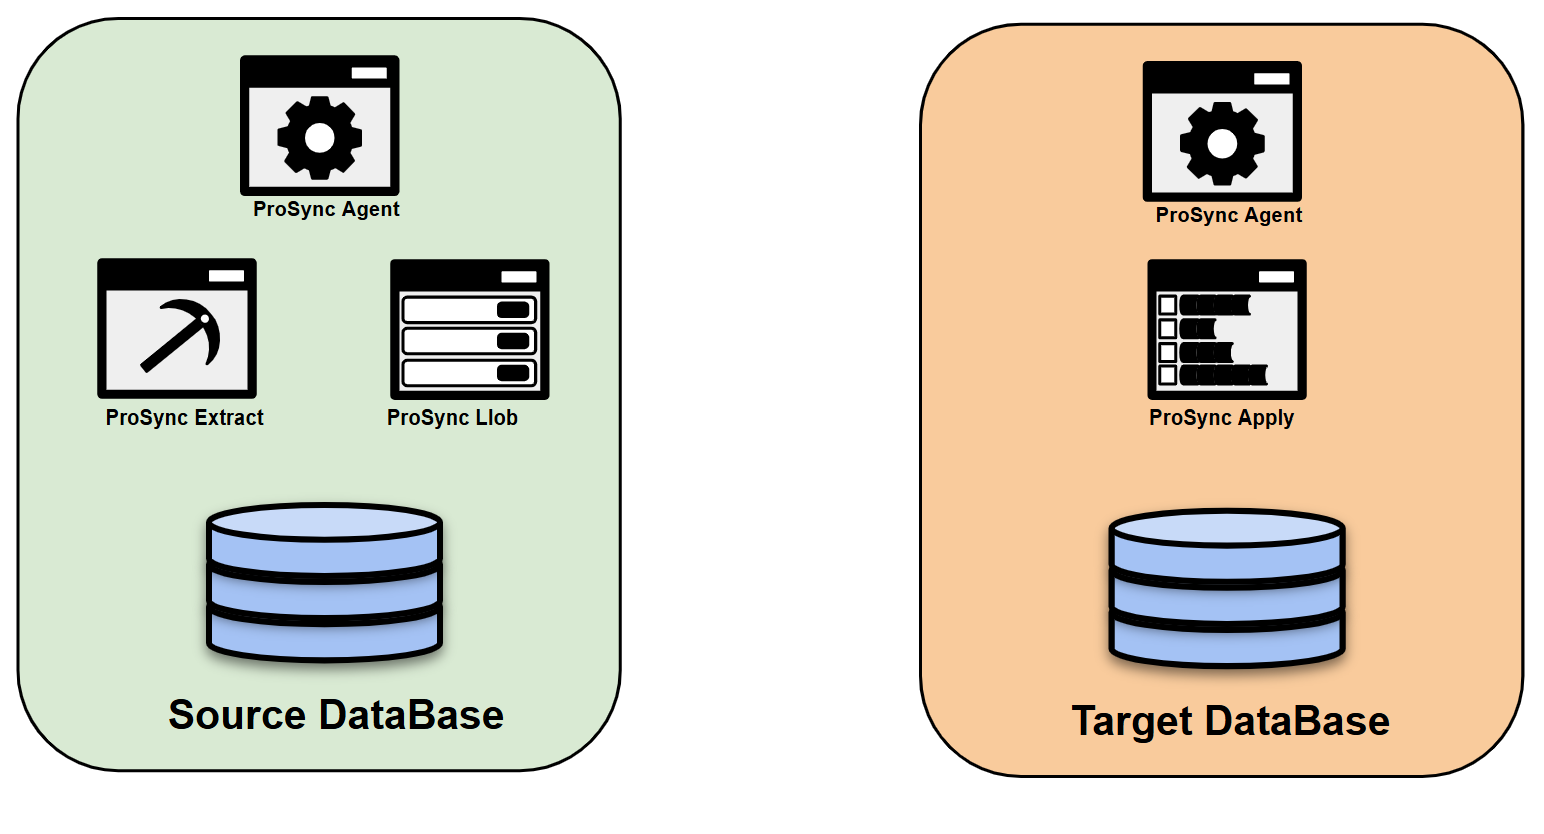
그림 1. Single to Single 1

가장 기본적인 ProSync의 구성도로, 추출하고자 하는 위치에 관련 프로세스가 기동되고, 반영하고자 하는 위치에 반영프로세스가 기동되는 구조이다. Agent 프로세스의 경우 프로세스들을 모니터링하기 때문에 환경별로 1개씩 기동된다.

편의를 위해 아래와 같은 구성 또한 가능하다.
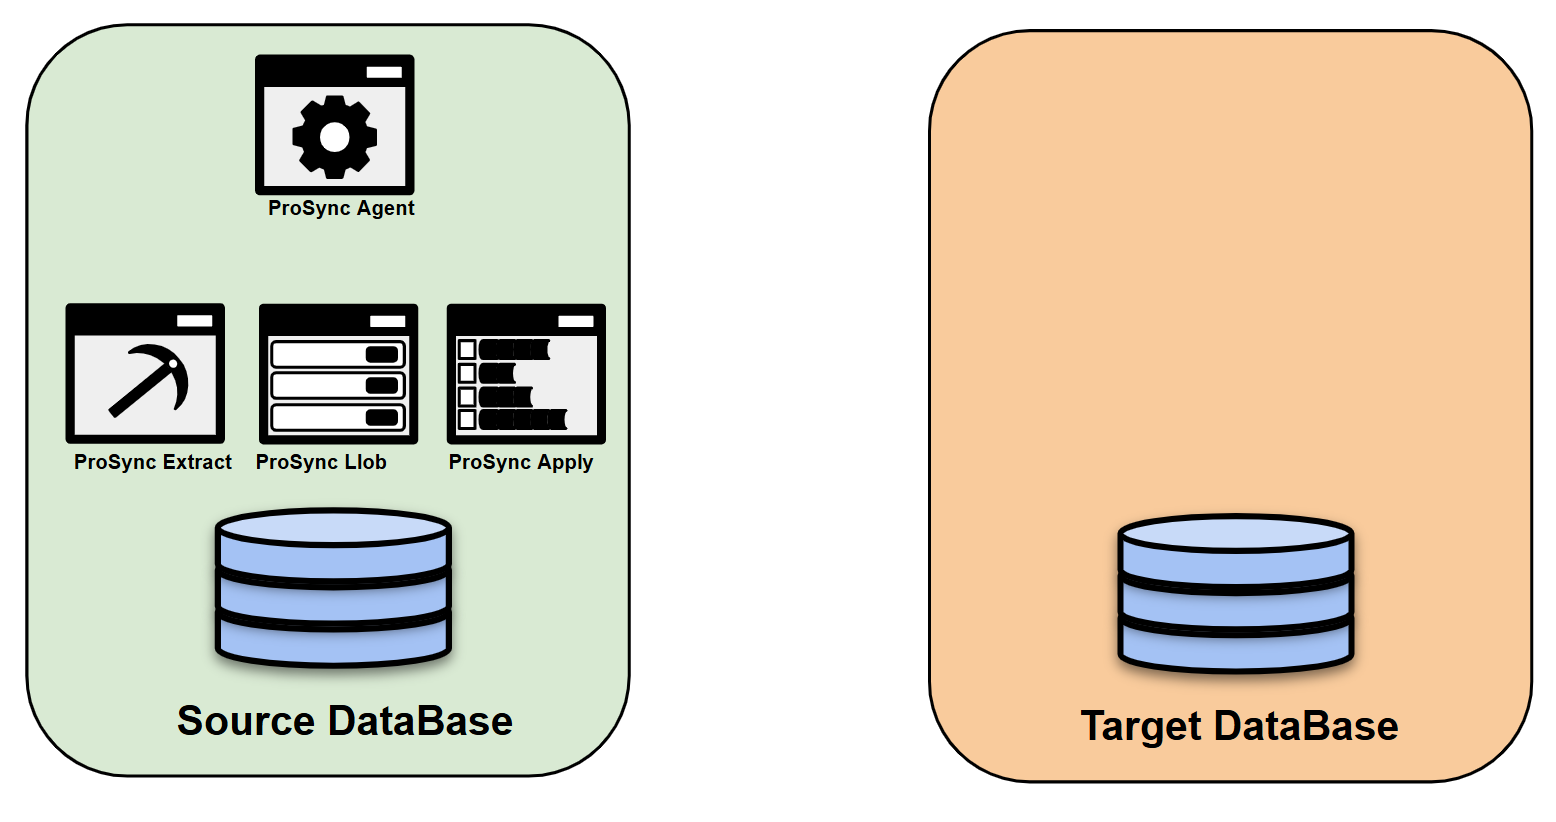
그림 2. Single to Single 2

모든 프로세스를 추출쪽으로 옮겨놓은 구성으로, 설치 및 운영이 매우 간단하다. 하지만 Apply가 Target쪽에 쿼리를 전달한다는 측면에서 네트워크 쓰루풋에 손해를 볼 수 있으며, 하드웨어 자원들도 모두 공유되기 때문에 권장되는 구성은 아니다.


Cluster to Single/Cluster 구성 예시

Active-Active 구성의 Cluster DB는 Shared Storage가 필수이기 때문에, Shared Storage와 DB Server를 분리하여 작성한다.
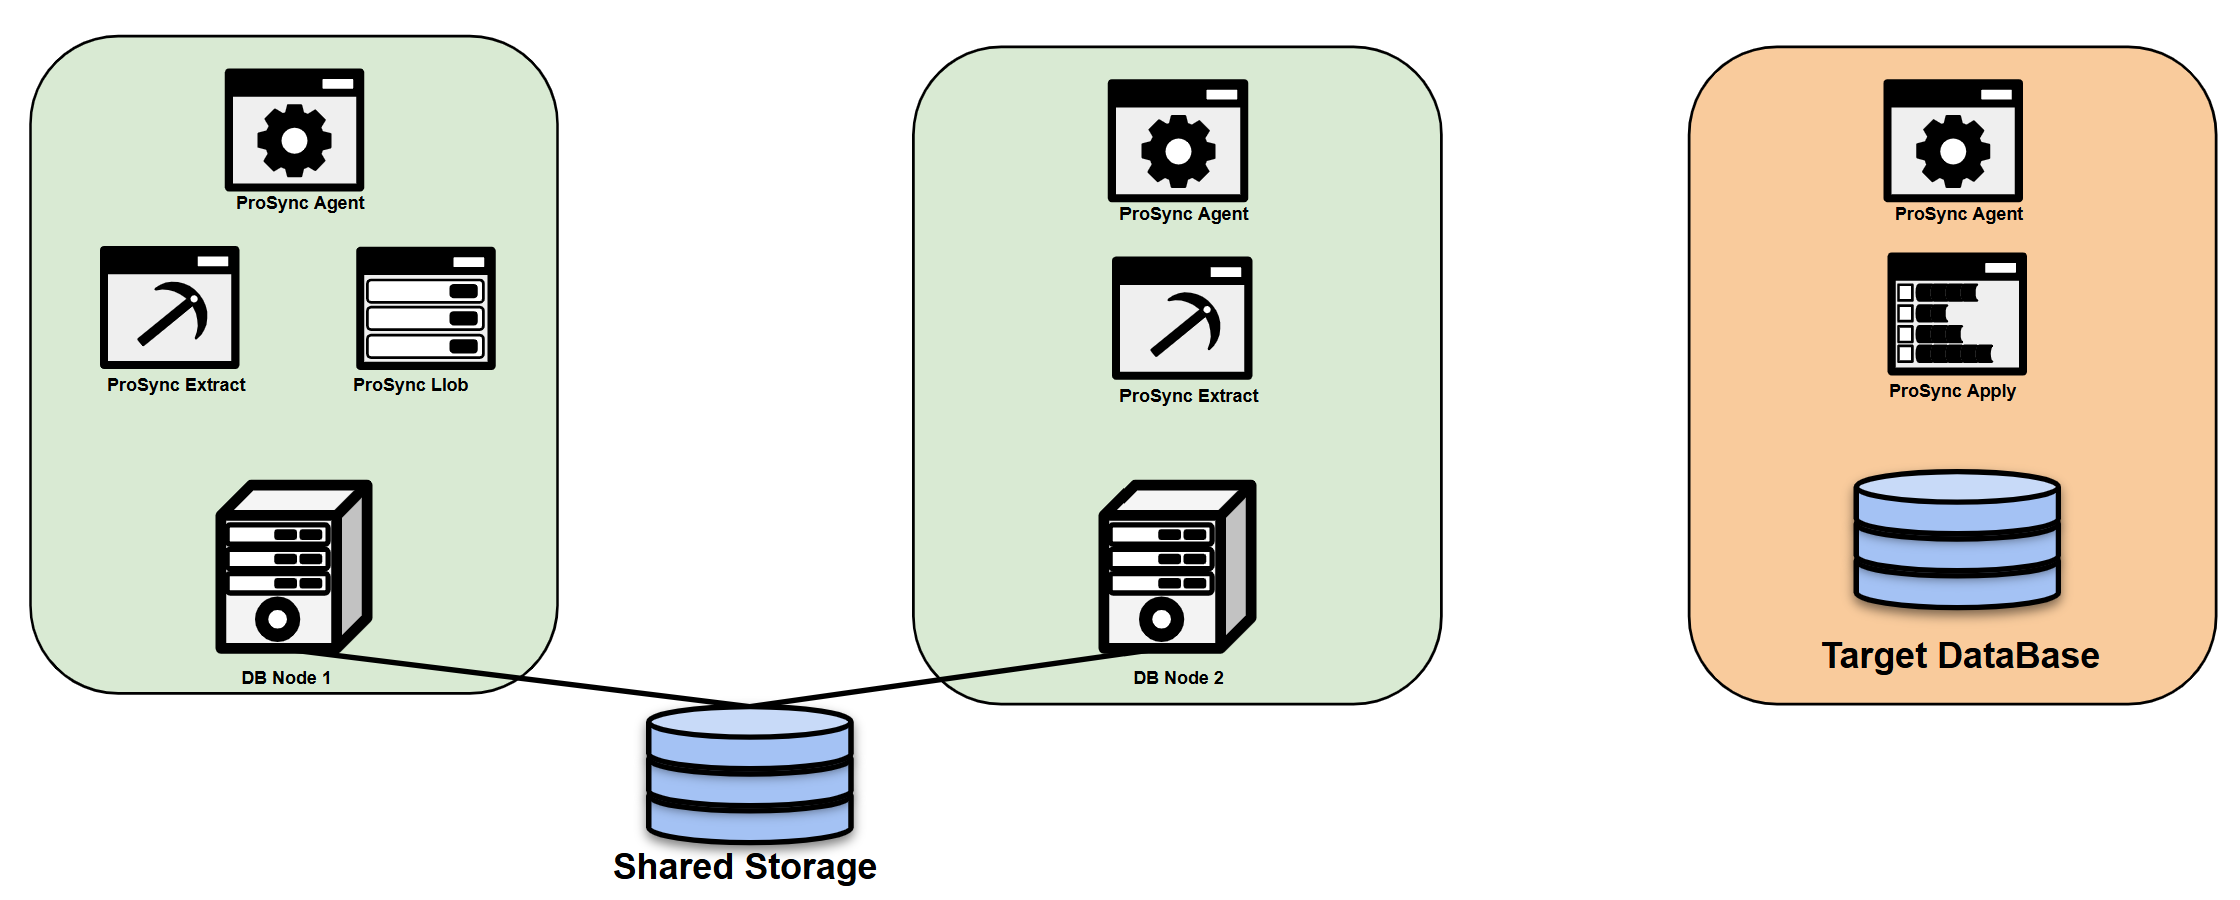
그림 3. Cluster 구성

반영 쪽이 Cluster인지 여부는 크게 중요하지 않다. 각 DB별 연결정보 파일 (tnsnames.ora 나 tbdns.tbr 파일 등)을 통해 Cluster 쪽 연결 정보를 추상화하여 접속하기 때문에 반영할 수 있는 DB와 연결만 되면 된다.

참고

Admin과 ProSync Manager

위 두 프로세스는 모니터링과 관련된 툴로 Agent와 연결만 된다면 어디에 기동되어도 무방하다.

마지막 업데이트